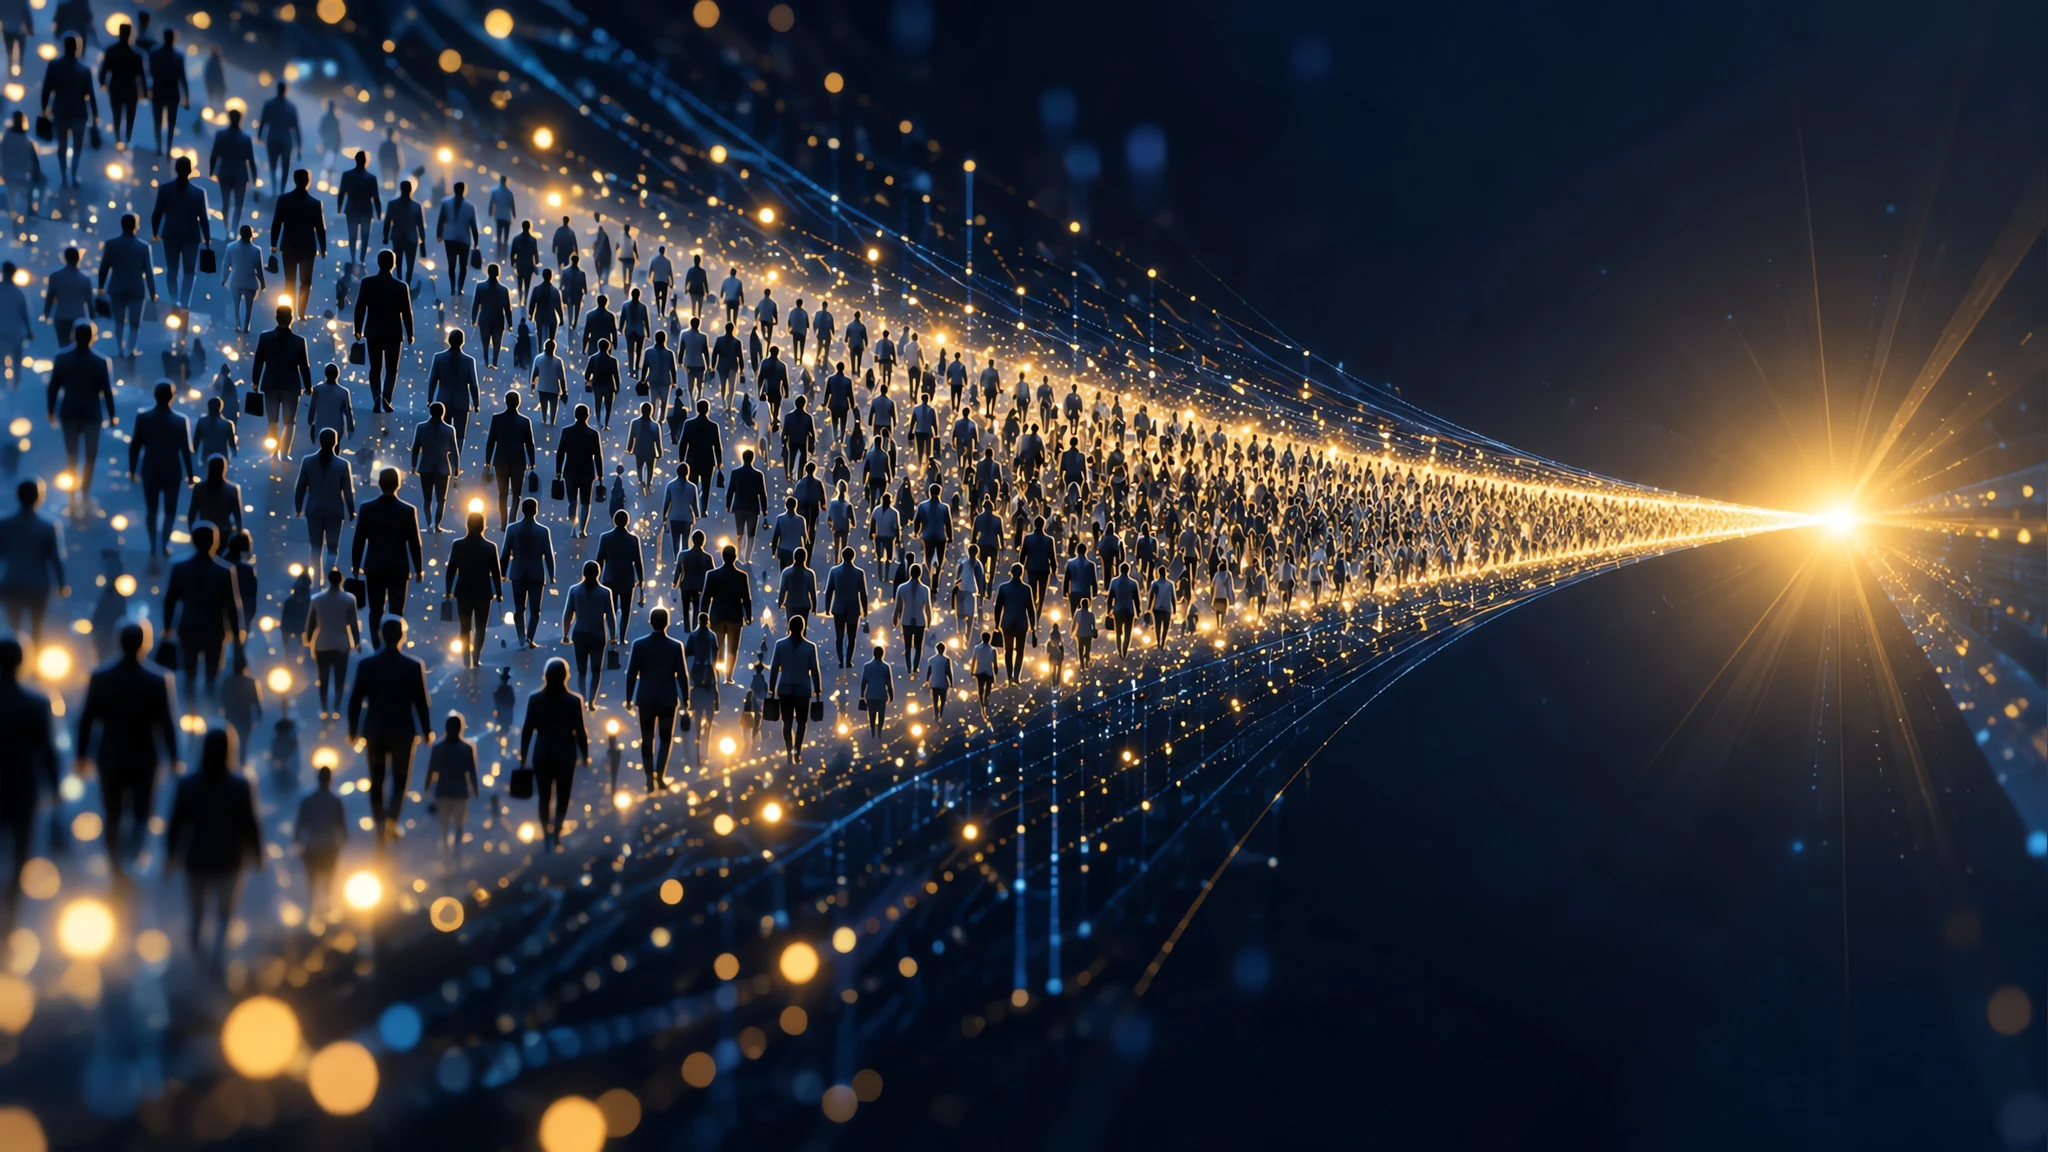
Andrej Karpathy sostiene que la brecha en cómo la gente entiende los modelos de IA ya no son dos grupos que hablan sin escucharse. Según su cálculo aproximado, hoy tiene forma de embudo, con miles de millones de personas rozando apenas la tecnología en su parte ancha.
Karpathy dice que la brecha de comprensión de los LLM se ensancha
Andrej Karpathy, miembro fundador de OpenAI y exdirector de IA en Tesla, publicó en X el 11 de octubre que la brecha en la comprensión compartida de lo que pueden hacer los grandes modelos de lenguaje se está ensanchando, no cerrando. Dijo que desempolvaba un mensaje de abril porque el problema había crecido desde entonces.
Su forma de decirlo fue directa. La división ya no son "dos grupos de personas que hablan sin entenderse", escribió. Ahora es un embudo afilado.
LLM significa gran modelo de lenguaje, el tipo de IA que hay detrás de herramientas como ChatGPT y Claude. El punto de Karpathy no va sobre los modelos en sí. Va sobre lo distinto que los experimenta la gente, desde quienes usan sistemas de frontera a diario hasta quienes nunca han escrito una instrucción a una IA.
El embudo: 6.000 millones de personas en la parte ancha
El cálculo de servilleta de Karpathy esboza la forma de esa brecha. Unos 6.000 millones de personas, cerca del 75% de la población mundial, apenas han tenido contacto con lo que pueden hacer los modelos actuales, estimó. Casi nadie, en otras palabras.
En la parte estrecha, sugiere que un grupo mucho más reducido tiene acceso directo a los sistemas más avanzados, y la cobertura temprana de su publicación situaba ese círculo interno en torno a las 5.000 personas que trabajan con modelos punteros dentro de empresas.
El centro, en su planteamiento, es más delgado de lo que uno supondría: gente que usa la IA de forma casual pero rara vez la lleva al límite. El embudo se estrecha rápido porque las herramientas que existen y las que la mayoría usa de verdad funcionan a niveles de capacidad muy distintos.
Por qué el argumento de Karpathy importa
Si Karpathy tiene razón, la mayoría de las conversaciones sobre IA ocurren entre personas que están en puntos distintos de ese embudo. Una describe lo que un modelo hace hoy de forma fiable. Otra solo ha visto una versión más antigua o más débil, o ninguna.
Ese desajuste condiciona desde los debates de política hasta las expectativas en el trabajo. Un jefe que da por hecho que la IA puede encargarse de una tarea porque una demo lo consiguió se apoya en la parte estrecha. Un trabajador que no ha visto esa demo se apoya en la parte ancha. Ninguno miente. Solo describen peldaños distintos de la misma escalera.
El planteamiento de Karpathy es una observación personal, no una estadística medida. Las cifras son sus propias estimaciones y no hay ningún conjunto de datos detrás. Pero la idea de que el acceso, y no la capacidad bruta, es la línea que divide es algo que mucha gente del sector lleva tiempo rondando.
¿Y si el problema no fuera lo que el modelo puede hacer, sino quién llega a probarlo?
Lo que está bien establecido
- Los modelos de frontera superan lo que la mayoría de usuarios casuales llega a probar
- El acceso a los sistemas más potentes es desigual entre empresas y regiones
- La percepción pública de la IA va por detrás de lo que logran los expertos
Lo que sigue siendo estimación de Karpathy
- Las cifras de "6.000 millones de personas" y "5.000 con acceso"
- La afirmación de que la brecha se ensancha en lugar de mantenerse
- Si la forma de embudo se sostiene en todas las regiones y sectores
Cómo reaccionó la comunidad
La publicación se extendió rápido. En Hacker News, un debate ligado a la idea de la brecha creciente reunió unos 198 puntos y 316 comentarios, según resúmenes del hilo. Varios profesionales y divulgadores lo compartieron, entre ellos Ethan Mollick, que estudia cómo usa la gente la IA en la práctica. La reacción no fue un acuerdo unánime. Buena parte del hilo discutía dónde queda el centro del embudo y si los usuarios corrientes están alcanzando el ritmo más rápido de lo que sugiere Karpathy. Ese tira y afloja es en sí mismo una señal de su tesis: hasta quienes prestan mucha atención discrepan sobre cómo aterriza la tecnología en manos comunes.
Qué conviene observar
La respuesta honesta es que nadie tiene una medición limpia de esta brecha. La aritmética de servilleta de Karpathy es una provocación, no un hallazgo.
Lo útil que cabe seguir es el acceso. Los modelos baratos no dejan de mejorar, y el suelo de lo que puede alcanzar un usuario medio sube con ellos. Si eso ensancha la parte estrecha del embudo o solo eleva todo el conjunto es la pregunta abierta que merece la pena mirar durante el próximo año.