
AgentQL
TinyFish · Programación
AgentQL es un lenguaje de consulta y un analizador de TinyFish que localiza elementos por su significado, así que tus scrapers y agentes siguen funcionando cuando cambia el HTML.
Acerca de AgentQL
About
Qué es AgentQL
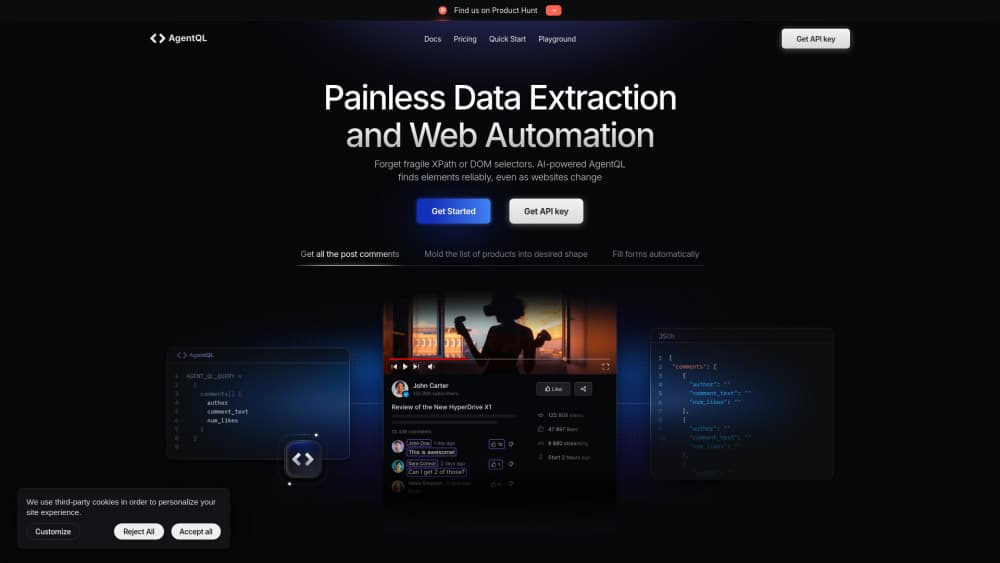
AgentQL nació para el scraping web con IA. Su lenguaje de consulta combina un analizador y una capa de IA para leer y controlar páginas web. En lugar de escribir XPath o selectores CSS, describes los campos que quieres en un lenguaje casi natural, algo como products[] { name price }, y el servicio devuelve JSON con esa forma. La IA interpreta el contexto de cada elemento, así que la consulta sigue encontrando el dato cuando un rediseño mueve el marcado.
El producto cubre dos frentes. Para scraping, query_data devuelve registros estructurados. Para automatización, query_elements y get_by_prompt entregan localizadores de Playwright listos para hacer clic, escribir o desplazar la página. TinyFish publica SDK para Python y JavaScript, un endpoint REST que prescinde del navegador, una extensión de Chrome para depurar consultas y un servidor MCP para frameworks de agentes.
Esa comodidad tiene un precio: dependes de un servicio alojado. Cada consulta pasa por la API de AgentQL con tu clave, el gasto crece por llamada después del tramo gratuito y necesitas conexión mientras se ejecuta el script. Las interfaces basadas en canvas, los diseños poco habituales y los sitios con defensas antibot agresivas todavía pueden fallar. Conviene revisar los resultados en producción.
Primeros pasos
- Crea una cuenta en agentql.com y copia una clave de API desde el portal para desarrolladores.
- Instala el SDK con
pip install agentqlonpm install agentql. - Escribe una consulta con los campos que necesitas y añade tipos como
price(integer)cuando el formato importe. - Llama a
query_datapara extraer datos o aquery_elementspara interactuar dentro de un script de Playwright. - Prueba la consulta en el playground o en la extensión del navegador antes de lanzarla a escala.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de AgentQL.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores de Python y JavaScript
- Equipos de datos y growth sin ingeniero de scraping
- Creadores de agentes de IA
Tareas
- Vigilar precios y catálogos
- Recopilar leads y directorios
- Rellenar formularios y cerrar compras
- Alimentar a un modelo de lenguaje con datos limpios
Casos de uso
- Un rediseño rompe tu scraper
- Una consulta para varios sitios parecidos
- Investigación en páginas con login
Funciones clave
Selectores semánticos
AgentQL encuentra elementos por su significado y por el contexto que los rodea, no por su posición en el DOM. Un campo llamado product_price localiza el precio aunque cambie el nombre de la clase o el bloque se mueva de sitio. Eso mantiene las consultas estables ante pruebas A/B y cambios graduales de diseño, y permite reutilizar la misma consulta en sitios construidos por equipos distintos.
El esquema sale de la consulta
La consulta funciona como contrato de salida. Anida objetos, marca listas con corchetes y añade indicaciones como price(integer) o product_price(include currency symbol) para controlar el formato. Obtienes JSON con la forma exacta que escribiste, así que la extracción de datos estructurados no necesita una fase de limpieza.
Integración con Playwright
Los SDK de Python y JavaScript envuelven páginas de Playwright y añaden los métodos query_data, query_elements y get_by_prompt. Conservas toda la API del navegador para navegar, capturar pantallas o subir archivos. Los localizadores que devuelve una consulta se comportan como los normales, así que tus ayudantes de test siguen sirviendo.
API REST sin navegador
Un endpoint REST devuelve los datos de una URL sin abrir un navegador. Encaja en tareas programadas y funciones serverless donde descargar Chromium no tiene sentido. Envías la URL y la consulta, y recibes los resultados en una sola petición.
Depurador en el navegador
Una extensión de Chrome abre un panel lateral en cualquier página: escribes la consulta y ves los elementos coincidentes resaltados al instante. Acorta el ciclo entre escribir un selector y saber si funciona, algo que se agradece en páginas desordenadas.
Servidor MCP
El servidor MCP de código abierto lleva la extracción de AgentQL a asistentes y entornos de agentes que hablan Model Context Protocol. Se instala con npx, añades una clave y el agente consulta una URL como si fuera una herramienta más. Sin código de pegamento.
Ventajas y desventajas
Ventajas
- Las consultas se leen como los datos que buscas, así que alguien nuevo puede editarlas sin dominar selectores.
- La coincidencia semántica reduce el mantenimiento que se come buena parte del presupuesto de scraping.
- El plan Starter gratuito incluye 50 llamadas al mes, suficiente para validar un caso antes de pagar.
- El soporte de Playwright cubre extracción e interacción en el mismo script.
- La API REST y el servidor MCP resuelven trabajos sin navegador y flujos con agentes.
Desventajas
- Las llamadas se cobran: $0.02 por llamada en Starter y $0.015 en Professional tras el volumen incluido, así que rastrear 100.000 páginas cuesta dinero real.
- Las horas de navegador remoto se facturan aparte, a $0.12 o $0.10 por hora, y las sesiones largas de automatización web salen más caras de lo que parece.
- Todo pasa por la API alojada: no hay modo offline y una caída del servicio detiene tu pipeline.
- La coincidencia con IA no es determinista: un diseño raro puede devolver campos parciales o desplazados, así que los trabajos en producción necesitan validación y reintentos.
Preguntas frecuentes
Cubre dos tareas: extraer datos de páginas web y controlar un navegador. Se usa para vigilar precios, recopilar leads, rellenar formularios y pasar datos limpios a agentes de IA.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con AgentQL.
Alternativas a AgentQL

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.