
Awan LLM
Awan LLM · Programación · Otro
Awan LLM es una API por suscripción para modelos Llama que cobra una cuota mensual fija en vez de cobrar por token, con un endpoint al estilo de OpenAI y planes desde gratis hasta 80 $/mes.
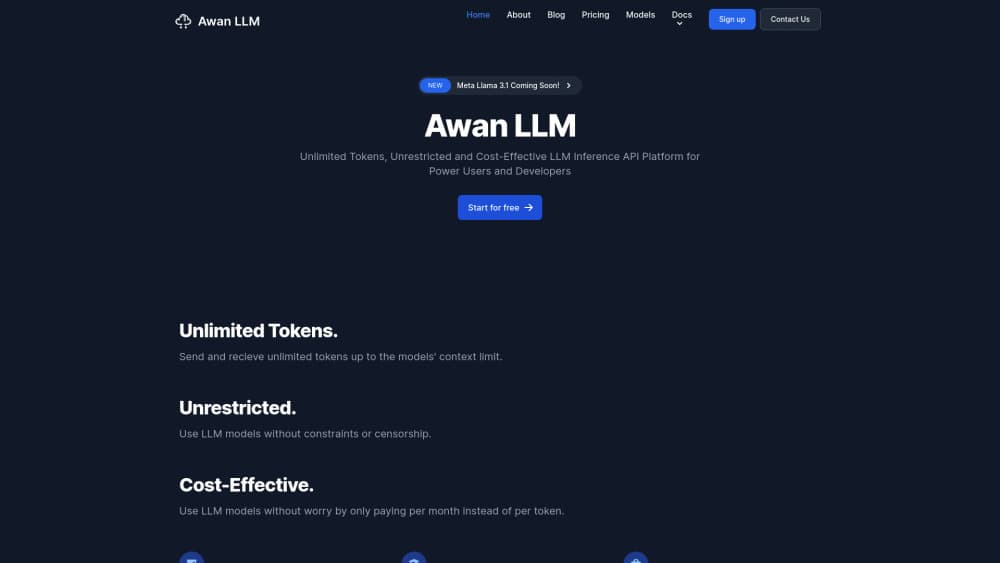
Acerca de Awan LLM
About
Qué es Awan LLM
Awan LLM es una API de inferencia que alquila acceso a modelos Llama abiertos por mes, no por token. Creas una cuenta, generas una clave y mandas peticiones a un endpoint de chat completions con la misma estructura que usa OpenAI. La factura no cambia tanto si envías mil tokens como si envías cien millones.
El hardware es de la empresa. Awan asegura que sus GPUs y sus centros de datos son propios, que los sube de vueltas y reparte la carga entre ellos, y de ahí sale la promesa de tokens ilimitados por entre 5 y 80 dólares al mes. El nombre viene del indonesio "nube", y el planteamiento apunta a quien ya no puede seguir pagando su consumo de tokens.
Hay dos límites que deciden si te sirve. El catálogo público es Llama 3 y Llama 3.1 en tamaños 8B y 70B, con ajustes finos de la comunidad, y no hay GPT, Claude, Gemini ni Mistral. Y las peticiones tienen tope por minuto y por día según el plan y el tamaño del modelo: tokens ilimitados no quiere decir peticiones ilimitadas.
Primeros pasos
- Abre una cuenta en awanllm.com y elige plan. Lite es gratis y no pide tarjeta, suficiente para comprobar si el endpoint responde como espera tu código.
- Genera una clave de API en el panel y guárdala donde tu aplicación pueda leerla.
- Lanza la primera petición a https://api.awanllm.com/v1/chat/completions con el nombre del modelo y el array de mensajes, usando el ejemplo en Python, TypeScript o shell de la página Quick Start.
- Vigila los límites. Si agotas el cupo diario de modelos grandes, mueve el trabajo a un modelo menor o espera a que el contador se reinicie.
- Sube de plan cuando te aprieten las peticiones, no cuando te aprieten los tokens.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Awan LLM.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Aficionados que mantienen conversaciones largas con un asistente
- Desarrolladores independientes con presupuesto corto
- Guionistas y jugadores de rol que buscan modelos ajustados
- Equipos que procesan mucho texto con coste fijo
Tareas
- Procesamiento masivo de texto
- Redacción de documentos largos
- Backends de chatbots y agentes
- Escritura creativa sin censura
Casos de uso
- Un proyecto personal que de pronto recibe visitas
- Probar una biblioteca de prompts
- Herramientas de desarrollo contra un modelo remoto
Funciones clave
Tokens ilimitados con cuota mensual fija
Todos los planes, incluido el gratuito, prometen generación de tokens sin límite hasta el contexto de cada modelo. Pagas el plan, no las entradas ni las salidas, de modo que un prompt largo o una respuesta larga no suman nada extra. La tarifa mensual fija LLM es la que sostiene ese trato: la economía se invierte. cuanto más usas la API, mejor sale la cuenta, y un mes de mucho trabajo no trae sorpresas en el recibo.
Chat completions al estilo de OpenAI
Funciona como una API compatible con OpenAI: las peticiones van a https://api.awanllm.com/v1/chat/completions con los mismos campos model y messages, más controles de muestreo como top_k y repetition_penalty. En la página Quick Start hay ejemplos en Python, TypeScript y shell, así que casi cualquier SDK de OpenAI funciona en cuanto cambias la URL base y la clave. También hay streaming, algo que se nota en interfaces de chat donde esperar la respuesta completa parece que se ha roto.
Límites por tamaño de modelo
En lugar de una cuota única, Awan separa los límites en clases de modelo pequeño, mediano y grande, y da a cada plan un cupo por minuto y otro por día. Lite permite 200 peticiones diarias a modelos pequeños y 10 a los grandes; Pro sube a 80.000 y 30.000; Max quita el tope diario y añade peticiones en paralelo. El techo por minuto va de 20 en los planes baratos a 200 en Max.
Llama 3.1 con contexto largo
Los modelos destacados de la API de Llama 3.1 ahora son Meta-Llama-3.1-8B-Instruct y Meta-Llama-3.1-70B-Instruct, ambos con una ventana de 131.072 tokens. El 70B asume el razonamiento y la escritura más difíciles, mientras los 8B responden antes y gastan menos cupo de peticiones. Awan publica una velocidad estimada por modelo: unos 50 tokens por segundo en peticiones sueltas con el 8B y 20 con el 70B.
Ajustes finos de la comunidad para ficción
Más allá de los pesos originales de Meta, el catálogo incluye variantes propias sobre Llama 3 8B. Dolfin sigue instrucciones al pie de la letra con menos negativas, Cumulus está pensado para narrativa y rol sin rechazos, y junto a ellos hay una versión abliterated de Instruct. Son herramientas de nicho, pero en ficción y personajes se comportan muy distinto a un asistente filtrado: son los modelos Llama sin censura de la casa.
Sin registro de prompts
Awan declara en su política de privacidad que no guarda prompts ni generaciones, y repite la promesa en la portada. Para quien manda material de clientes, borradores sin publicar o conversaciones personales por una API, esa política suele decidir la compra. Tómalo como una declaración de la empresa y no como una garantía auditada: si trabajas con datos regulados, revisa el contrato por tu cuenta.
Ventajas y desventajas
Ventajas
- Los tokens ilimitados sacan el conteo de tokens del código y del presupuesto.
- El plan Lite gratuito es un nivel real, no una prueba, y no pide método de pago.
- Las peticiones siguen el formato de chat de OpenAI, así que los SDK y frameworks de agentes entran cambiando la URL base.
- Los 131.072 tokens de contexto en Llama 3.1 resuelven documentos largos en una sola petición.
- El plan más caro son 80 $ al mes, poco para quien mueve volumen de verdad.
Desventajas
- El catálogo es solo Llama, y las versiones publicadas son Llama 3 y 3.1: aquí no llegas a GPT, Claude, Gemini ni a Llama más recientes.
- Los tokens ilimitados chocan con topes diarios de peticiones en todos los planes por debajo de Max, así que la pared es el caudal y no el token.
- Solo se paga con PayPal, lo que deja fuera algunas tarjetas y cuentas de empresa.
- El soporte es una dirección de correo, sin página de estado, SLA ni historial público de disponibilidad antes del plan Enterprise.
Preguntas frecuentes
Awan LLM es un proveedor de API que sirve modelos Llama abiertos con una suscripción mensual en lugar de cobro por token. Pagas un plan, mandas peticiones de chat completion a su endpoint y generas todos los tokens que permita el contexto del modelo dentro de tus límites de peticiones.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Awan LLM.
Alternativas a Awan LLM

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.