
Bright Data
Bright Data · Programación
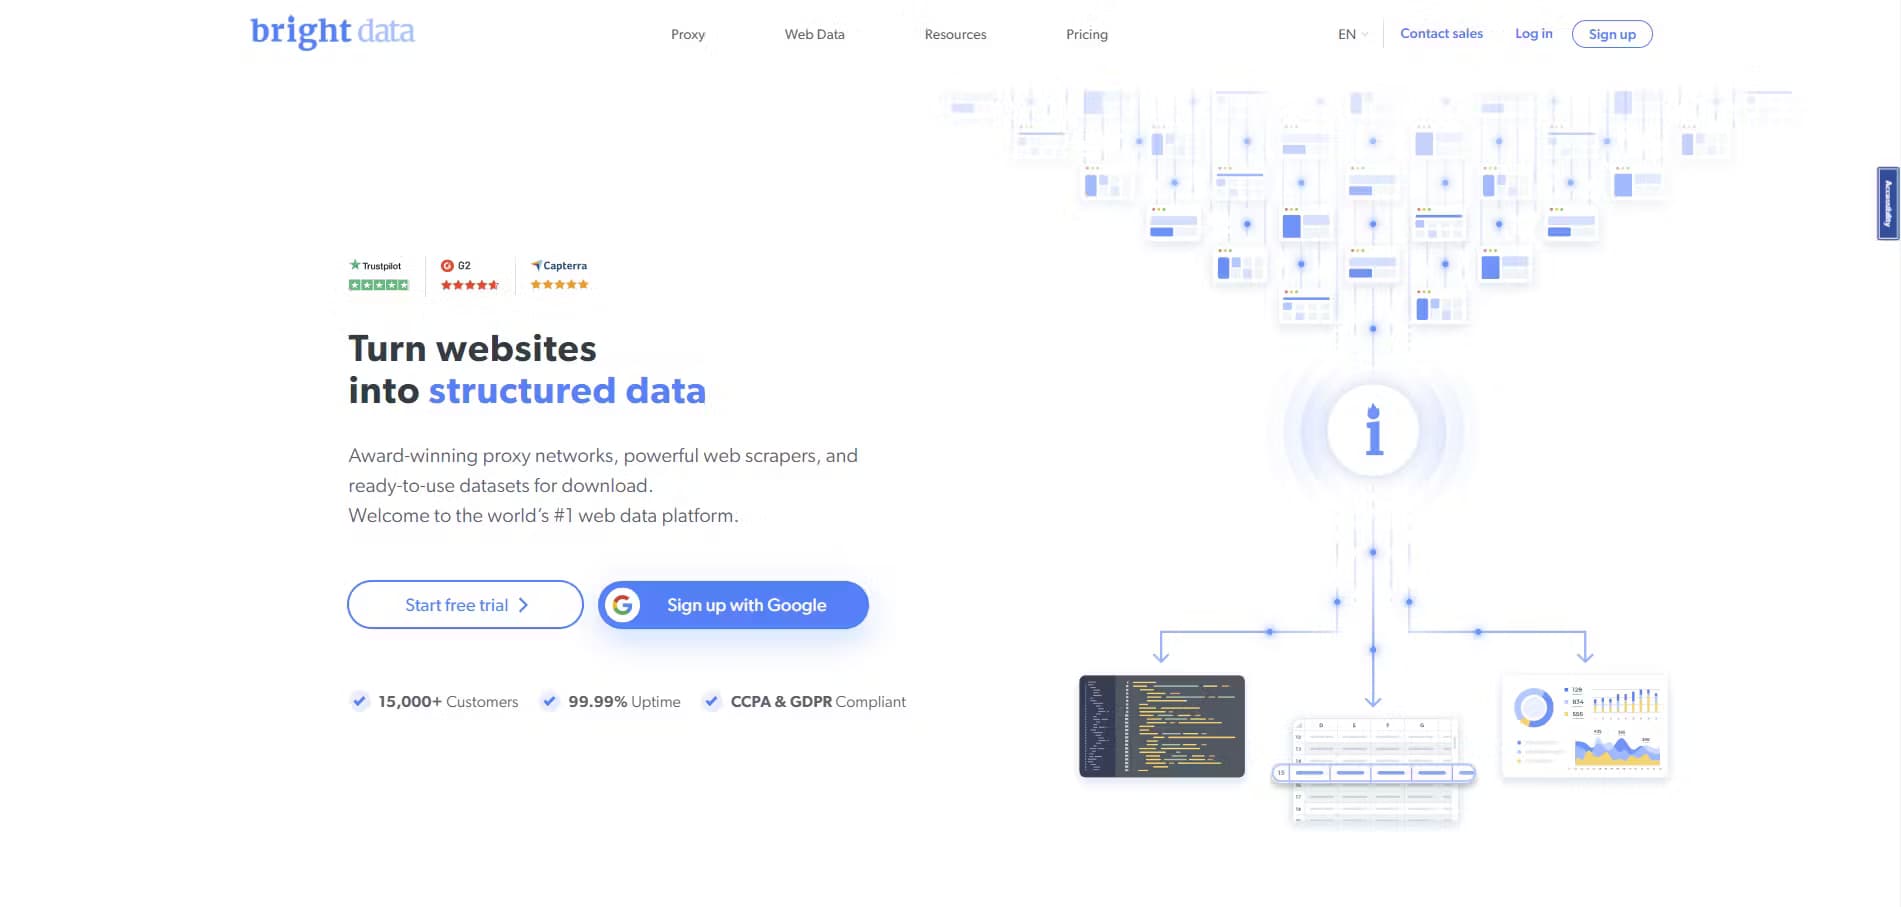
Bright Data es una plataforma de datos web. Da a los equipos proxys, scrapers y datasets listos para recoger datos públicos de la web a escala.
Acerca de Bright Data
Qué es Bright Data
Bright Data es una plataforma de datos web pensada para empresas que necesitan extraer información pública de internet sin que las bloqueen. Reúne una red de proxys, herramientas de scraping y datasets ya construidos en una sola cuenta. La empresa afirma que atiende a más de 50.000 organizaciones. Ese rango va desde desarrolladores que trabajan solos hasta grandes corporaciones.
El problema de fondo que resuelve es el acceso. Las webs bloquean bots con bans de IP, CAPTCHAs y huellas digitales. Construir algo alrededor de esas defensas es lento y pesado. Bright Data se encarga de esa capa por ti. Tu equipo dedica el tiempo a los datos, no a la fontanería.
No es una herramienta barata. El precio por uso de los proxys arranca en unos 4 dólares por GB, y los planes más cargados llegan a cientos o miles de dólares al mes. Si solo necesitas unos cientos de registros una vez, hay opciones más económicas. Bright Data tiene sentido cuando el volumen, la fiabilidad y la cobertura geográfica importan más que el precio más bajo. Así de simple.
Cómo empezar
- Crea una cuenta en el sitio de Bright Data y verifica tu correo; no hace falta tarjeta de crédito para empezar.
- Elige el producto que necesitas, como una red de proxys, la API Web Scraper o un dataset ya hecho.
- Saca tus credenciales del panel y conéctate por la API, un SDK o un scraper sin código.
- Lanza una tarea de prueba pequeña para confirmar que tus peticiones devuelven los datos que esperas.
- Escala y fija límites de gasto para que tu uso no se salga del presupuesto.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Bright Data.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de datos
- Analistas de comercio electrónico
- Equipos de IA y ML
- Equipos de crecimiento y marketing
Tareas
- Recoger precios y disponibilidad de productos en webs minoristas a escala.
- Hacer scraping de resultados de buscadores para SEO y seguimiento de marca.
- Construir datasets de entrenamiento a partir de páginas web públicas para modelos de lenguaje.
- Reunir datos de redes sociales y reseñas para análisis de sentimiento.
- Automatizar feeds de datos recurrentes con webhooks en lugar de exportaciones manuales.
Casos de uso
- Mantener un pipeline diario de seguimiento de precios entre varias tiendas.
- Investigar un mercado nuevo sin montar un stack de scraping desde cero.
- Alimentar un panel interno o una herramienta de BI con datos públicos frescos.
- Probar una idea de scraper en el plan gratuito antes de comprometer presupuesto.
Funciones clave
Redes de proxys
Bright Data opera una de las mayores redes de proxys, con más de 400 millones de IPs residenciales en 195 países. Puedes dirigir por país, estado, ciudad o código postal sin coste extra. Hay proxys residenciales, ISP, de centro de datos y móviles. Elige el tipo que encaje con la web que vas a atacar.
API Web Scraper
Los scrapers ya construidos cubren dominios importantes como LinkedIn, Amazon e Instagram. Pagas solo por los registros que vuelven con éxito. Un plan gratuito te da 5.000 registros al mes para probar. El parseo a JSON o CSV va incluido, así te ahorras escribir tu propio código de extracción.
Web Unlocker
Esta es la pieza que sortea los bloqueos. Rota IPs, resuelve CAPTCHAs y gestiona cabeceras, user agents y cookies de forma automática. Para los equipos que chocan una y otra vez con webs protegidas, quita la parte más tediosa del scraping. No es magia. Aun así, cubre las defensas habituales.
Scraping Browser
Tienes navegadores remotos que puedes manejar con Puppeteer o Playwright, con el desbloqueo ya integrado. Si tu flujo ya usa esas herramientas, puedes apuntarlas a Bright Data y saltarte el montaje de infraestructura. Viene bien para páginas muy cargadas de JavaScript.
Datasets ya hechos
En vez de hacer scraping desde cero, puedes comprar datasets que cubren más de 800 dominios, actualizados con regularidad y entregados por API o webhook. Hay más de 5.000 millones de registros disponibles. Le sirve a equipos que quieren los datos ya y no les importa cómo se recogieron.
API SERP
Puedes extraer resultados de búsqueda en vivo de varios motores en JSON o HTML. Es útil para seguimiento de posiciones, investigación de anuncios y entender qué ve la gente en el buscador. No hace falta automatizar navegador por tu parte. Cero configuración en el lado del navegador.
AI Scraper Studio
Esto te deja convertir una web en un pipeline de datos con construcción de scrapers asistida por IA. No tienes que programar selectores a mano para cada sitio. Va dirigido a equipos que hacen scraping de muchas webs distintas y quieren recortar el tiempo de montaje de cada una. Un gran ahorro de tiempo.
Ventajas y desventajas
Ventajas
- Red de proxys con más de 400 millones de IPs y segmentación geográfica fina hasta el código postal.
- Pagas solo por los registros entregados con éxito en la API Web Scraper, así las peticiones fallidas no te cuestan.
- Plan gratuito con 5.000 registros al mes y sin tarjeta, bueno para probar antes de comprometerte.
- Los datasets ya hechos y el constructor de scrapers con IA recortan el trabajo de ingeniería para objetivos comunes.
- Una línea amplia de herramientas cubre proxys, scraping, desbloqueo y entrega en un solo lugar.
Desventajas
- El precio sube rápido; el ancho de banda de proxys a 4-8 dólares por GB es caro para trabajos de mucho volumen.
- La profundidad de opciones puede abrumar a principiantes que solo quieren un scraper sencillo.
- La previsibilidad del coste es complicada, porque el ancho de banda y el uso de registros varían según las webs objetivo.
- Parte de la responsabilidad legal y de cumplimiento sigue recayendo en ti, no en la plataforma.
Preguntas frecuentes
Bright Data se usa para recoger datos públicos de la web a escala, sobre todo para seguimiento de precios, datos de búsqueda, investigación de mercado y construcción de datasets para modelos de IA. Ofrece los proxys, los scrapers y las herramientas de entrega para que no tengas que montar esa infraestructura tú mismo.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Bright Data.
Alternativas a Bright Data

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.