
Cerebrium
Cerebrium · Programación
Cerebrium es una plataforma de GPU sin servidor para ejecutar apps de IA en tiempo real en la nube. Cobra el cómputo por segundo y despliega en varias regiones.
Acerca de Cerebrium
What Is Cerebrium
Cerebrium es infraestructura para cargas de IA que tienen que responder rápido. Empaquetas código Python en un contenedor, lo despliegas, y Cerebrium lo convierte en un endpoint que escala solo. La plataforma ejecuta CPUs y GPU de NVIDIA, y apunta a trabajos donde el arranque en frío y la latencia deciden si un producto funciona: agentes de voz, salida de modelos en streaming e inferencia con mucho tráfico.
La velocidad viene de dos cosas. Los contenedores arrancan en uno a tres segundos, y un sistema llamado Content-Aware Storage descarga solo los archivos que necesita una instancia nueva en lugar de toda la imagen. Para trabajos más pesados, el checkpointing de memoria y GPU guarda una instantánea del proceso, así el modelo se salta las importaciones y la compilación CUDA en el siguiente arranque. Cerebrium dice que el checkpointing recorta el arranque en frío, y la función sigue en beta.
El precio va por uso, no por asientos. Pagas por segundo las vCPU, la memoria y las GPU que ocupa una carga mientras corre, así la facturación por segundo ata el gasto al trabajo real. El plan Hobby es gratis para empezar y cobra el cómputo aparte; Standard suma 100 dólares al mes más cómputo para asientos y apps ilimitados. Los equipos que necesitan capacidad reservada, descuentos por volumen o ayuda de ingeniería de ML pasan a Enterprise. El cómputo corre en Google Cloud, AWS y Azure, y Cerebrium enruta el trabajo al que mejor le venga.
Getting Started
- Instala la CLI con pip install cerebrium, o usa Homebrew en macOS y un paquete binario en Linux.
- Ejecuta cerebrium login y abre el panel para crear una API key y ver el ID de tu proyecto.
- Ejecuta cerebrium init my-first-app para crear un proyecto con main.py y cerebrium.toml.
- Prueba el código con cerebrium run main.py::run y publícalo con cerebrium deploy.
- Llama al endpoint desplegado en su URL de api.cerebrium.ai, o configura un dominio propio.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Cerebrium.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de IA que publican APIs de inferencia
- Equipos con tráfico irregular
- Creadores de apps de voz y streaming
- Empresas con reglas de residencia de datos
Tareas
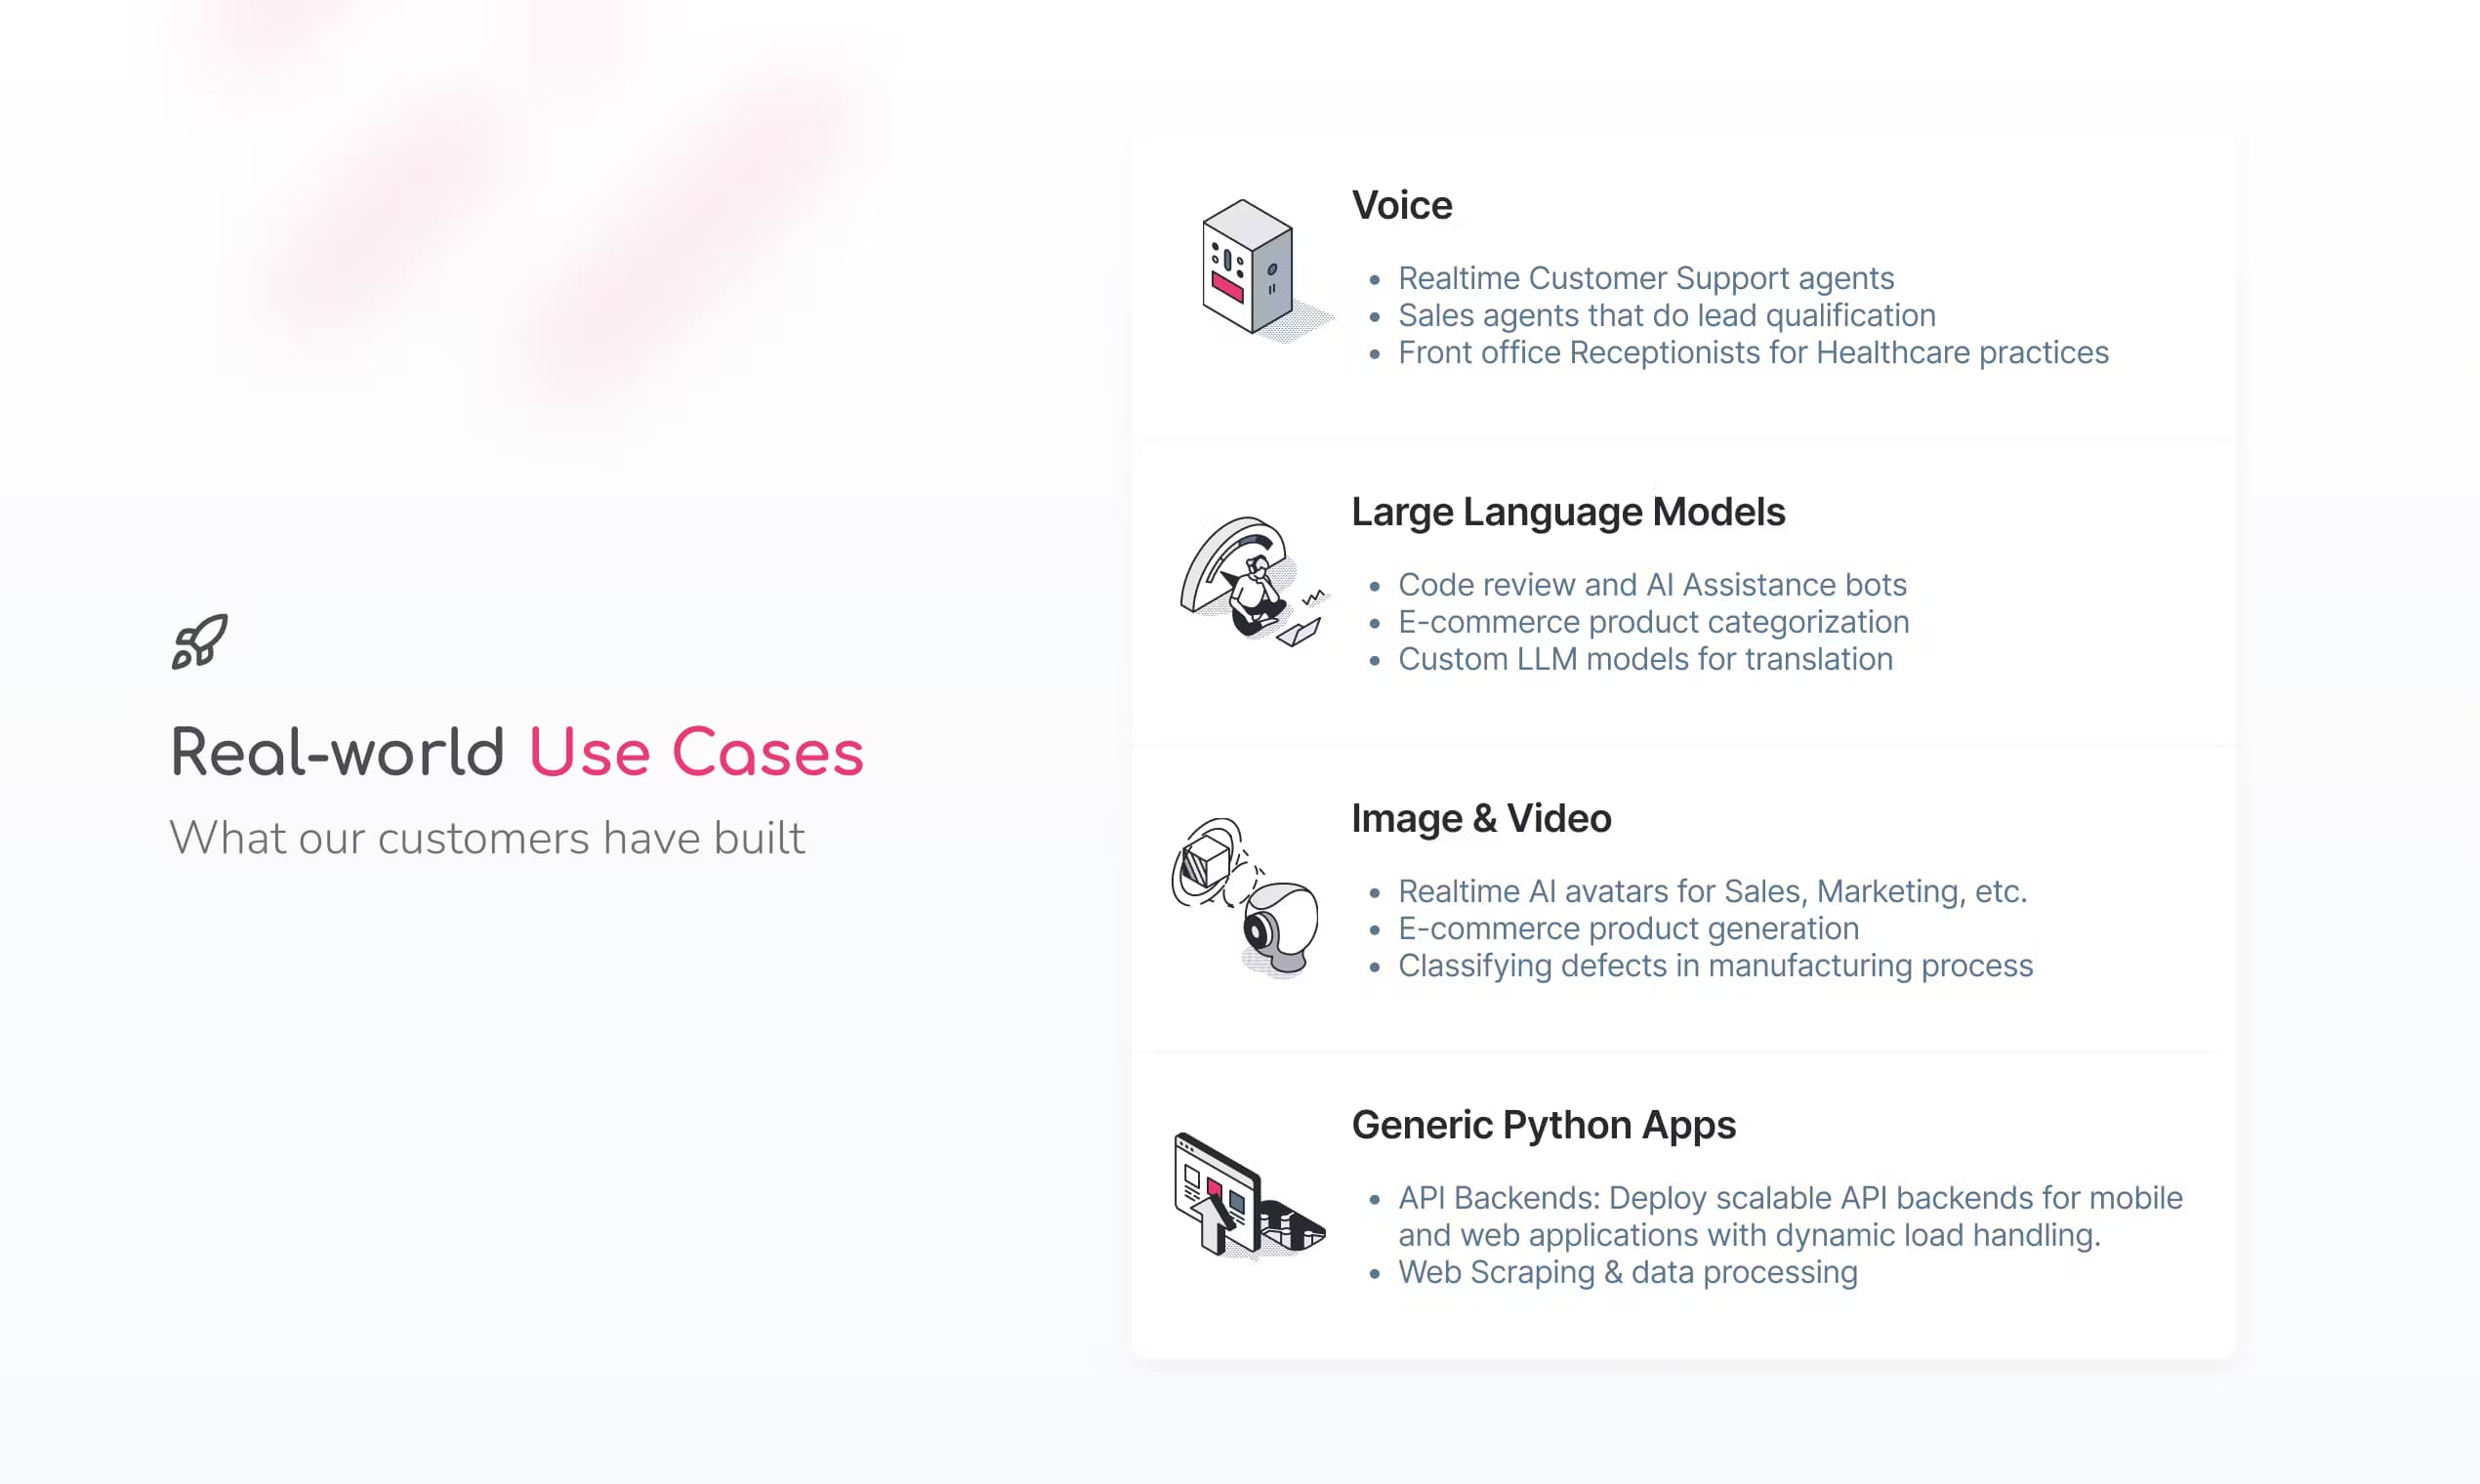
- Servir modelos abiertos
- Generar imágenes y vídeo
- Transcribir audio largo
- Construir agentes de voz en tiempo real
- Ejecutar embeddings y reranking
Casos de uso
- Un bot de soporte telefónico que responde mientras la persona sigue hablando
- Un pico de tráfico el día del lanzamiento
- Un lote nocturno de transcripciones
- Una app global con usuarios en varias regiones
Funciones clave
Arranque de contenedores en menos de un segundo
Cerebrium lanza contenedores en uno a tres segundos, combinando Content-Aware Storage, que descarga solo los archivos necesarios, con el checkpointing de memoria y GPU que salta importaciones, carga de modelos y compilación CUDA. El arranque rápido importa sobre todo en apps en tiempo real, donde una primera petición lenta se lee como un producto roto.
GPU y CPU sin servidor
Configuras el tipo y número de GPU, los núcleos de vCPU y la memoria en cerebrium.toml, eligiendo tarjetas NVIDIA como H100, A100 y L40s. Las instancias escalan con el tráfico, así una hora tranquila cuesta poco y una cargada no se descontrola. Pagas por segundo solo los recursos que asignas.
Despliegue multirregión
Un mismo despliegue puede correr en varias regiones para bajar la latencia y subir la disponibilidad, o quedarse fijo en una por residencia de datos. Cerebrium corre en Google Cloud, AWS y Azure, y declara un 99,999 por ciento de disponibilidad con failover que redirige el tráfico cuando cae una región.
Tipos de endpoint flexibles
Las apps pueden servir una API REST, un endpoint de streaming por server-sent events, un WebSocket para audio bidireccional, o cualquier servidor web compatible con ASGI. Ese abanico deja que una sola plataforma aloje tanto una llamada JSON simple como una sesión de voz en vivo.
Escalado automático y batching
Configuras réplicas, métricas de escalado y niveles de cómputo, y luego ajustas concurrencia y batching para el tráfico real. El batching nativo con vLLM o LitServe sube el rendimiento de la GPU, lo que baja el coste de cada petición bajo carga.
Almacenamiento persistente
Los volúmenes guardan pesos de modelo y archivos entre despliegues, con comandos de subida, descarga y listado en la CLI, y redimensionado por proyecto hasta 1TB. Los pesos persisten entre lanzamientos, así los contenedores no los vuelven a descargar en cada arranque.
Seguridad y aislamiento
Cada carga corre sobre gVisor en un entorno reforzado, lo que da un aislamiento de contenedor fuerte sin gran coste de rendimiento. La plataforma cumple SOC 2, HIPAA, GDPR e ISO, y los secretos van cifrados y expuestos como variables de entorno.
CI/CD e integración con GitHub
Las apps se pueden enlazar a un repositorio de GitHub para que un push o un merge disparen un despliegue, usando claves de cuenta de servicio en un pipeline. Los ajustes de despliegue gradual mueven el tráfico entre revisiones en una ventana fija, lo que rebaja el riesgo de una mala versión en producción.
Ventajas y desventajas
Ventajas
- Las primeras peticiones llegan en uno a tres segundos, así las apps de voz y en tiempo real no se atascan al arrancar.
- La facturación por segundo sobre GPU, CPU y memoria mantiene el coste atado al trabajo real, y hace asequible la infraestructura de inferencia de IA.
- Un plan Hobby gratis y un Standard de 100 dólares facilitan probar y correr apps pequeñas.
- El despliegue multirregión y el cumplimiento normativo encajan con equipos globales o con datos regulados.
- El soporte de REST, streaming, WebSockets y servidores Docker o ASGI propios encaja con muchas pilas.
Desventajas
- El checkpointing de memoria y GPU sigue en beta, así que las mayores mejoras de arranque aún no están cerradas.
- La página de precios no lista tarifas fijas por GPU, así que calculas el coste con una estimadora o pides presupuesto.
- No puedes usar créditos de AWS ni de GCP, algo que sorprende a equipos ya comprometidos con esas nubes.
- La capacidad garantizada de GPU exige un gasto mínimo mensual, lo que la descarta para proyectos pequeños.
Preguntas frecuentes
Cerebrium es una plataforma de GPU sin servidor para cargas de IA en tiempo real y de alto rendimiento. Despliegas un contenedor y se convierte en un endpoint que escala y corre en CPU o GPU de NVIDIA, con facturación por segundo.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Cerebrium.
Alternativas a Cerebrium

Udon
Udon · Programación · ProductividadUdon convierte un Mac con Apple Silicon en un servidor doméstico que se gestiona desde el navegador, con contenedores, archivos compartidos y un administrador de sistemas con IA opcional.

offstage
offstage cloud · Programación · Productividadoffstage da a los agentes de IA y a los trabajos de CI un Mac de verdad: una cuenta de macOS 27 sobre Apple silicon, manejada por API y cobrada por segundo.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programación · ProductividadBotBus te deja controlar desde el móvil y el reloj los agentes de programación con IA que corren en tu ordenador: apruebas comandos, lanzas tareas y lees resultados sin volver al escritorio.