
extract by Firecrawl
Firecrawl · Programación
extract by Firecrawl es el endpoint de la API de Firecrawl que convierte cualquier URL o un dominio entero en JSON estructurado. Le das enlaces más un prompt o un esquema, y devuelve los campos que pediste.
Acerca de extract by Firecrawl
What Is extract by Firecrawl
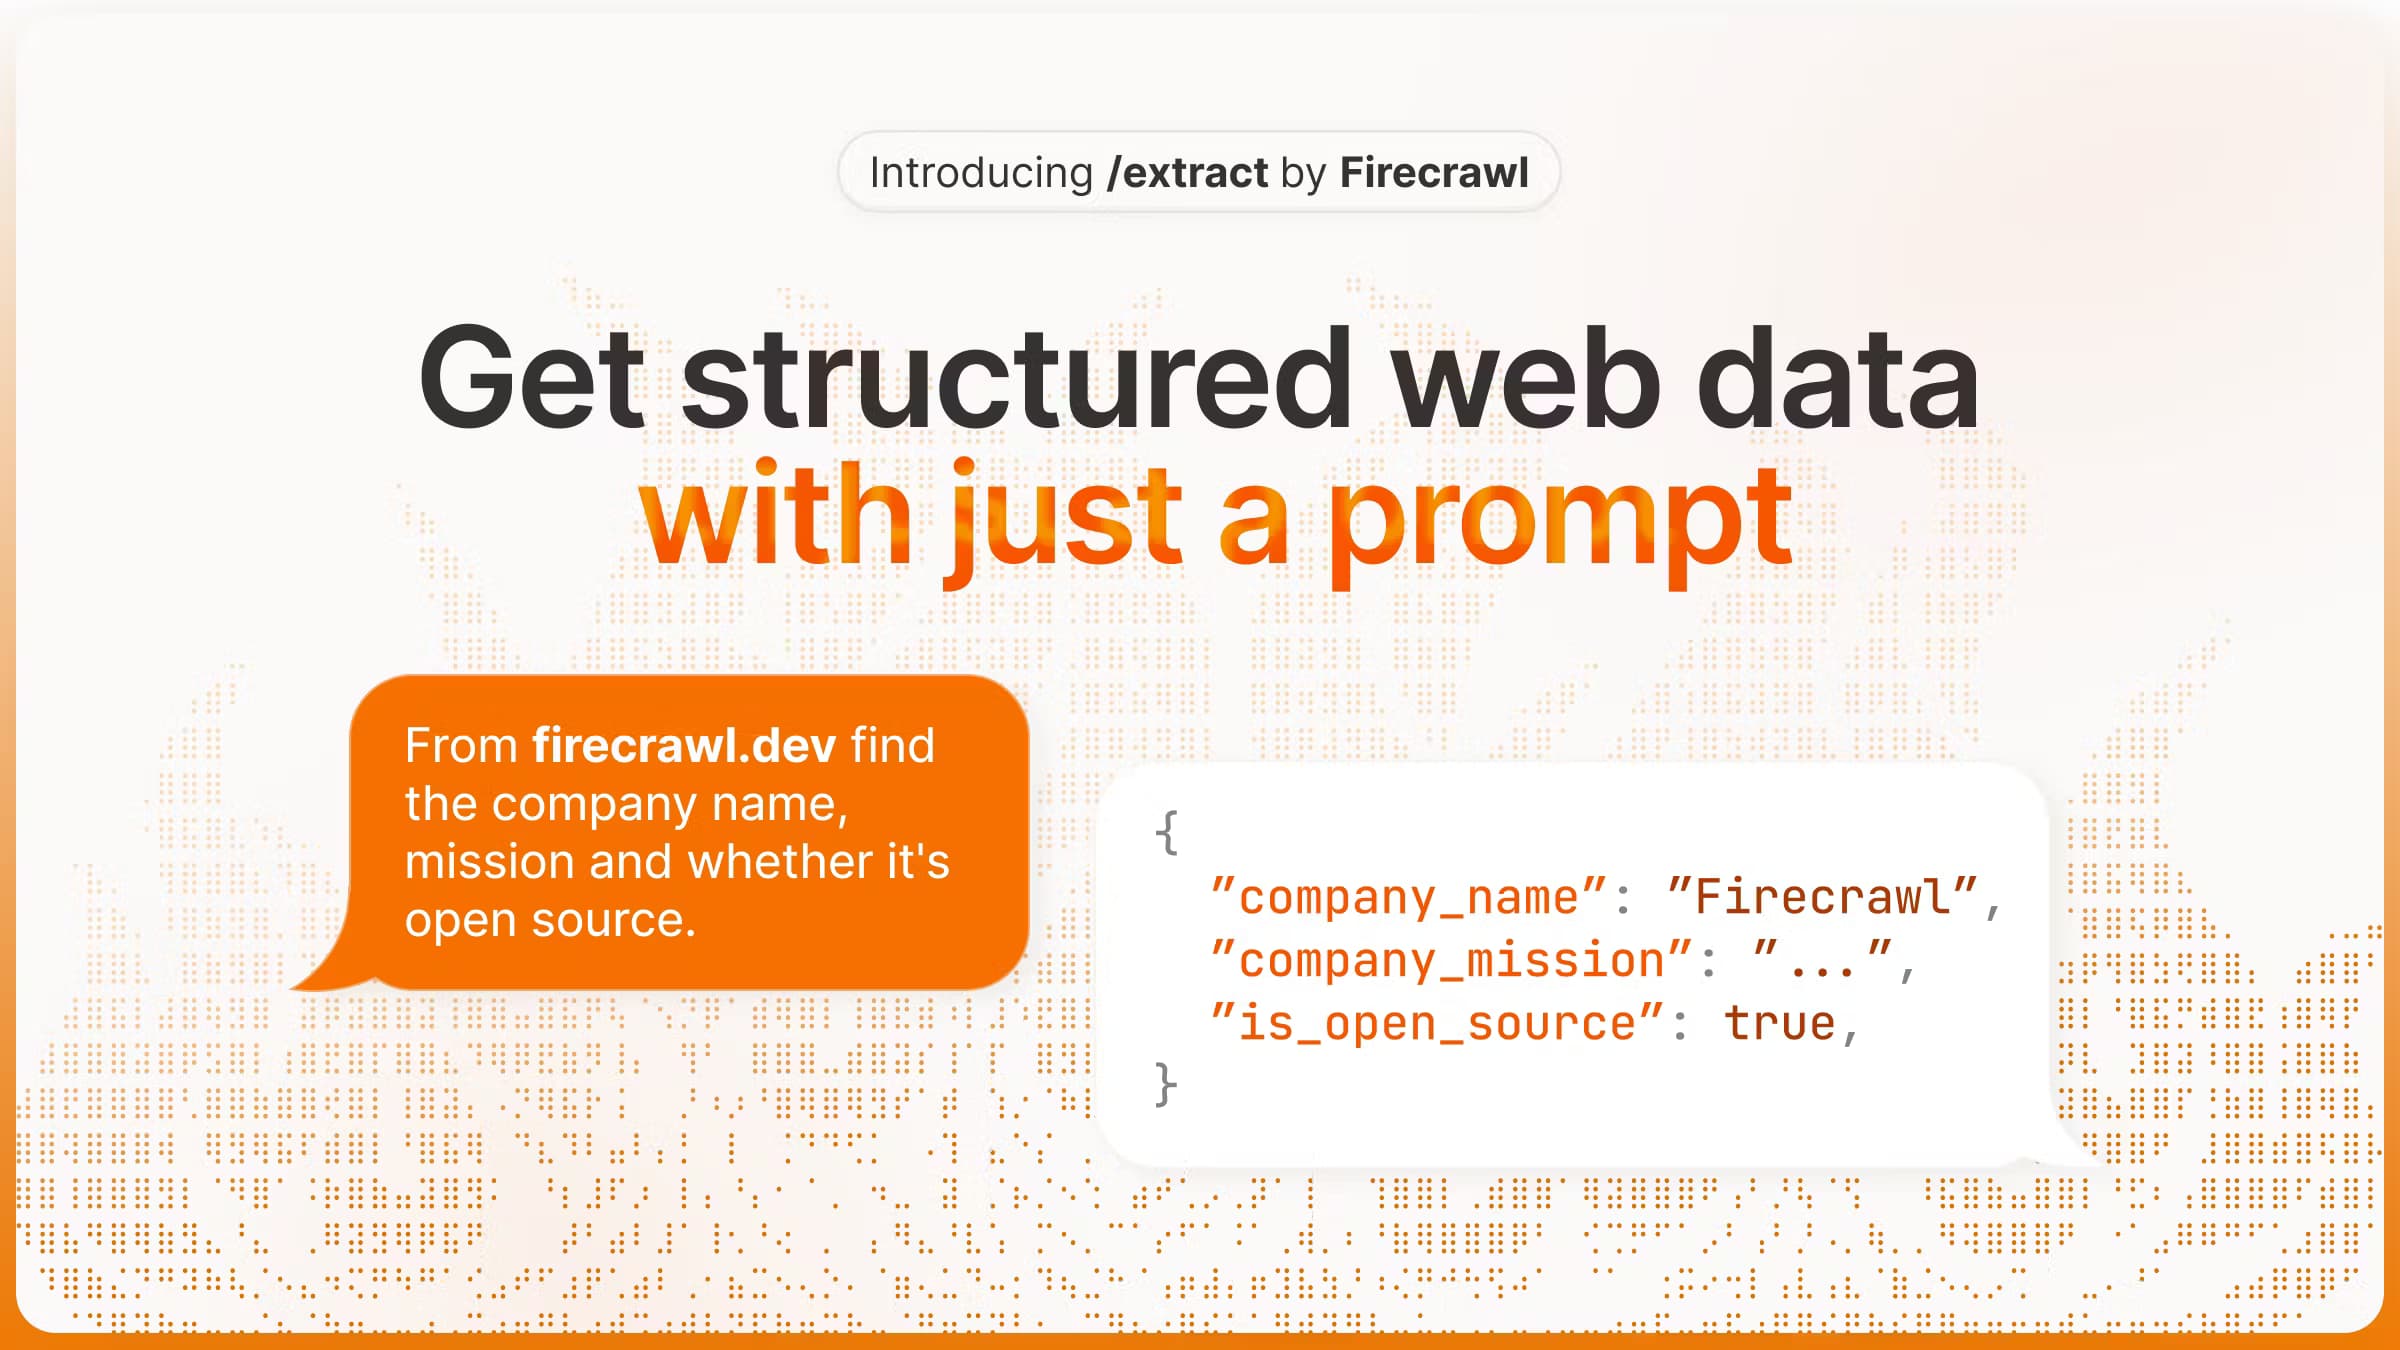
extract by Firecrawl es el endpoint /extract de Firecrawl, una API de datos web pensada para aplicaciones de IA. Rastrea las páginas que le indicas y luego usa un modelo de lenguaje para sacar campos concretos en JSON. En vez de escribir selectores a mano para cada sitio, describes los datos con palabras o entregas un esquema JSON, y Firecrawl devuelve los valores ya ordenados.
El endpoint resuelve las partes incómodas del scraping: páginas cargadas con JavaScript, defensas antibots y cambios de maquetación entre sitios. Puedes apuntar a una página, a una lista o a un dominio completo con un comodín como example.com/*, y Firecrawl rastrea lo que encuentra antes de extraer. Encaja en equipos que necesitan registros, precios o datos de empresas repetibles y directos a una base de datos o a un flujo posterior.
Dos límites marcan su uso. extract corre como una tarea asíncrona, así que envías las URLs y consultas un ID de tarea para los resultados en lugar de recibir una respuesta al instante. Y Firecrawl ahora empuja el trabajo nuevo hacia /agent, su sucesor, que encuentra sus propias URLs. extract sigue funcionando, pero es el camino más antiguo.
Getting Started
- Regístrate en firecrawl.dev y copia tu clave de API desde el panel
- Instala el SDK (pip install firecrawl-py o npm install firecrawl) e inicializa un cliente con la clave
- Llama a extract con una lista de URLs, un prompt que describa los campos o un esquema JSON si quieres una forma fija
- Lee los datos devueltos, o consulta el ID de la tarea si usaste el método de inicio para ejecuciones largas
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de extract by Firecrawl.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que crean apps de IA
- Equipos de datos y analítica
- Fundadores que investigan el mercado
- Quienes montan automatizaciones
Tareas
- Extraer registros de muchas páginas
- Convertir páginas desordenadas en JSON
- Vigilar precios y disponibilidad
- Crear bases de conocimiento para RAG
- Combinar datos de varias fuentes
Casos de uso
- Un equipo de investigación sigue precios de la competencia cada semana
- Un desarrollador da datos frescos de la web a un asistente de IA
- Un fundador escanea un mercado por primera vez
- Un equipo de operaciones mantiene un directorio al día
- Un ingeniero de datos normaliza fuentes dispersas
Funciones clave
Extracción con prompt o esquema
extract funciona de dos maneras. Puedes escribir un prompt en lenguaje natural que describa los datos que quieres, y el modelo elige una forma razonable. O puedes entregar un esquema JSON, para que cada registro vuelva con los campos y tipos exactos que definiste. Los equipos que necesitan una forma estable para una base de datos optan por el esquema; los que exploran un sitio desconocido empiezan con un prompt y lo ajustan después.
Extracción de todo un dominio con comodines
Puedes apuntar extract a una sola página, a una lista corta o a un sitio entero. Una URL con comodín, como example.com/*, le dice a Firecrawl que rastree el dominio y lea cada página que encuentre antes de extraer los campos. Así, una búsqueda por todo un sitio se resuelve en una llamada, sin que tengas que armar tú la lista de URLs. El modo de dominio completo está marcado como experimental, así que conviene revisar los resultados.
Enriquecimiento con búsqueda web
Activar la opción de búsqueda web deja que la extracción vaya más allá de las URLs que le diste. Firecrawl sigue páginas relacionadas para rellenar contexto que falta, útil cuando una sola página no trae todo lo que necesitas. Un ejemplo documentado saca precios, funciones y reseñas de dash cams partiendo de una ficha de producto y dejando que la búsqueda amplíe la red.
Tareas asíncronas con consulta de estado
extract corre como una tarea, no como una llamada que bloquea. Envías la petición y recibes un ID de tarea, y luego consultas el endpoint de estado hasta que informe "completed". Los estados son completed, processing, failed y cancelled, así que puedes engancharlo a una cola o a un worker en segundo plano. Los resultados de la tarea siguen accesibles por la API durante 24 horas tras terminar.
SDK oficiales para Python y Node
Firecrawl publica SDK para Python y Node, así que no escribes las llamadas HTTP a mano. El cliente de Python acepta un modelo Pydantic como esquema, y el de Node toma un objeto Zod, lo que te da una salida tipada y validada. Ambos incluyen un método de inicio que devuelve un ID de tarea al momento, y un método de estado para pedir los resultados cuando la tarea termina.
Facturación por créditos compartida entre endpoints
Extract ahora factura en créditos, la misma moneda que los demás endpoints. Un crédito equivale a 15 tokens en extract, mientras que un scrape básico cuesta 1 crédito por página. Los créditos se comparten entre todos los endpoints, así que los resultados de búsqueda y las páginas rastreadas salen del mismo saldo. Eso hace más fácil prever el gasto cuando una tarea mezcla extracción y rastreo.
Una ruta de migración documentada hacia Agent
Firecrawl marca extract como la herramienta antigua y dirige el trabajo nuevo a /agent, su sucesor. Agent mantiene las opciones de prompt y esquema, pero elimina el requisito de URL, por lo que puede buscar y navegar solo. Si tu caso es "encuentra estos datos en algún lugar de la web", Agent es el camino; si ya conoces las URLs, extract sigue haciendo el trabajo.
Ventajas y desventajas
Ventajas
- La salida con prompt o esquema JSON te libra de escribir selectores a mano para cada sitio
- Las URLs con comodín dejan que una tarea cubra un dominio entero, sin que armes tú la lista de páginas
- Los SDK oficiales de Python y Node admiten Pydantic y Zod para resultados tipados y validados
- La facturación por créditos se comparte entre endpoints, lo que hace previsible el gasto cuando una tarea mezcla trabajos
- Hay un plan gratuito con 1.000 créditos al mes que cubre pruebas ligeras sin tarjeta
Desventajas
- La extracción es asíncrona, así que no puedes meterla en una petición que necesite respuesta al instante
- Firecrawl ahora dirige a los usuarios nuevos hacia Agent, así que extract es el camino antiguo y va por detrás de la herramienta nueva
- La extracción de dominio completo con comodín está marcada como experimental, así que los rastreos amplios pueden exigir revisar resultados
- Los resultados de la tarea desaparecen de la API a las 24 horas, lo que deja el almacenamiento a largo plazo en tus manos
- Las páginas que devuelven estados de error como 403 o 404 igual cuestan un crédito
Preguntas frecuentes
Es el endpoint /extract de Firecrawl, una API de datos web. Le das URLs más un prompt o un esquema JSON, y un modelo de lenguaje devuelve los campos que pediste como JSON estructurado. Sirve para sacar registros repetibles de páginas que no comparten una maquetación fija.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con extract by Firecrawl.
Alternativas a extract by Firecrawl

Udon
Udon · Programación · ProductividadUdon convierte un Mac con Apple Silicon en un servidor doméstico que se gestiona desde el navegador, con contenedores, archivos compartidos y un administrador de sistemas con IA opcional.

offstage
offstage cloud · Programación · Productividadoffstage da a los agentes de IA y a los trabajos de CI un Mac de verdad: una cuenta de macOS 27 sobre Apple silicon, manejada por API y cobrada por segundo.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programación · ProductividadBotBus te deja controlar desde el móvil y el reloj los agentes de programación con IA que corren en tu ordenador: apruebas comandos, lanzas tareas y lees resultados sin volver al escritorio.