
Featherless
Featherless (formerly Recursal.AI) · Programación · Otro
Featherless es una plataforma de inferencia sin servidor que reúne más de 40.000 modelos abiertos en una API compatible con OpenAI, con precio fijo mensual y sin montar servidores.
Acerca de Featherless
About
Qué es Featherless
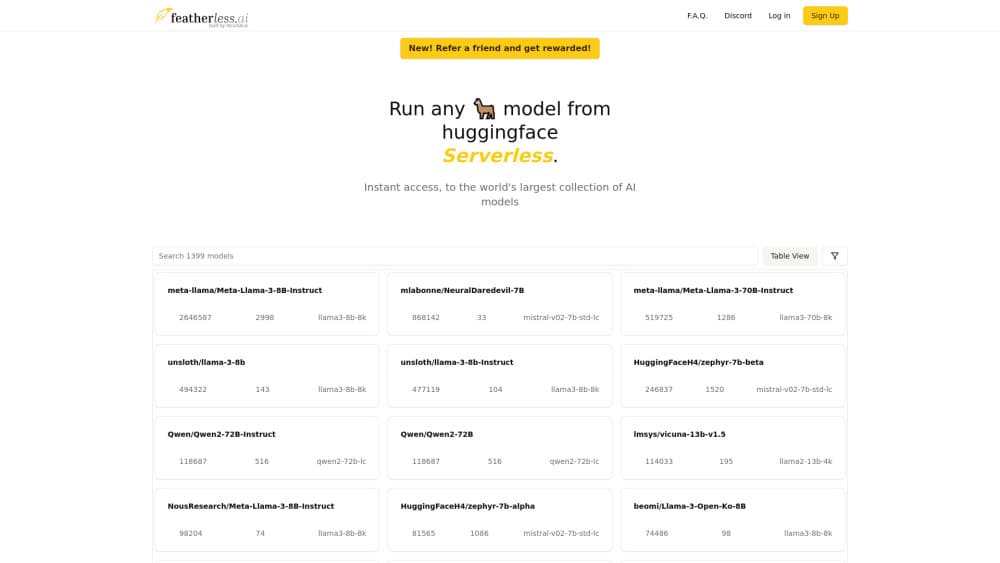
Featherless es un servicio de inferencia para modelos abiertos. Eliges un checkpoint entre más de 40.000, apuntas tu cliente a un único endpoint y la plataforma se encarga de las GPU. No descargas pesos ni mantienes contenedores calientes, y el alojamiento de modelos deja de ser tu problema.
La empresa nació como Recursal.AI, un equipo de investigación cuyos fundadores codirigen RWKV, un proyecto de la Linux Foundation basado en una arquitectura sin atención. De ahí viene la propuesta: los pesos abiertos deberían llamarse con la misma facilidad que una API cerrada. Hoy sirve modelos de miles de creadores, desde pequeños modelos de chat de 7B hasta referentes de 800B.
Los límites importan tanto como el catálogo. El plan de chat básico se queda en 32K de contexto y cuatro unidades concurrentes, y sus condiciones limitan el uso a la escritura interactiva del comprador. El tráfico de aplicaciones, la automatización y las pruebas comparativas van en el plan developer, que arranca con 50 USD en créditos mensuales.
Primeros pasos
- Crea una cuenta en featherless.ai y abre la consola para generar una clave de API.
- Elige un modelo del catálogo y copia su identificador completo, por ejemplo un checkpoint de Qwen o DeepSeek.
- Apunta un cliente compatible con OpenAI a la URL base
https://api.featherless.ai/v1y pega tu clave. - Lanza una petición de prueba y revisa latencia y calidad antes de construir encima.
- Pasa al plan developer cuando necesites más contexto, más concurrencia o tráfico de aplicación.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Featherless.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Guionistas y aficionados al rol
- Desarrolladores independientes
- Equipos de producto pequeños
- Curiosos de los modelos
Tareas
- Agentes de código
- Análisis de documentos largos
- Redacción y reescritura
- Investigación de modelos
Casos de uso
- Un prototipo de fin de semana
- Una comunidad de rol
- Un piloto en producción
Funciones clave
Una API para más de 40.000 modelos abiertos
Todo el catálogo se alcanza con un endpoint y una clave. Eso incluye lanzamientos que suben rápido en Hugging Face, modelos pequeños para tareas concretas y grandes checkpoints de razonamiento. Cambias el identificador en la petición y la plataforma enruta.
Plan de chat de precio fijo con tokens ilimitados
El plan de chat de 25 USD al mes no cobra tokens. Escribir un capítulo de 10.000 palabras cuesta lo mismo que un párrafo. La contrapartida es un techo de 32K de contexto y cuatro unidades concurrentes, así que la velocidad bajo carga paralela tiene un límite deliberado.
Plan developer medido con créditos acumulables
Cincuenta dólares al mes compran créditos que no caducan, y cada modelo los consume a su propia tarifa por millón de tokens. Una petición fallida no cuesta nada. El saldo sobrante pasa al ciclo siguiente, algo útil cuando el tráfico es irregular.
Ventanas de contexto de hasta 256K
El plan developer eleva el límite de 32K a 256K, suficiente para una parte de un código, un contrato o un hilo de investigación largo. Los clientes business pueden pedir más, ajustado a sus propias GPU.
Endpoint compatible con OpenAI
La URL base sigue la forma de chat completions de OpenAI, así que los SDK y las herramientas actuales funcionan cambiando URL y clave. Por eso editores, frameworks de agentes y flujos de n8n lo adoptan sin reescribir código.
GPU dedicadas y ajustes privados
El plan business corre sobre hardware H100, MI325X, B200 o B300 dedicado, sin límites de velocidad compartidos. Los equipos pueden servir ajustes privados vía Hugging Face y desbordar a nube pública cuando sube la demanda.
Ventajas y desventajas
Ventajas
- Cero configuración de GPU y cero ajuste de arranque en frío, que suele ser la parte más lenta de servir modelos abiertos.
- Los tokens ilimitados del plan de chat hacen previsible la escritura intensiva por 25 USD al mes.
- Los créditos no caducan y solo se factura la petición que responde en el plan developer.
- La API compatible con OpenAI conecta clientes y herramientas de agentes con muy pocos cambios.
- El plan business ofrece hardware dedicado, ajustes privados y soporte con nombre propio.
Desventajas
- No hay plan gratuito, así que pagas 25 USD antes de juzgar la calidad con tus propios prompts.
- El plan de chat se detiene en 32K de contexto y cuatro unidades concurrentes, lo que descarta documentos largos y automatización en paralelo.
- Las condiciones del plan de chat prohíben tráfico de aplicación, reventa y benchmarking, así que un prototipo que funcione tiene que mudarse al plan medido.
- Un catálogo enorme no garantiza encaje. Las descargas populares dicen poco sobre el seguimiento de instrucciones, conviene probar varios modelos.
Preguntas frecuentes
Es una puerta de entrada alojada a modelos de lenguaje abiertos. Sirve para conversar con modelos, ejecutar agentes de código, redactar textos o probar checkpoints sin alquilar una GPU ni montar una pila de inferencia.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Featherless.
Alternativas a Featherless

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.