
Fireworks
Fireworks AI · Programación
Fireworks AI es una plataforma para ejecutar y entrenar modelos de IA abiertos, con inferencia sin servidor, despliegues en GPU dedicadas y ajuste fino en un solo sitio.
Acerca de Fireworks
What Is Fireworks AI
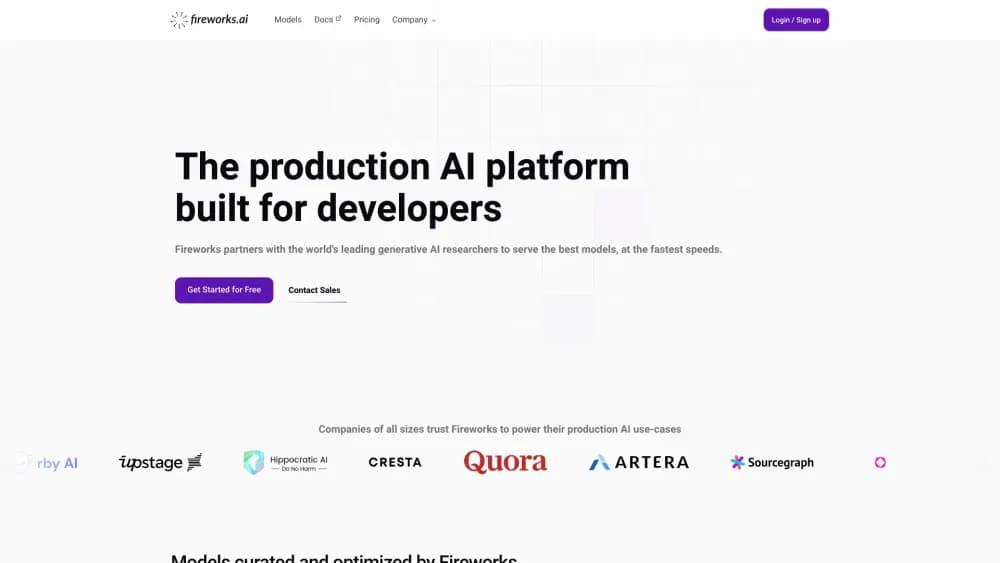
Fireworks AI es una plataforma para construir con modelos abiertos. Ejecuta inferencia en producción para modelos como Llama, DeepSeek, Qwen y Kimi, y además se encarga del entrenamiento cuando necesitas un modelo ajustado con tus propios datos. El equipo que creó PyTorch en Meta fundó la empresa, y su motor de inferencia, FireAttention, está hecho para servir modelos rápido sin sacrificar la calidad de las respuestas.
El problema que resuelve es la distancia entre descargar un modelo de un repositorio y ponerlo a funcionar con usuarios reales. Una GPU y un script abierto te dan una demo. Servir ese mismo modelo a miles de personas con baja latencia, un coste predecible y escalado automático es otro trabajo. Fireworks cubre esa capa: tú apuntas una llamada a la API a un modelo y dejas que la plataforma gestione el hardware por debajo.
Dos límites marcan cuándo encaja. Es una plataforma para desarrolladores, no una app de chat que abres en el navegador, así que necesitas código para usarla. Y los modelos abiertos que sirve pueden quedarse atrás frente a un modelo de frontera cerrado en algunas tareas, algo que importa si tu producto depende del mejor razonamiento posible. Para equipos que lanzan funciones de IA con presupuesto y plazo ajustados, estas concesiones suelen salir a cuenta.
Getting Started
- Crea una cuenta en app.fireworks.ai y genera una clave de API en los ajustes del panel.
- Elige un modelo del catálogo. Empieza por Serverless para probar varias opciones con pago por token antes de comprometerte.
- Envía tu primera petición. Fireworks ofrece un endpoint compatible con OpenAI, así que puedes reutilizar código existente del SDK de OpenAI o Anthropic cambiando la URL base y la clave.
- Pasa a un despliegue cuando necesites más control. Los despliegues on-demand corren en GPUs dedicadas con escalado automático, y la capacidad reservada garantiza el rendimiento.
- Ajusta un modelo si la calidad de serie no llega, y despliega el resultado en la misma infraestructura.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Fireworks.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores e ingenieros de ML
- Equipos emergentes que lanzan funciones de IA
- Empresas con requisitos de datos y cumplimiento
Tareas
- Poner un modelo abierto en producción
- Ajustar fino con tus propios datos
- Construir un agente que llama herramientas
- Migrar desde una API de modelo cerrado
Casos de uso
- Prototipar antes de comprometer GPUs
- Tráfico irregular
- Recortar el coste de una función de gran volumen
Funciones clave
Inferencia sin servidor y rápida
Serverless ejecuta los modelos abiertos más usados con pago por token y sin infraestructura que gestionar. Fireworks ofrece rutas Standard, Priority y Fast, así que puedes cambiar coste por latencia según la petición. El endpoint compatible con OpenAI hace que el código existente funcione a menudo con solo cambiar la URL base. Es la vía más rápida para probar un modelo antes de invertir en un despliegue.
Despliegues en GPU dedicadas
Cuando un endpoint compartido no basta, los despliegues on-demand corren tu modelo en GPUs dedicadas con escalado automático rápido y arranques en frío cortos. Puedes ajustar un despliegue para velocidad o rendimiento y servirlo en varias regiones. La capacidad reservada va más allá: garantiza rendimiento y cuotas más altas, y te da acceso primero al hardware nuevo. Es la capa donde se asientan las cargas de producción cuando el uso se estabiliza.
Ajuste fino y entrenamiento
Fireworks cubre el ajuste fino supervisado y por refuerzo para modelos de hasta un billón de parámetros y más. Puedes seguir una ruta guiada donde describes la tarea y revisas un plan, configurar una ejecución por tu cuenta, o escribir tu propia lógica de entrenamiento sobre las GPUs de la plataforma. Cada checkpoint se despliega en producción en segundos, lo que mantiene corto el bucle entre entrenar y servir.
Soporte multimodal de modelos
El catálogo cubre modelos de texto, visión, audio, imagen y embeddings, así que puedes analizar documentos, generar imágenes y construir búsqueda en una sola plataforma. Los modelos de visión leen imágenes y documentos, los embeddings y el reranking alimentan la búsqueda y la recuperación de contexto, y la inferencia por lotes ejecuta trabajos asíncronos grandes a menor coste. Para sistemas con varios modelos, ese abanico sale de una única cuenta y API.
Function calling y salidas estructuradas
El function calling conecta un modelo con tus herramientas y API, de modo que puede consultar datos o disparar una acción en lugar de solo conversar. Las salidas estructuradas devuelven JSON fiable que encaja con un esquema que tú defines, algo que los flujos agénticos necesitan para mover resultados sin errores de análisis. Ambas cosas pasan por el mismo endpoint, así que no añades un segundo servicio para sumar herramientas.
Motor de inferencia FireAttention
FireAttention es el motor de servicio bajo la plataforma, afinado para rendimiento y latencia sin perder calidad del modelo. Fireworks lo construyó en lugar de apoyarse en una pila de propósito general, y es la razón por la que la plataforma sirve modelos abiertos con la rapidez que exigen los productos interactivos. Para ti, eso se traduce en menor latencia y menor coste por token con el mismo hardware.
Ventajas y desventajas
Ventajas
- Todo en un sitio: inferencia sin servidor, despliegues dedicados y ajuste fino, sin coser servicios separados.
- Los endpoints compatibles con OpenAI y Anthropic te dejan reutilizar el código del SDK y cambiar de modelo con pequeños ajustes.
- El pago por token sin servidor y sin gasto mínimo abarata las pruebas antes de comprometer GPUs.
- Catálogo amplio de modelos que abarca texto, visión, audio, imagen y embeddings bajo una sola API.
- Cobertura SOC 2 y HIPAA, más capacidad reservada, encajan con equipos que exigen cumplimiento y rendimiento.
Desventajas
- Es una plataforma para desarrolladores sin interfaz de chat de consumo, así que quien no programa no puede usarla directamente.
- Los modelos abiertos pueden quedarse atrás frente a los de frontera cerrados en razonamiento complejo o tareas de nicho.
- El coste sube rápido con mucho volumen, así que conviene vigilar el uso y fijar límites de gasto.
- La facturación autoservicio funciona con créditos prepago, lo que añade un paso antes de tu primera llamada.
Preguntas frecuentes
Fireworks AI sirve y entrena modelos de IA abiertos para producción. Lo usas para ejecutar modelos como Llama, DeepSeek y Qwen tras una API rápida, ajustarlos con tus datos y escalarlos en GPUs dedicadas.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Fireworks.
Alternativas a Fireworks

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.