
Fish Speech
Fish Audio · Voz e idioma · Vídeo
Fish Speech es el modelo de texto a voz de código abierto de Fish Audio, hoy distribuido como Drama 3: clona una voz en 10 o 30 segundos, habla 83 idiomas y admite etiquetas de emoción.
Acerca de Fish Speech
About
Qué es Fish Speech
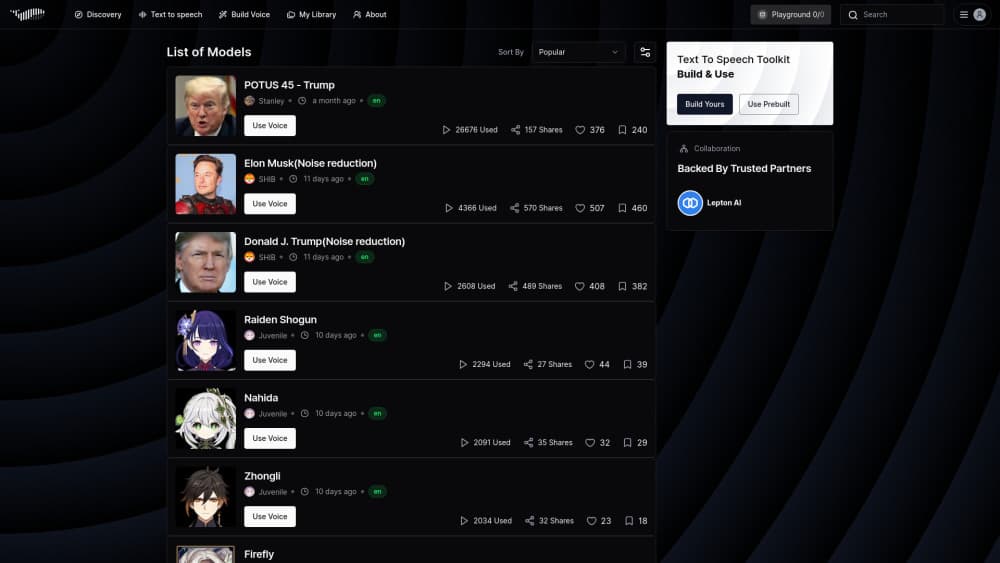
Fish Speech es un modelo de texto a voz de código abierto de Fish Audio, la empresa que está detrás de la plataforma fish.audio. Bajo ese nombre conviven dos cosas que se entregan juntas: los pesos del modelo en Hugging Face y el código en GitHub, más el servicio alojado que ejecuta esos mismos modelos tras una web y una API. Puedes usar la versión alojada y comportarte como con cualquier generador de voz con IA, o descargar los pesos y quedarte con toda la infraestructura en tus manos.
La familia ha avanzado rápido. Fish Speech 1.x y OpenAudio S1 fijaron la propuesta: clonar una voz a partir de una muestra breve y controlar el tono con lenguaje normal. S2 y S2.1 Pro mejoraron la precisión y el streaming. Drama 3, publicado el 13 de octubre de 2026, es el modelo actual: 35B de parámetros con 3B activos por token, y añade edición local de audio y revisión por turnos sobre lo que ya funcionaba.
El problema que resuelve es la distancia entre lo abierto y lo pulido. Casi todos los proyectos de TTS de código abierto suenan planos al lado de las herramientas comerciales, y casi todas las herramientas comerciales te obligan a pasar por su nube. Aquí tienes las dos puertas: los pesos se descargan con la licencia comunitaria de Fish Audio, que permite uso comercial a empresas con menos de 500.000 dólares de ingresos anuales, y los planes alojados arrancan gratis.
Los límites también cuentan. Autoalojarlo pide una GPU NVIDIA y algo de paciencia con entornos de Python. La calidad del clon depende de la limpieza del audio de referencia: una grabación con ruido de fondo da un clon con ruido de fondo. Y la mayoría de las cifras de benchmark salen de pruebas de Fish Audio; Artificial Analysis es la comparación independiente más seria que hay hoy.
Primeros pasos
- Entra en fish.audio y crea una cuenta gratuita. El plan gratis incluye unos 7 minutos de audio al mes, suficiente para saber si las voces encajan con tu proyecto.
- Elige una voz de la biblioteca o clona la tuya. Para clonar, sube entre 10 y 30 segundos de habla limpia, sin música ni reverberación de la habitación.
- Pega el guion en el cuadro de texto y coloca las etiquetas de dirección donde cambie la intención, por ejemplo [whisper] antes de una frase o [laughing] después.
- Genera, escucha y ajusta las etiquetas antes de reescribir el texto. Un cambio de etiqueta mueve más la interpretación que una frase reformulada.
- Si vas a autoalojarlo, clona el repositorio de GitHub, monta el entorno, descarga los pesos desde Hugging Face y arranca la interfaz web o el servidor de API en una máquina con una tarjeta NVIDIA reciente.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Fish Speech.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Creadores de YouTube y podcasters
- Desarrolladores de videojuegos y animación
- Desarrolladores que añaden voz a un producto
- Equipos de localización
Tareas
- Doblar un vídeo a otro idioma
- Maquetar diálogos de un personaje
- Convertir un artículo en audio
- Añadir voz a un prototipo
Casos de uso
- Probar una idea antes de pagar estudio
- Llevar un canal a varios mercados
- Entregar una demo con fecha límite
Funciones clave
Clonación de voz con una muestra corta
Con 10 o 30 segundos de audio de referencia basta para reproducir un timbre, y Fish Audio anuncia 15 segundos en su web. El clon conserva acento, altura y ritmo de habla, no solo una impresión general. Lo que mejor funciona es un archivo mono grabado cerca del micrófono; la música de fondo es la vía más rápida para arruinarlo.
Etiquetas de dirección en el texto
Controlas la interpretación con instrucciones entre corchetes colocadas donde cambia el ánimo: [whispering], [angry], [sighing], [laughing], [pause]. Drama 3 también acepta dirección libre, así que [barely holding it together, forcing a smile] funciona como etiqueta. Las etiquetas emparejadas, como las de énfasis, dirigen solo unas palabras dentro de la frase. Esta es la diferencia real frente a los motores antiguos, donde ajustabas velocidad y tono y confiabas en la suerte.
Cobertura amplia de idiomas
Drama 3 habla 83 idiomas, muy por encima de los 13 que manejaba Fish Speech 1.5. Eso lo coloca entre los modelos de TTS multilingüe más amplios que puedes descargar. Lo importante es el clon entre idiomas: clonas la voz una vez y generas en otro idioma conservando la identidad del hablante. Las etiquetas de dirección se escriben en el idioma en que piensas y el modelo las aplica igual.
Varias voces en una sola escena
Un mismo texto puede llevar varios personajes marcados con identificadores de hablante, y el modelo genera el intercambio completo de una pasada. Para audiodrama, cinemáticas de juego o vídeos con dos presentadores, eso elimina el ciclo de generar, pegar y recolocar tiempos que hacía pesado el trabajo con varias voces.
Edición local y revisión por turnos
Drama 3 te deja editar una toma terminada como si fuera un documento. Cambias una palabra y el timbre y las transiciones alrededor siguen intactos, así que no regeneras cinco minutos de audio por un error. La revisión por turnos va en la otra dirección: le dices que la última toma debería ser más suave o más triste y vuelve a generarla con ese contexto.
Pesos abiertos para autoalojar
El código y los pesos son públicos, y la licencia comunitaria autoriza el uso comercial por debajo de 500.000 dólares de ingresos anuales. Para equipos con requisitos de privacidad o volumen previsible, es una opción seria: la inferencia local no cobra por carácter. A cambio pones hardware, tiempo de instalación y el mantenimiento de una pila de Python.
API en streaming con baja latencia
La API alojada emite audio mientras genera, con el primer sonido alrededor de los 100 ms y un factor de tiempo real de 0,195 en una H200 según las mediciones de Fish Audio. Texto a voz, voz a texto y un endpoint de agente de voz comparten la misma clave. En productos conversacionales, esa latencia separa a un asistente que interrumpe de uno que espera su turno.
Ventajas y desventajas
Ventajas
- La clonación funciona con una referencia corta, así que no necesitas una sesión de grabación para tener una voz usable.
- La emoción y el ritmo se controlan con etiquetas en lenguaje normal, mucho más rápido de iterar que con deslizadores de parámetros.
- El plan gratuito y los pesos abiertos dan dos formas baratas de evaluarlo antes de pagar.
- 83 idiomas con clonación entre lenguas cubren buena parte del trabajo de localización con una sola identidad de voz.
- La latencia en streaming y una API abierta lo hacen viable dentro de un producto real, no solo para archivos sueltos.
Desventajas
- Autoalojarlo exige una GPU NVIDIA y soltura con entornos de Python, lo que deja fuera al usuario casual.
- La calidad del clon depende mucho del audio de referencia: una grabación con ruido da un resultado opaco y no hay herramienta de limpieza incluida.
- La licencia comunitaria limita el uso comercial gratuito a empresas con menos de 500.000 dólares anuales, así que las grandes necesitan un acuerdo aparte.
- Casi todos los benchmarks publicados los ejecuta el propio fabricante, y las comparaciones independientes miden pronunciación, no rango emocional.
Preguntas frecuentes
Sí. El servicio alojado tiene un plan gratuito de unos 7 minutos de generación al mes, y los pesos se descargan sin coste. El uso comercial de los pesos abiertos es libre para organizaciones con menos de 500.000 dólares de ingresos anuales.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Fish Speech.
Alternativas a Fish Speech

Off the Record
Weird Machines · Voz e idioma · ProductividadOff the Record es una app de macOS de Weird Machines que modifica tu voz en tiempo real para bloquear la transcripción con IA: la gente te oye con normalidad y las notas automáticas no obtienen nada aprovechable.
Cekura Bench
Cekura · Voz e idioma · NegociosCekura Bench es un benchmark público que somete a modelos de voz a voz y a agentes desplegados a 82 llamadas simuladas, tres veces cada una, y publica tasas de éxito, latencia y coste por minuto.
Griffin by Tavus
Tavus · Voz e idioma · Vídeo · ChatbotGriffin by Tavus es el primer modelo de interacción humana: un sistema de vídeo a vídeo y dúplex completo que observa, escucha y responde durante una llamada de vídeo con IA en tiempo real.