
Fuzzy Match
Radix Analytics Pvt Ltd · Programación
Fuzzy Match es una herramienta web de coincidencia de datos que carga archivos CSV o Excel y encuentra nombres parecidos, erratas y variantes ortográficas en las columnas que elijas.
Acerca de Fuzzy Match
What Is Fuzzy Match
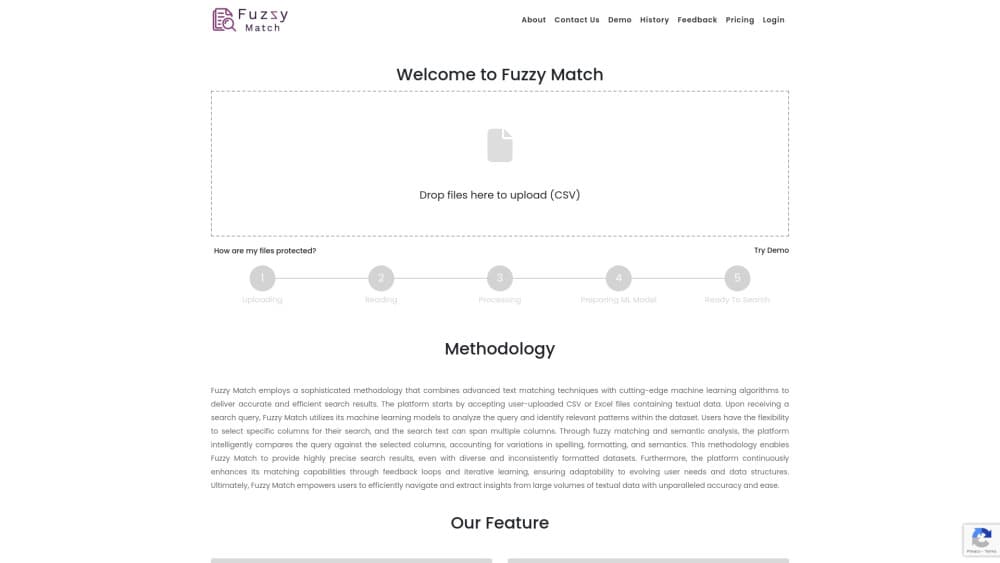
Fuzzy Match es una aplicación web de Radix Analytics que compara el texto que escribes con un archivo que subes. Eliges las columnas que quieres consultar, envías un nombre, una dirección o una referencia de producto, y la herramienta devuelve las filas que se parecen a tu búsqueda, incluidas las que llevan erratas o un formato distinto.
El producto ataca un problema muy de oficina: dos listas que describen lo mismo pero nunca coinciden en la grafía. Un cliente aparece como «Jon Smith» en un export y como «John Smyth» en otro. Con una herramienta de coincidencia difusa así, localizas esas parejas sin escribir SQL ni Python.
Es una consola de búsqueda, no una suite completa de depuración de datos. Obtienes coincidencias ordenadas y un historial de ejecuciones, pero no un flujo que reconstruya un registro maestro. Cada plan también limita el tamaño del archivo, el número de archivos y la cantidad de resultados, así que los conjuntos muy grandes hay que partirlos antes de subirlos.
Getting Started
- Abre fuzzymatch.in y prueba la demo sin cuenta, o inicia sesión para desbloquear los límites del plan gratuito.
- Sube un archivo CSV o Excel y espera mientras el servicio lee las filas y prepara su modelo de comparación.
- Marca las columnas que quieres rastrear y escribe el nombre, la dirección o el código que buscas.
- Revisa los resultados ordenados, ajusta la redacción de la consulta y guarda la ejecución en el historial.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Fuzzy Match.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Analistas de datos
- Administradores de operaciones y CRM
- Equipos pequeños sin ingenieros
Tareas
- Deduplicar una lista de clientes
- Coincidencia de direcciones
- Limpieza de catálogo
- Depuración de datos antes de reportar
Casos de uso
- Auditoría puntual de un archivo
- Controles mensuales de proveedores
- Revisión previa a una migración
Funciones clave
Coincidencia difusa que aguanta erratas
El motor compara tu consulta con cada fila y sigue devolviendo aciertos cuando sobran, faltan o bailan letras. Eso importa en trabajos de coincidencia de datos con registros tecleados a mano, donde el primer error de escritura deja fuera un filtro exacto.
Control de columnas en la búsqueda
Tú decides qué columnas lee el motor, y una misma consulta puede abarcar más de una. Limitar la búsqueda a la columna de nombres reduce el ruido de notas y campos libres, y la lista ordenada queda lo bastante corta para revisarla.
Machine learning en lugar de listas de reglas
Fuzzy Match presenta su comparación como un modelo que aprende del archivo, no como un conjunto fijo de excepciones. En la práctica ayuda con bases donde el formato cambia de una fila a otra.
Bucles de retroalimentación
La plataforma recoge tus valoraciones sobre las coincidencias y las usa para afinar ejecuciones posteriores. Si marcas una pareja como incorrecta, el modelo recibe una señal, y esa es la razón principal para iniciar sesión en vez de usar la demo anónima.
Historial y control de retención
Cada ejecución queda en una vista de historial y puedes borrar archivos antes de que caduquen. La retención depende del plan: 24 horas en el gratuito y luego 7, 15 o 30 días según subes de nivel.
Límites por plan y modelos propios
Los tramos gratuitos y de pago se diferencian en tamaño de archivo, número de resultados, almacenamiento y archivos por mes. Premium añade un modelo de ML entrenado con tus datos, pensado para equipos con reglas de coincidencia muy propias de su sector.
Ventajas y desventajas
Ventajas
- Sin instalación ni configuración: todo ocurre en una pestaña del navegador y la demo funciona antes de crear la cuenta.
- Topes transparentes: el tamaño de archivo, los resultados y la retención están publicados por plan, así que puedes anticipar si el gratuito te alcanza.
- Comparación que aprende: las correcciones vuelven al modelo y eso gana a las reglas estáticas de distancia entre cadenas en listas sucias.
- Opción de modelo propio: Premium cubre a equipos que necesitan un ajuste sobre sus datos y no un modelo general.
Desventajas
- Los topes de resultados pesan en archivos grandes: incluso Premium se queda en 1.000 coincidencias por búsqueda, así que un trabajo de 50.000 filas hay que trocearlo.
- Sin API pública documentada: la automatización se limita a subidas manuales, lo que descarta pipelines programados salvo que construyas algo alrededor del flujo web.
- Retención corta: los archivos desaparecen a los 30 días como máximo, de modo que la herramienta no sirve como almacén ligero para auditorías.
- La revisión humana sigue siendo necesaria: entre las coincidencias cercanas hay falsos positivos y la herramienta no fusiona registros por ti.
Preguntas frecuentes
Busca en un archivo CSV o Excel las filas que se parecen al texto que escribes, incluidas las que tienen erratas y variantes ortográficas. Tú eliges las columnas y revisas los resultados ordenados.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Fuzzy Match.
Alternativas a Fuzzy Match

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.