
Hasura
Hasura · Programación
Hasura es una plataforma de supergrafo basada en metadatos que conecta tus bases de datos, código y API y los sirve como endpoints GraphQL rápidos y seguros.
Acerca de Hasura
What Is Hasura
Hasura es una capa de acceso a datos que se coloca entre tus fuentes de datos y tus aplicaciones. Apuntas sus conectores a bases de datos, microservicios y API de terceros, defines cómo se relacionan los datos en los metadatos y Hasura compila todo eso en una sola API GraphQL. Su producto estrella hoy es la Hasura Data Delivery Network (DDN), un supergrafo que reúne muchas fuentes en un único endpoint. La empresa también desarrolla PromptQL, una capa de IA para consultar esos datos en lenguaje natural, y mantiene el motor GraphQL Engine de código abierto con el que empezó el proyecto.
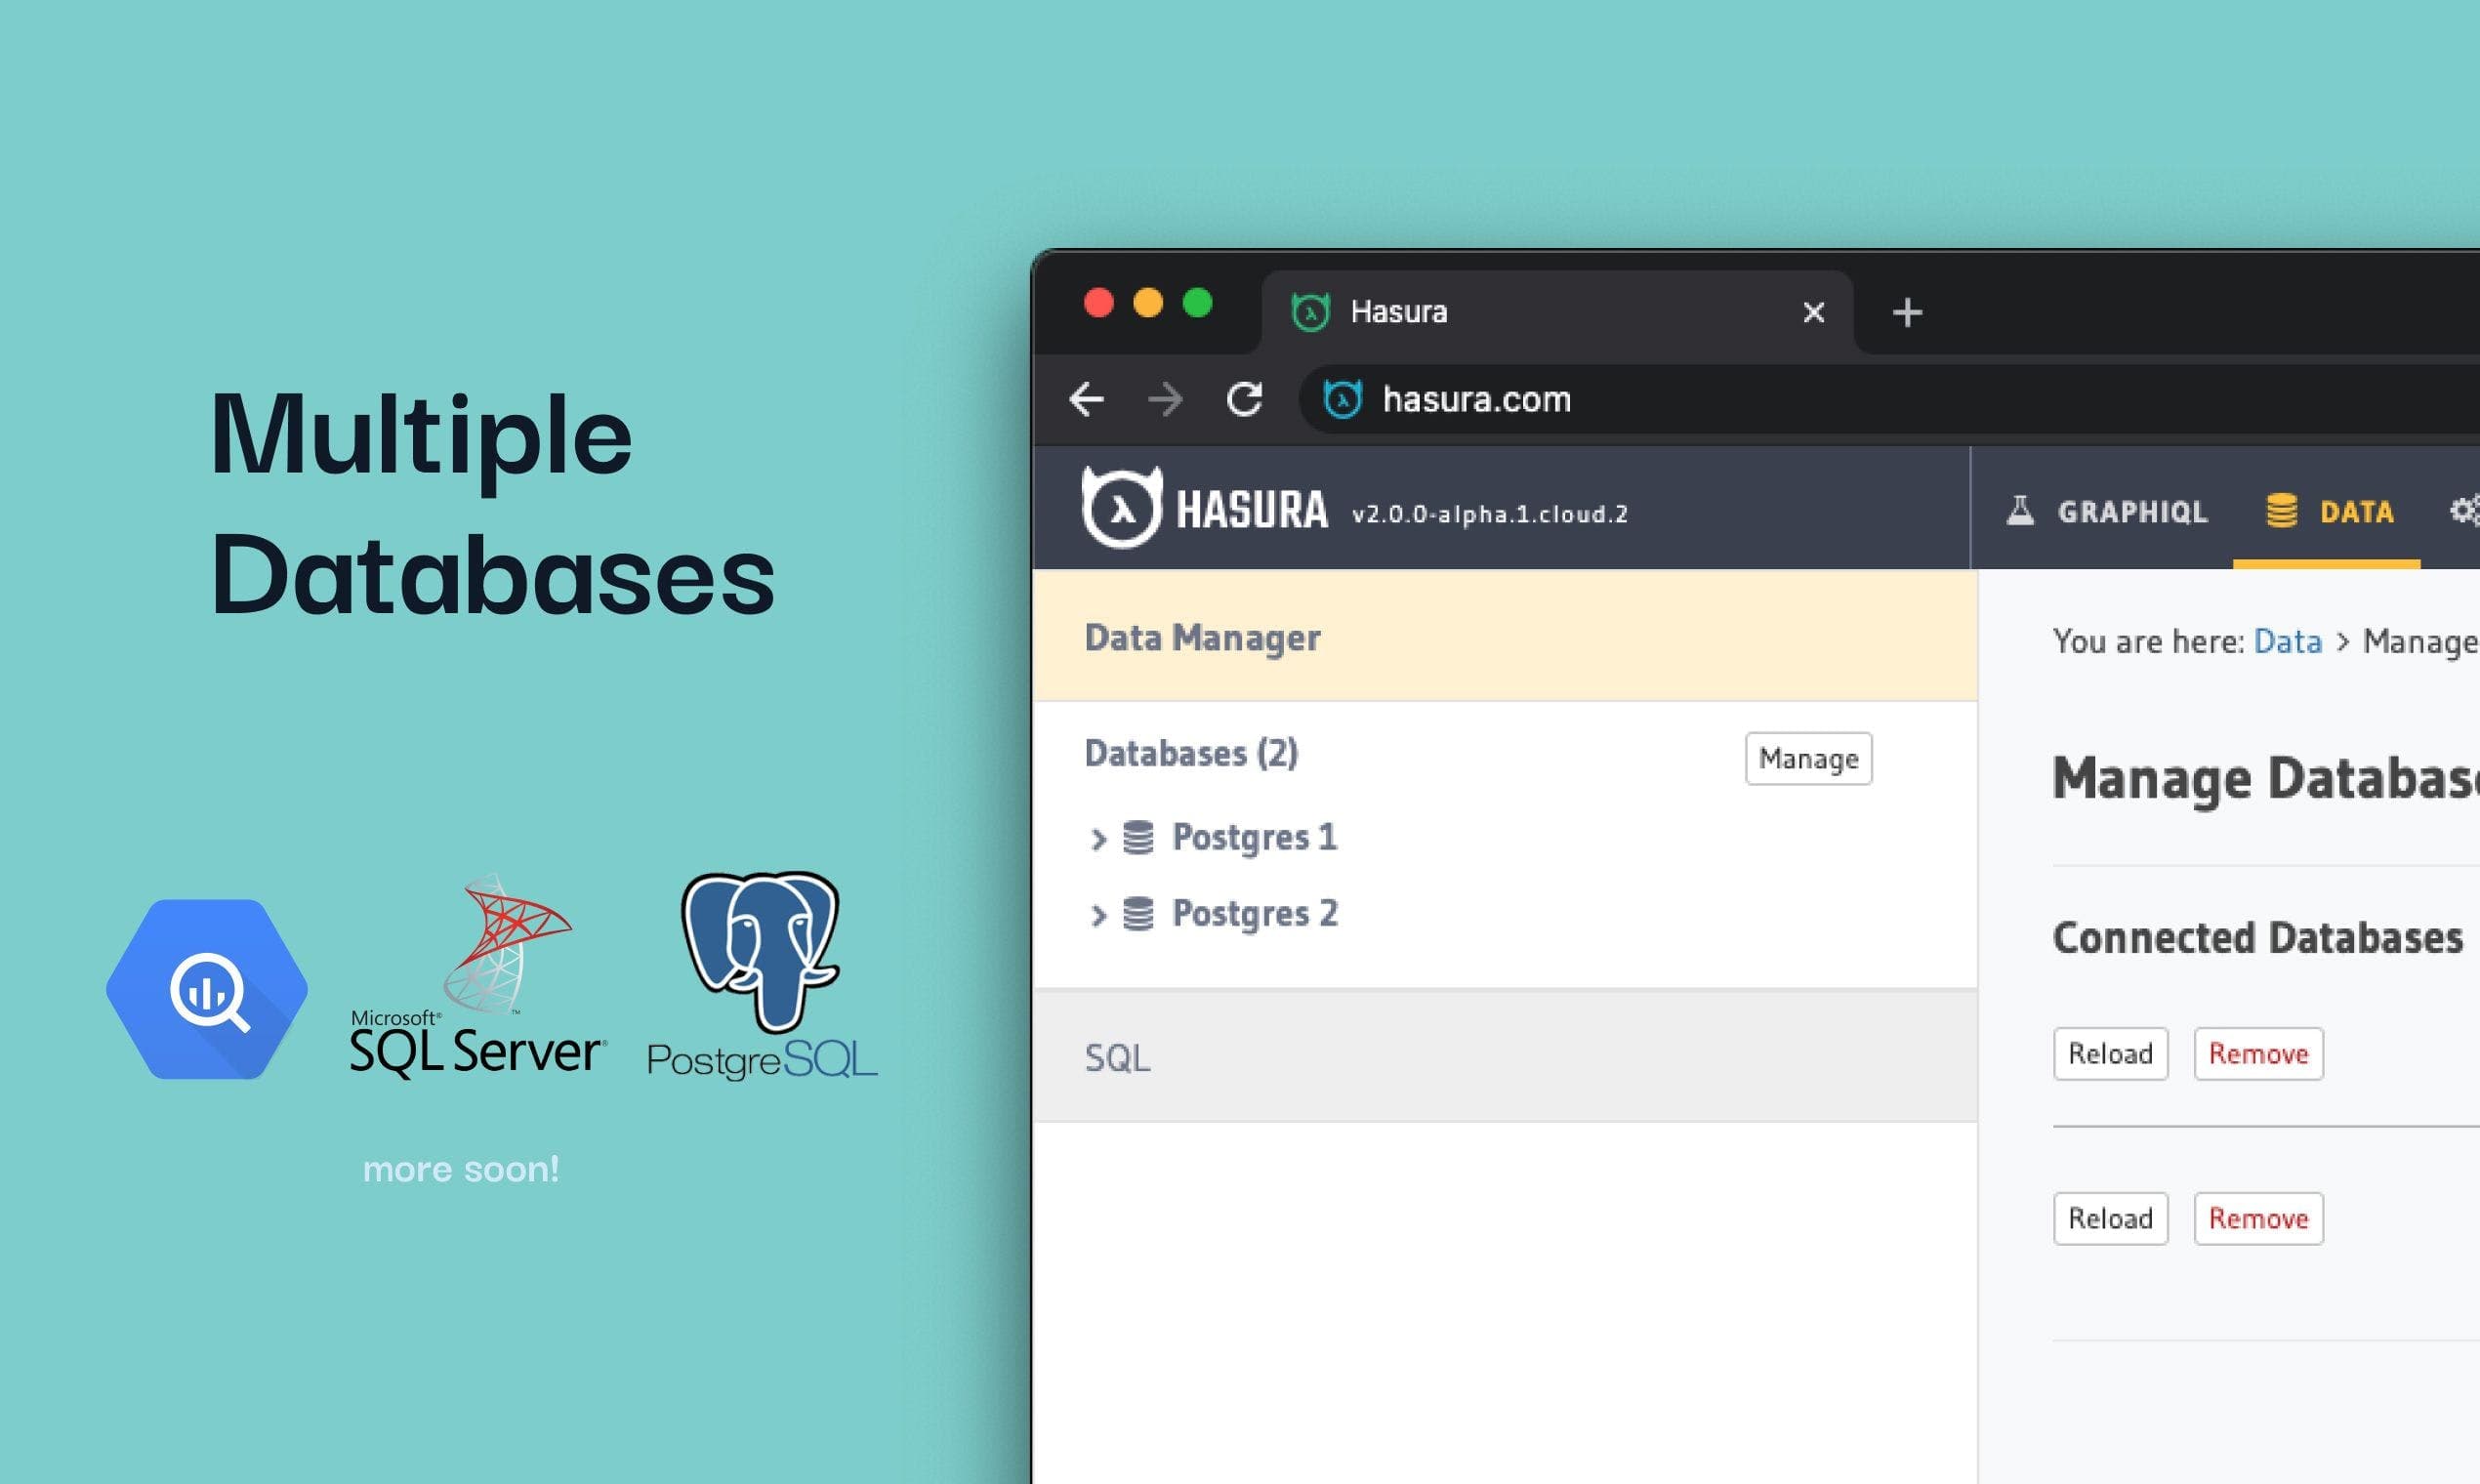
El flujo normal encaja con equipos que guardan datos en Postgres, MySQL, SQL Server, Snowflake, BigQuery u Oracle y quieren una API sin escribir un resolver para cada tabla. Hasura se encarga de los filtros, la paginación, el orden, las agregaciones y la autorización sobre esas fuentes, y tú añades las relaciones en los metadatos en lugar de en código. Eso abre cosas que a mano cuestan más. Los permisos a nivel de campo y de entidad viven dentro del motor, así que las reglas de acceso se quedan en un solo sitio. La API también habla Relay para clientes basados en conexiones y admite versionado de API y compilaciones con hash para cambios de esquema seguros.
Hay costes que sopesar. DDN funciona como producto en la nube gestionado, y sacarle partido implica aprender su modelo de metadatos y su CLI, lo que supone un salto frente a un cliente SQL normal. El precio cuenta modelos activos, no asientos, así que un esquema grande con muchos modelos consultados puede disparar la factura. El motor en Rust es rápido, pero la curva de aprendizaje y el despliegue solo gestionado para DDN son los principales contrapesos.
Getting Started
- Crea una cuenta gratuita en Hasura Cloud y abre la consola
- Instala la CLI de DDN y Docker, y luego inicializa un supergrafo con
ddn supergraph init - Añade conectores de datos para cada fuente, como una base de datos Postgres o una API REST
- Modela tus datos en metadatos, define relaciones y permisos, despliega y llama al endpoint GraphQL generado
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Hasura.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores backend y full-stack
- Equipos de plataforma
- Equipos de datos en empresas grandes
- Equipos que construyen funciones de IA
Tareas
- Crear una API GraphQL
- Federar fuentes de datos
- Configurar la autorización
- Cambios de esquema seguros
- Autoalojar el motor
Casos de uso
- Una startup lanza el backend de su primera app
- Una empresa consolida el acceso
- Un equipo suma un asistente de IA
- Un cambio de esquema es arriesgado
- Una empresa regulada necesita residencia de datos
Funciones clave
Supergrafo creado a partir de metadatos
Hasura DDN es una capa de acceso a datos basada en metadatos. Describes la forma de tus datos una vez y el motor genera la API a partir de esa descripción, no de código escrito a mano. El resultado es un supergrafo que reúne muchas fuentes en un endpoint, con filtros anidados, paginación y orden, más agregaciones listas para usar. Según Hasura, el compilador y el entorno de ejecución en Rust lo hacen más rápido que el motor v2, que la empresa ya llamaba el motor GraphQL más rápido.
Conectores para bases de datos, código y API
Los conectores de datos son la forma en que DDN llega a cada fuente. Hasura ofrece conectores oficiales para PostgreSQL, Microsoft SQL Server, CockroachDB, ClickHouse, MongoDB, Snowflake y otros, además de conectores de código y API para funciones Lambda y servicios REST. Siguen la especificación abierta Native Data Connector (NDC), así que puedes crear tu propio conector y traer una fuente que el conjunto oficial no cubre. Alojar conectores de terceros y de código cuesta $0.075 por vCPU-hora y $0.0075 por GiB-hora.
API GraphQL y Relay
Cada modelo pasa a formar parte de una API GraphQL compatible con filtros, paginación y orden, más agregaciones, y la misma capa expone una API Relay para clientes basados en conexiones. Los filtros anidados, las agregaciones anidadas, la paginación anidada y el orden anidado vienen de serie, lo que reduce las idas y vueltas que necesita un cliente. El plan gratuito ya incluye estas funciones de API sin límite de peticiones al mes.
Autorización detallada
Los permisos funcionan dentro del motor en dos niveles. Las reglas a nivel de campo controlan qué columnas puede leer o escribir un rol, y las reglas a nivel de entidad controlan qué filas se ven. Defines la lógica de forma declarativa en los metadatos, así que la tabla, vista o función delante de cada campo de la API queda protegida igual en todas partes. Para equipos con requisitos de acceso estrictos, una sola capa de autorización elimina la deriva que aparece cuando cada servicio impone sus propias reglas.
Colaboración federada y CI/CD multi-repositorio
El plan Advanced añade colaboración federada y CI/CD multi-repositorio, para que varios equipos trabajen en subgrafos independientes y los unan en un supergrafo. La detección de cambios incompatibles, las compilaciones inmutables y las URL de compilación permiten probar un cambio aislado antes de que llegue a producción. El registro de esquemas y el registro de cambios dejan constancia de qué cambió y cuándo, algo que importa cuando más de un equipo es dueño de la API.
Observabilidad y analíticas de uso
Las trazas, las métricas de rendimiento de la API y las estadísticas de uso de modelos y campos forman parte de la consola. El plan gratuito guarda trazas y métricas durante 15 minutos, mientras que los planes de pago amplían la retención a 30 días. Las estadísticas de uso de modelos y campos llegan con los planes de pago y muestran qué partes del esquema se usan de verdad, lo que ayuda a decidir qué conservar. El escalado automático, el arranque sin espera y una red global de borde con enrutamiento geográfico vienen en todos los planes.
Autoalojamiento y desarrollo local
No todo tiene que correr en la nube de Hasura. Puedes autoalojar el motor GraphQL Engine v3, ejecutar las mismas herramientas en local con Docker y desarrollar contra un supergrafo en tu máquina antes de desplegar. La CLI de DDN se encarga de la inicialización, la configuración de conectores y el despliegue en un solo flujo. Eso importa a los equipos que necesitan mantener datos sensibles en su propia infraestructura sin renunciar a las herramientas gestionadas.
PromptQL para el acceso a datos con IA
PromptQL es la capa de IA de Hasura para trabajar con el supergrafo. En vez de codificar consultas SQL o GraphQL a mano, haces preguntas en lenguaje natural y PromptQL planifica y ejecuta las consultas necesarias para responderlas. Está construida sobre la misma capa de acceso a datos, así que los permisos y las relaciones que ya definiste siguen aplicándose. Para equipos que suman un asistente o una app de datos, esto convierte el supergrafo en algo que un sistema de IA puede llamar directamente.
Ventajas y desventajas
Ventajas
- Un supergrafo basado en metadatos convierte muchas fuentes en un endpoint GraphQL sin resolvers escritos a mano
- Los conectores oficiales y de la comunidad cubren las bases de datos principales, además de código y API REST mediante la especificación abierta NDC
- La autorización vive en el motor a nivel de campo y de entidad, así que las reglas están en un solo sitio en lugar de en cada servicio
- El CI/CD con detección de cambios incompatibles y compilaciones inmutables hace más seguro publicar cambios de esquema
- Un plan gratuito cubre peticiones ilimitadas y las funciones básicas de API, así que los proyectos pequeños empiezan sin pagar
Desventajas
- DDN es un producto gestionado con una curva de aprendizaje real, y el modelo de metadatos y la CLI llevan tiempo
- El precio cuenta modelos activos en lugar de asientos, así que un esquema grande con muchos modelos consultados encarece la factura rápido
- Alojar conectores de terceros y de código se factura por hora, y eso suma en servicios siempre activos
- El autoalojamiento usa el motor GraphQL Engine v3, así que los equipos que quieren la experiencia completa de DDN siguen en la nube de Hasura
Preguntas frecuentes
Hasura es una capa de acceso a datos que convierte bases de datos, código y API en una sola API GraphQL. Los equipos la usan para montar backends de aplicaciones, federar datos de muchas fuentes y aplicar permisos en un solo sitio, sin escribir resolvers para cada tabla.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Hasura.
Alternativas a Hasura

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.