
Helicone
Helicone, Inc. · Programación
Helicone es una plataforma de observabilidad de LLM de código abierto y un gateway de IA. Con cambiar una URL base registras cada prompt, mides el gasto y enrutas más de 100 modelos.
Acerca de Helicone
About
Qué es Helicone
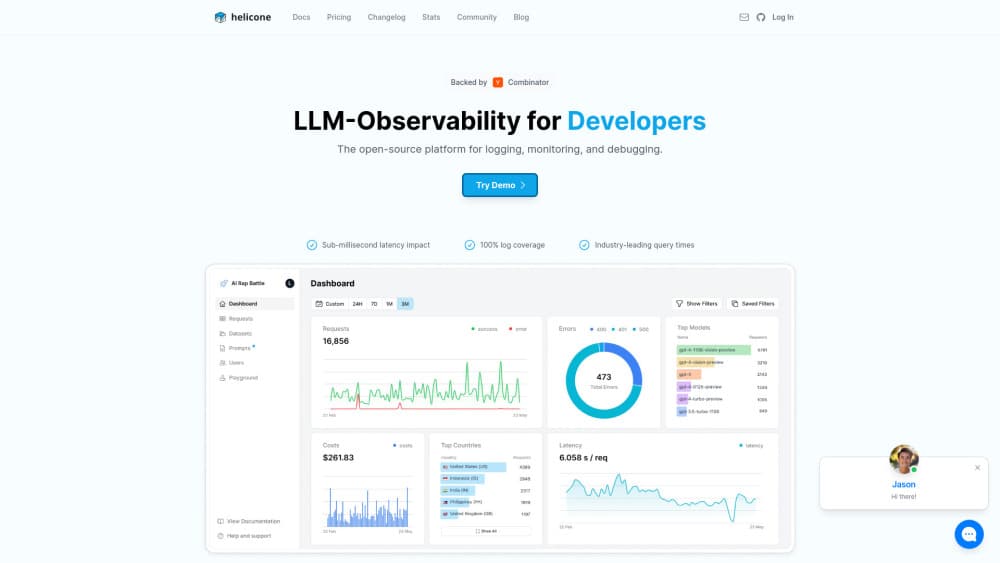
Helicone se coloca entre tu aplicación y el proveedor del modelo. Apuntas el SDK de OpenAI a la dirección del gateway, o añades la URL del proxy a las llamadas que ya haces, y cada petición aparece en un panel con el prompt, la respuesta, los tokens, el coste y la latencia.
Así respondes preguntas que llegan una semana después del lanzamiento. Por qué el chat de un cliente cuesta 40 céntimos. Qué prompt rompió la salida en JSON. Si la lentitud viene de tu servidor o del proveedor. Los registros de solicitudes siguen siendo consultables y puedes agruparlos por usuario, sesión o cualquier propiedad propia.
El proyecto es de código abierto con licencia Apache 2.0 y tiene una vía autoalojada para equipos que no quieren enviar prompts a un tercero. Dos límites marcan para quién resulta útil. Necesitas acceso al código que llama al modelo, porque la instalación consiste en cambiar una URL base y añadir una cabecera. La parte de evaluación es más ligera que la de las plataformas dedicadas, así que quien hace experimentos a gran escala suele mantener una segunda herramienta.
Primeros pasos
- Crea la cuenta gratuita y genera una clave de API en los ajustes.
- Apunta tu cliente de OpenAI al gateway de Helicone, o manda las llamadas actuales por la URL del proxy con una cabecera Helicone-Auth.
- Lanza una petición y abre la pestaña de solicitudes; el registro aparece en segundos.
- Etiqueta las llamadas con propiedades propias como el ID de usuario o el plan, para separar el gasto después.
- Configura una alerta de coste o de errores e invita al resto del equipo.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Helicone.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Equipos de ingeniería con funciones de LLM en producción
- Desarrolladores independientes y startups pequeñas
- Equipos de plataforma y DevOps
- Equipos con reglas de datos
Tareas
- Depurar una respuesta mala
- Vigilar el gasto
- Cambiar de proveedor
- Comparar prompts
- Auditar el uso
Casos de uso
- Un chatbot que se encareció tras el lanzamiento
- Un prototipo que esta semana necesita probar tres modelos
- Un entorno regulado
Funciones clave
Integración en una línea
La instalación es un cambio de URL base y una clave de API, así que un cliente existente de OpenAI, Anthropic, Azure o LiteLLM conserva la forma de su código. No hay nada que instalar en el servidor ni ningún agente que ejecutar, y por eso los equipos ven registros la misma tarde en que se dan de alta. La vía del proxy sirve para cualquier lenguaje que pueda enviar una petición HTTP.
Registros de solicitudes y trazas
Cada entrada guarda el prompt completo, la respuesta del modelo, los tokens, la latencia y el coste calculado. Puedes filtrar por modelo, estado, rango de fechas o propiedad propia, y luego abrir una sola petición para ver dónde se fue el tiempo. El registro de prompts a este nivel convierte una queja vaga en una línea de texto concreta que puedes editar.
Gateway de IA con caché y alternativas
El gateway de IA es un endpoint compatible con OpenAI que cubre más de 100 modelos de OpenAI, Anthropic, Google, Vertex, Groq y otros proveedores. Añade caché de respuestas, límites de peticiones por clave y alternativas automáticas cuando un proveedor falla, y los créditos se facturan al precio del proveedor sin recargo. También puedes usar tus propias claves si prefieres separar la facturación.
Analítica de usuarios y sesiones
Las propiedades propias te dejan pegar a una petición un ID de usuario, un plan, el nombre de una función o cualquier otra etiqueta. Las sesiones agrupan después una conversación de varios turnos en una sola vista, así ves el coste y la longitud de un recorrido real. Para un equipo de soporte, esa es la diferencia entre «el bot va lento» y «esta cuenta provoca una llamada de herramienta de 12 segundos cada vez».
Playground y gestión de prompts
El playground lanza prompts contra varios modelos en paralelo y muestra los ajustes de razonamiento en los modelos que los exponen. Los prompts se guardan, se versionan y se reutilizan desde el código, y las salidas se pueden puntuar para juzgar un cambio por sus resultados y no por la intuición. Es la forma rápida de probar un modelo más barato antes de mandarle tráfico real.
Alertas, informes y HQL
Las alertas saltan con umbrales de coste, tasa de errores o latencia, y los informes programados envían un resumen al correo o a Slack. HQL, el lenguaje de consulta integrado, resuelve lo que los filtros del panel no expresan, como el coste por usuario en los últimos 30 días. Los resultados se exportan o se llevan a tu almacén mediante la API.
Código abierto y autoalojamiento
El código es público con licencia Apache 2.0, con miles de estrellas en GitHub y un ritmo de versiones constante. Puedes ejecutar todo el stack en tu propia nube con Docker, algo que pesa cuando los prompts llevan datos de clientes que el departamento legal no deja salir. La versión alojada y la autoalojada comparten panel y API.
Ventajas y desventajas
Ventajas
- Un cambio de URL base arranca el registro, sin reescribir el SDK ni montar un proyecto de migración.
- El gateway cubre más de 100 modelos al precio del proveedor, sin recargo, con caché y alternativas en la misma clave.
- Código abierto bajo Apache 2.0, con una vía autoalojada para equipos sujetos a reglas de datos.
- El plan gratuito sirve de verdad: 10.000 peticiones al mes, 1 GB de almacenamiento y ninguna tarjeta.
- Coste, latencia y errores quedan en una pantalla por petición, por usuario y por sesión, y te ahorran la hoja de cálculo.
Desventajas
- Está pensado para desarrolladores. Sin acceso al código que llama al modelo, el panel no tiene nada que mostrar.
- Las funciones de evaluación y de conjuntos de datos son más flojas que en plataformas dedicadas, así que un seguimiento serio de experimentos pide una segunda herramienta.
- Pro arranca en 79 $/mes y el cobro por uso de peticiones y almacenamiento hace difícil predecir la factura cuando crece el tráfico.
- El plan gratuito guarda los registros 7 días y 1 GB, así que cualquier histórico a largo plazo exige un plan de pago.
Preguntas frecuentes
Registra y analiza las llamadas que tu aplicación hace a los proveedores de LLM. Obtienes registros de solicitudes con prompts, respuestas, tokens, coste y latencia, además de un gateway que puede enrutar esas llamadas a más de 100 modelos.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Helicone.
Alternativas a Helicone

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.