

Hopscotch AI
Hopscotch Labs · Programación · Productividad · Negocios
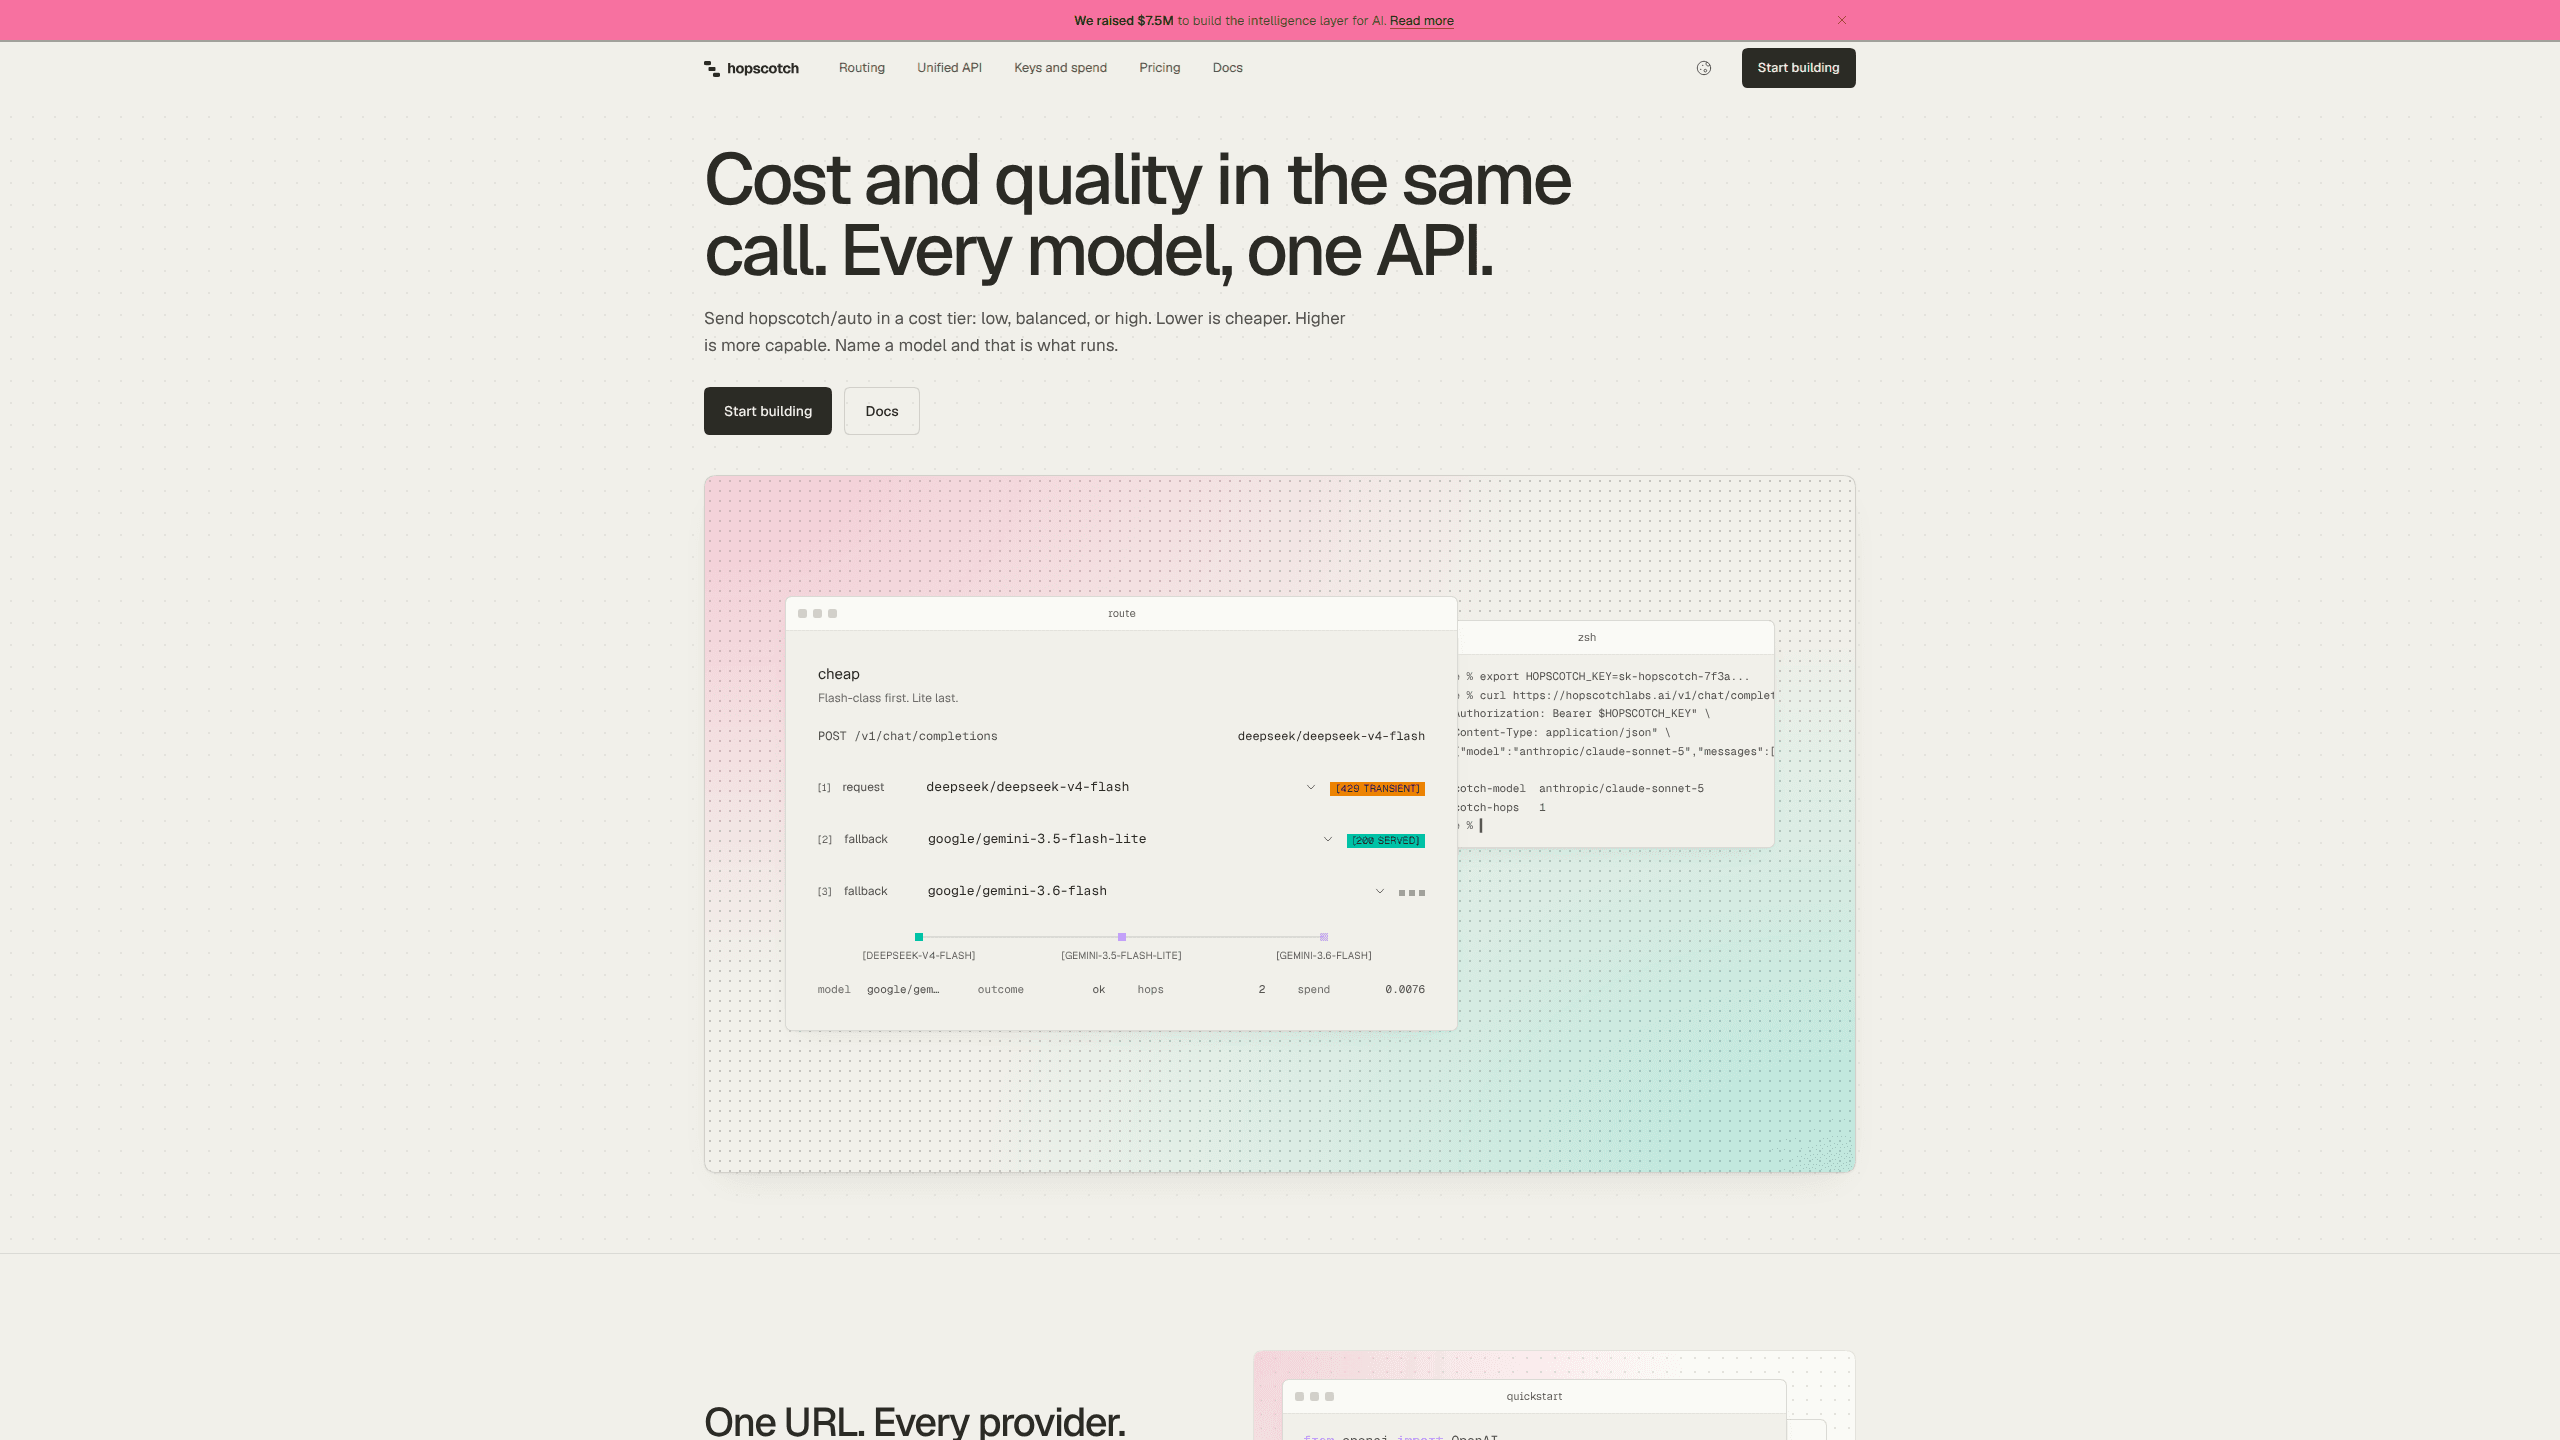
Hopscotch AI es un enrutador LLM compatible con OpenAI. Una sola clave da acceso a más de 500 modelos al precio de lista, sin recargo por token, con límites de gasto y registro de costes.
Acerca de Hopscotch AI
About
Qué es Hopscotch AI
Hopscotch AI es una pasarela de Hopscotch Labs que se coloca entre tu código y los proveedores de modelos. Conservas el SDK de OpenAI, cambias la URL base a api.hopscotchlabs.ai y envías un identificador como anthropic/claude-sonnet-5-5. Hopscotch mantiene las cuentas de los proveedores y descuenta cada petición de un saldo prepago.
El producto ataca el trabajo de contabilidad y de fiabilidad que aparece cuando una aplicación habla con más de un modelo. Cinco paneles de proveedor, cinco facturas y cinco rotaciones de clave se reducen a un saldo, un registro de actividad y un único sitio donde poner límites. Pagas la tarifa publicada de cada proveedor y Hopscotch no añade nada mientras esa comisión siga en el 0%.
Hay tres límites que conviene conocer antes de registrarte. El crédito es prepago, así que un espacio de trabajo con saldo cero rechaza las peticiones. Las funciones que corren en los servidores del proveedor, como la búsqueda web, el audio y las herramientas alojadas, no pasan por la pasarela. Los embeddings tampoco están disponibles todavía. Si tu proyecto depende de alguna de ellas, necesitarás además una clave directa del proveedor.
Primeros pasos
- Crea una cuenta en platform.hopscotchlabs.ai y verifica tu correo.
- Compra crédito en la pantalla de facturación. El mínimo son 5 dólares y la recarga automática repone el saldo cuando baja de la cifra que marques.
- Genera una clave de API en la pantalla de claves. Solo se muestra una vez y se guarda como hash, así que cópiala antes de salir.
- Apunta tu cliente de OpenAI a https://api.hopscotchlabs.ai/v1 y usa la clave de Hopscotch. No cambia nada más del código.
- Lanza una petición con un identificador que lleve el proveedor delante y revisa en el registro de actividad sus tokens, su coste y su latencia.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Hopscotch AI.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores independientes
- Equipos de producto que trabajan con varios modelos
- Responsables de ingeniería con un presupuesto que defender
Tareas
- Probar el mismo prompt en varios modelos
- Unificar integraciones de proveedor
- Poner techo a un agente autónomo
- Mantener una demo en pie durante una caída
Casos de uso
- Publicar la primera función con LLM y poco presupuesto
- Dar una clave a un colaborador externo sin ceder la cuenta
- Revisar cuánto costó una función la semana pasada
Funciones clave
Una clave para más de 500 modelos
Los identificadores se escriben proveedor/modelo, así que openai/gpt-6.1-sol y anthropic/claude-sonnet-5-5 llegan por la misma API multimodelo y tiran del mismo saldo. Un nombre suelto sin proveedor se rechaza en lugar de adivinarse. El catálogo está vivo: los modelos entran y salen al ritmo de cada proveedor, no de una lista que Hopscotch mantenga a mano.
URL base compatible con OpenAI
Cambian tres ajustes: URL base, clave de API y nombre del modelo. El código del SDK de OpenAI para chat completions sigue funcionando, y la pasarela también atiende el formato Responses, el endpoint antiguo de completions y el protocolo Messages de Anthropic para sus SDK. Streaming, llamadas a herramientas, salidas estructuradas, imágenes de entrada y tokens de razonamiento pasan siempre que el modelo elegido los soporte.
Límites de gasto en tres niveles
Puedes poner techo a una clave, a una persona o a todo el espacio de trabajo, y fijar cuánto puede gastar la cuenta por minuto, 50 dólares por defecto. Las peticiones que superan un límite se rechazan. El propietario también puede congelar todo el gasto con un interruptor, algo que se agradece cuando un agente entra en bucle y prefieres pararlo antes que depurarlo a las tres de la mañana.
Perfiles de enrutamiento con respaldos ordenados
Un perfil de enrutamiento nombra el modelo principal y los respaldos en el orden que tú decidas. Hopscotch reintenta primero, después baja por la lista y, en las peticiones de chat, hace un último intento con otro proveedor. Los respaldos de modelos nunca sustituyen por uno que no hayas nombrado.
Claves propias de proveedor
Usar tus claves propias es una función del plan Growth en adelante. Añades una credencial de OpenAI o de Anthropic que ya pagas y las peticiones de ese proveedor corren por tu cuenta, con la factura en tu proveedor. Hopscotch no cobra esas llamadas y mantiene sus límites y registros. Si tu clave falla, no se cambia en silencio a la compartida.
Coste por petición y registro de actividad
Cada petición queda registrada con modelo, proveedor, tokens, coste, velocidad y resultado. Tu código puede pedir las mismas cifras con el endpoint de consulta de uso, así que un panel de costes no necesita otra tubería de datos. Las peticiones fallidas no se cobran.
Guardrails y retención cero de datos
Los guardrails se aplican por clave y cubren un tope de gasto, una regla de retención y comprobaciones del prompt antes de que el modelo lo vea. La retención cero es el comportamiento por defecto para prompts y respuestas, y el registro conserva solo los metadatos que los rodean.
Ventajas y desventajas
Ventajas
- El precio por token coincide con la tarifa de lista de cada proveedor y la comisión de la plataforma está hoy en el 0%.
- Hay límites por clave, por compañero y por espacio de trabajo, con un techo de 50 dólares por minuto en la cuenta.
- Migrar es cambiar la URL base y el nombre del modelo, así que el código actual del SDK de OpenAI sigue corriendo.
- Los respaldos de modelos se ordenan en un perfil de enrutamiento en vez de escribirse dentro de la lógica de la aplicación.
- Los prompts y las respuestas no se guardan por defecto y las peticiones fallidas no se facturan.
Desventajas
- El crédito es prepago, así que cada espacio de trabajo nuevo necesita una recarga antes de la primera petición.
- Las funciones alojadas en el proveedor, como búsqueda web, audio y herramientas, no atraviesan la pasarela.
- Los embeddings aún no se sirven, así que un pipeline de recuperación sigue necesitando una integración directa.
- Los pases con descuento son una oferta limitada a los primeros 1.000 usuarios, y cada asiento lleva topes de uso cada 5 horas y cada semana.
Preguntas frecuentes
No. Pagas la tarifa de lista del proveedor por token y la comisión de la plataforma está en el 0%, así que 100 dólares compran 100 dólares de crédito gastable.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Hopscotch AI.
Alternativas a Hopscotch AI

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.