
Inferless
Inferless · Programación
Inferless es una plataforma GPU serverless para desplegar modelos de machine learning como endpoints de API, con arranques en frío por debajo del segundo y cobro por segundo.
Acerca de Inferless
About
Qué es Inferless
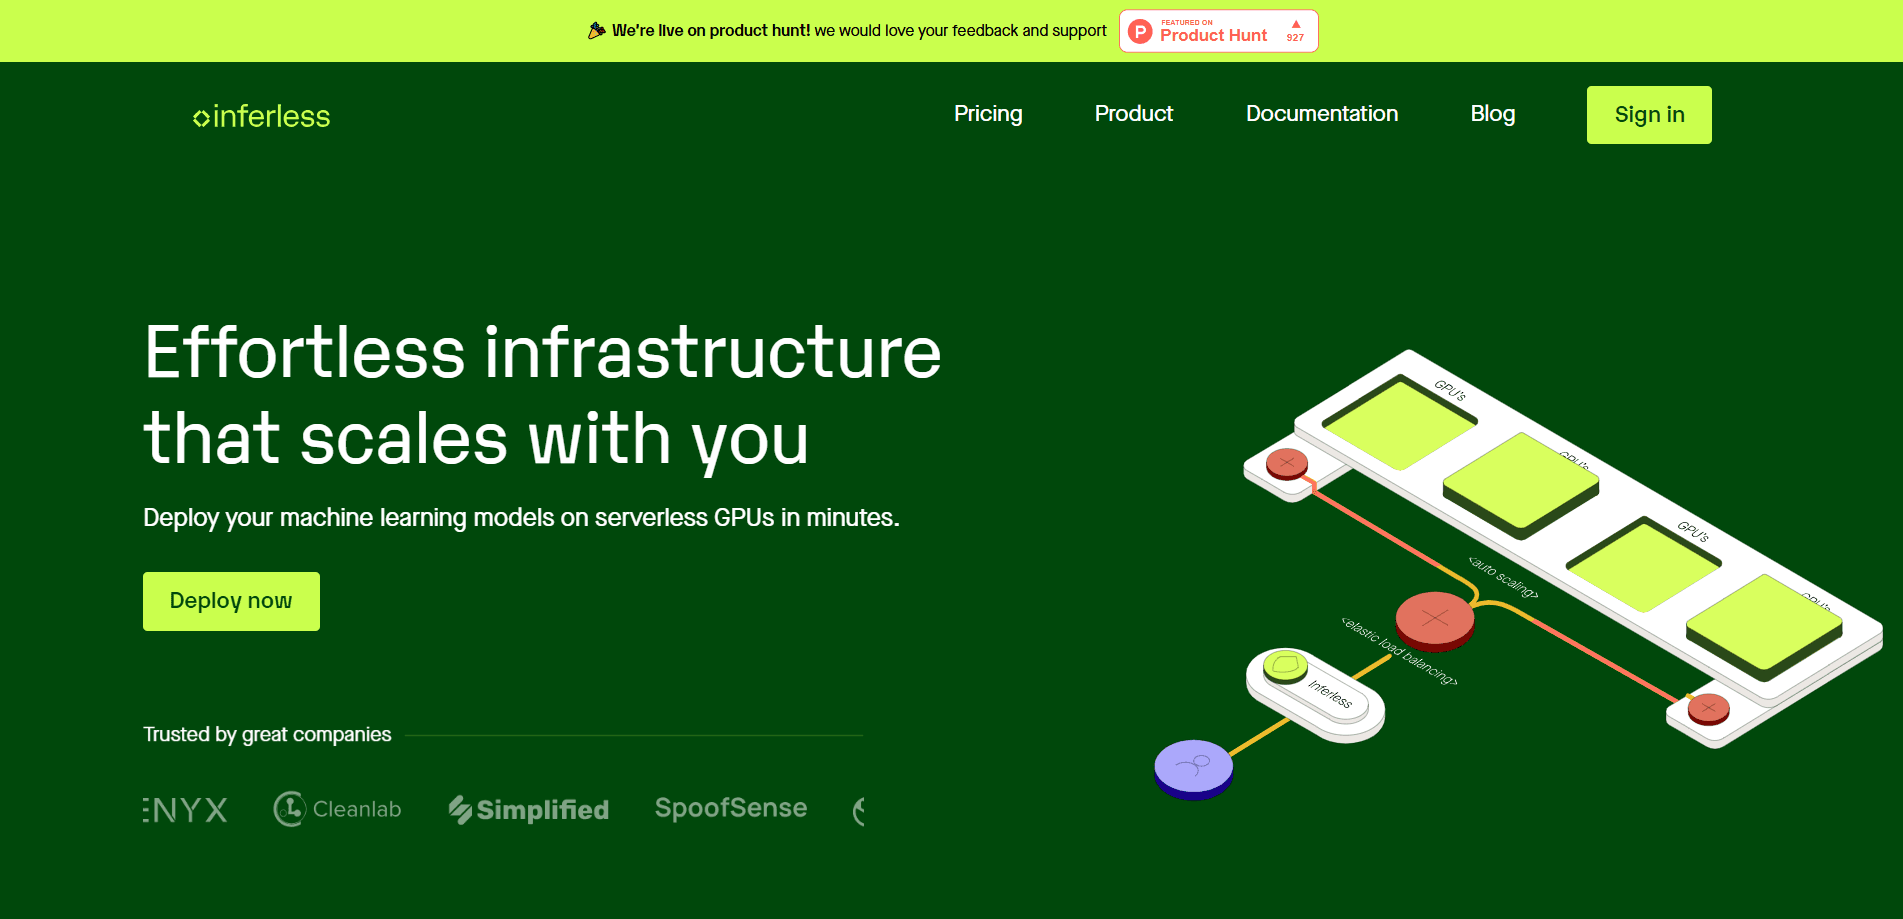
Inferless convierte un modelo de machine learning ya entrenado en un endpoint de API activo sin que tengas que gestionar ninguna GPU. Tú aportas el modelo y la plataforma se encarga del aprovisionamiento, el escalado y toda la infraestructura que hay debajo. Está pensada para inferencia de ML, no para entrenamiento. La promesa es directa: te saltas la configuración del clúster y consigues un endpoint al que tu aplicación puede llamar.
El problema que ataca es el coste y el esfuerzo. Ejecutar un modelo suele implicar alquilar una GPU las 24 horas, aunque nadie envíe peticiones. Inferless cobra por segundo y baja a cero cuando el tráfico se detiene, así que pagas solo por el cómputo que usas de verdad. Se apoya en un motor de orquestación propio y una capa de almacenamiento para mantener bajos los arranques en frío, algo que importa cuando un modelo tiene que despertar antes de responder.
Los límites son prácticos. Esto es una herramienta para desarrolladores, no una app sin código, así que necesitas empaquetar bien el modelo y sus dependencias. El precio va por uso, barato con poco volumen pero más difícil de prever que una cuota fija. Además, algunos flujos, como los entrenamientos largos, encajan mejor en una máquina GPU dedicada que en un endpoint serverless creado para inferencia.
Primeros pasos
- Crea una cuenta en Inferless y conecta una fuente de modelo como Hugging Face, GitHub o una imagen Docker
- Configura el entorno, los paquetes y el tipo de GPU con un archivo YAML sencillo, sin escribir código de servidor
- Despliega el modelo y deja que Inferless construya el entorno y levante el endpoint
- Llama al endpoint generado desde tu aplicación y deja que el autoscaling gestione los picos de tráfico
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Inferless.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de machine learning
- Startups
- Científicos de datos
- Desarrolladores de aplicaciones
- Equipos de empresa
Tareas
- Desplegar un modelo propio
- Servir modelos de lenguaje
- Trabajos de inferencia por lotes
- Prototipar una idea
- Añadir inferencia a una app
- Compartir datos entre modelos
Casos de uso
- Una startup lanzando una función de IA
- Un científico de datos validando un modelo
- Un equipo con tráfico irregular
- Un desarrollador montando una demo
- Una empresa con modelos propios
Funciones clave
Arranques en frío por debajo del segundo
Lo más difícil de la inferencia serverless es la espera cuando un modelo dormido despierta para responder, el llamado cold start. Inferless lo ataca con un motor de orquestación propio, un router avanzado y su propia capa de almacenamiento trabajando juntos. La empresa dice que el resultado son respuestas por debajo del segundo incluso con modelos grandes, lo que mantiene práctico el modelo de bajar a cero para apps de cara al usuario. Si una función de chat o búsqueda tiene que esperar diez segundos a que cargue un modelo, el serverless deja de merecer la pena.
Escalado automático desde cero
Inferless sube y baja tu endpoint con el tráfico, desde ninguna GPU en marcha hasta cientos a la vez. El balanceador de carga interno reparte las peticiones y levanta o retira capacidad con poco trabajo extra, algo que encaja con cargas que se disparan sin avisar. No planificas la capacidad punta por adelantado ni la pagas cuando el tráfico está tranquilo.
Importación de modelos desde varias fuentes
Puedes traer modelos de Hugging Face, GitHub, AWS S3, Google Cloud Storage, Docker o la CLI de Inferless, y la plataforma hace el resto. La importación con un clic desde los repositorios que ya usan la mayoría de los equipos de ML reduce el trabajo de preparación, así que mover un modelo a producción no empieza con una tarea de transferencia de archivos. El soporte para Azure figura como próximo.
Independiente del modelo y del framework
La plataforma ejecuta modelos de PyTorch, TensorFlow y ONNX, y también acepta funciones Python personalizadas. Esa flexibilidad significa que no quedas atado a un framework ni a un formato de modelo. Configuras entornos y paquetes a medida con YAML, así que instalar librerías extra no obliga a escribir un servidor desde cero.
Soporte de GPU fraccionada
En lugar de alquilar una GPU entera para un modelo pequeño, Inferless deja que varios modelos y cargas compartan la misma GPU, con reequilibrio automático y drenaje de nodos. También puedes usar GPU fraccionadas, así que un modelo que necesita una porción de una A100 no te obliga a pagar la tarjeta completa. Para equipos con muchos modelos pequeños, ese reparto suele marcar la diferencia entre viable y demasiado caro.
Monitorización y CI/CD
Inferless incluye métricas de Prometheus y paneles de Grafana para seguir el uso de GPU y otras señales de salud del sistema. Las versiones nuevas del modelo se despliegan por pipelines de CI/CD, así que publicas una actualización sin reconstruir ni redesplegar la infraestructura a mano. Del mismo flujo salen endpoints listos para usar, que puedes colocar en un backend o un front end.
Ventajas y desventajas
Ventajas
- El cobro por segundo evita pagar GPU ociosas cuando el tráfico baja a cero
- Los arranques en frío por debajo del segundo hacen viable bajar a cero en apps en vivo
- La importación con un clic desde Hugging Face, GitHub, S3 y Google Cloud Storage recorta el montaje
- Independiente del framework: PyTorch, TensorFlow, ONNX y Python a medida funcionan
- El reparto de GPU fraccionada abarata ejecutar muchos modelos pequeños
Desventajas
- Es una herramienta de desarrollador, así que aún debes empaquetar el modelo y sus dependencias
- El precio por uso es barato con poco volumen pero más difícil de prever que una cuota fija
- Los entrenamientos largos no son el objetivo, ya que la plataforma está hecha para inferencia
- No hay app móvil nativa, todo pasa por la consola web y la CLI
Preguntas frecuentes
Inferless es una plataforma GPU serverless para el despliegue de modelos, y convierte modelos de machine learning propios en endpoints de API. Importas un modelo, configuras el entorno y Inferless se ocupa del hardware, el escalado y los arranques en frío.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Inferless.
Alternativas a Inferless
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.