
Kyutai TTS
Kyutai · Voz e idioma
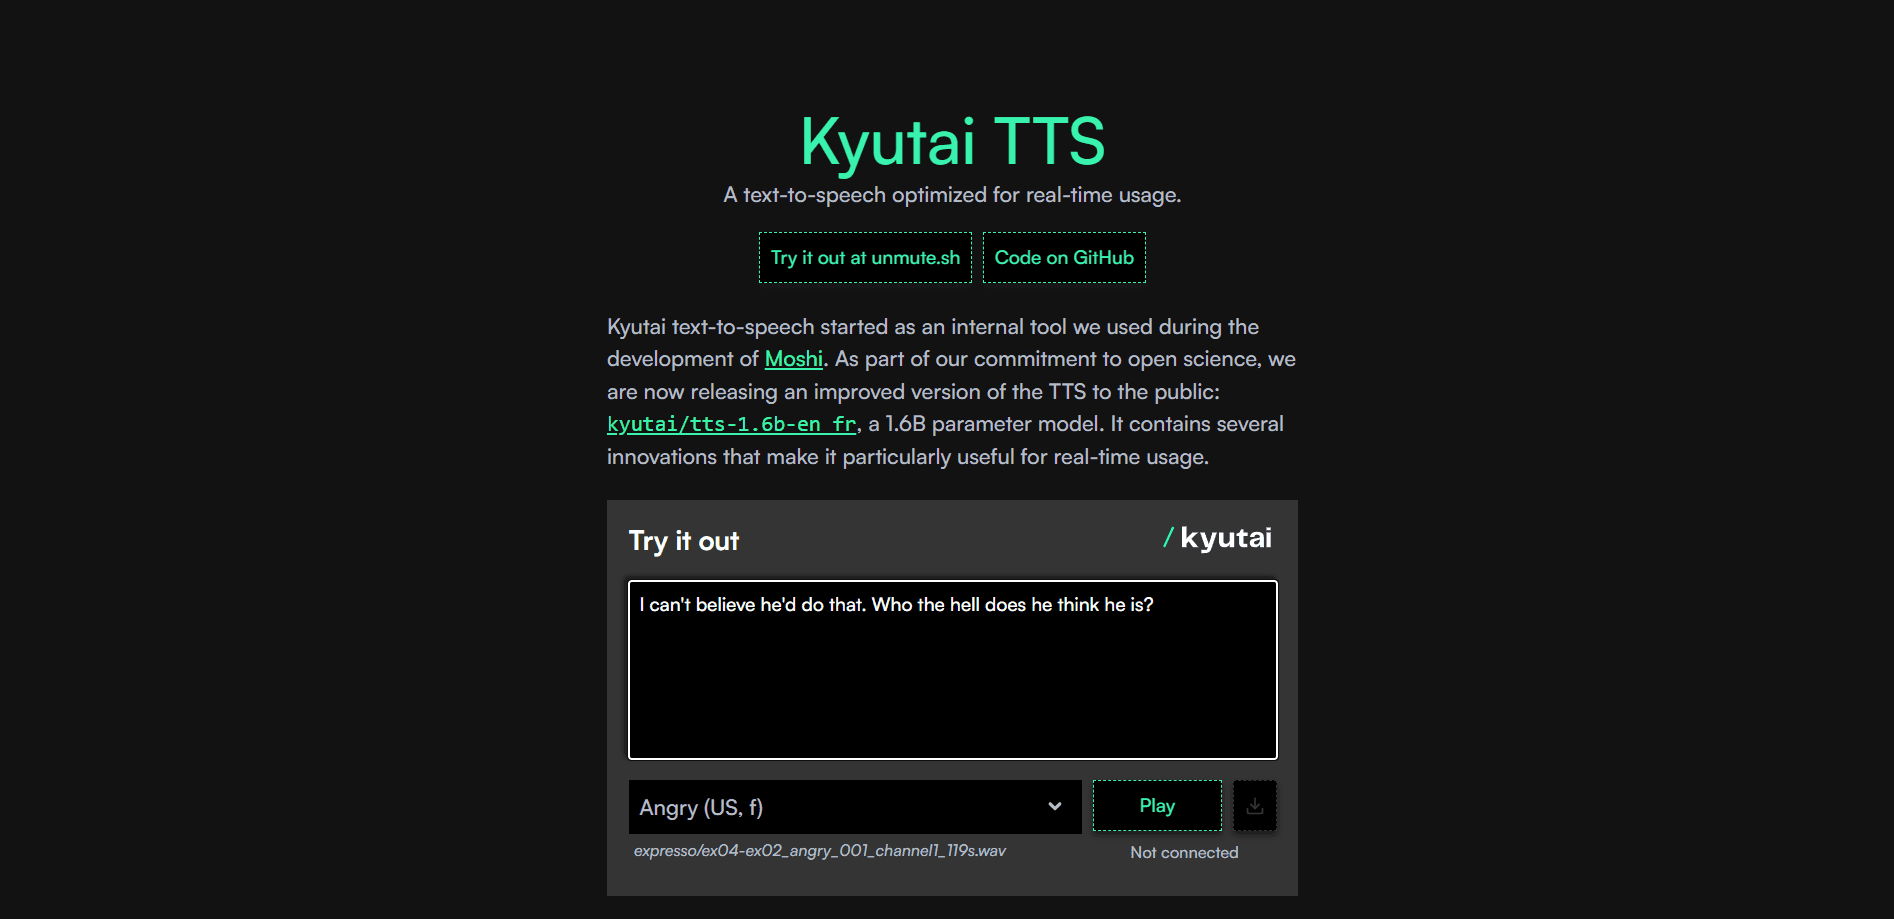
Kyutai TTS es un modelo de texto a voz en streaming y código abierto que empieza a generar audio antes de tener el texto completo, así mantiene baja la latencia en asistentes de voz y apps en tiempo real.
Acerca de Kyutai TTS
About
Qué es Kyutai TTS
Kyutai TTS es un modelo de texto a voz hecho para streaming. Lee texto en voz alta, pero no espera a que termines de escribir. Empieza a hablar en cuanto tiene las primeras palabras, y eso lo separa de los motores sin conexión que necesitan la frase entera antes de emitir sonido.
Kyutai es un laboratorio francés de ciencia abierta financiado por el grupo Iliad, el grupo CMA CM y Schmidt Sciences. El laboratorio creó Kyutai TTS 1.6B, uno de varios modelos de audio de Kyutai, para su propio trabajo con Moshi, un sistema de diálogo por voz, y luego liberó los pesos al público. Esa versión apunta a la síntesis de voz de baja latencia, algo que la mayoría de motores solo hace después de leer todo el texto. Quien busca herramientas de voz puede montar un asistente que hable, generar narración o añadir voz a una app sin pagar por carácter.
El detalle importante es cómo logra esa velocidad. Se entrenó con 2,5 millones de horas de audio público y rinde mejor en una GPU, así que no es un servicio en la nube listo para usar con un precio mensual claro. Descargas los pesos, preparas un entorno y lo ejecutas tú mismo. Hay dos versiones: el modelo en streaming de 1.6B que cubrimos aquí y el más reciente Pocket TTS, un modelo más pequeño pensado para equipos con CPU.
Primeros pasos
- Crea una cuenta gratis en Hugging Face y acepta la licencia del modelo en la página de Kyutai TTS.
- Instala el paquete moshi de Python con pip, o el crate moshi-server si vas a servirlo en producción.
- Carga el checkpoint y el códec de audio Mimi en Python, luego apunta el modelo a un texto de entrada.
- Genera audio por bloques para reproducirlo en streaming, o pásale un archivo para una salida sin conexión.
- Elige una voz lista del repositorio tts-voices o usa tu propio embedding de voz.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Kyutai TTS.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que crean asistentes de voz
- Investigadores y estudiantes
- Creadores con presupuesto ajustado
Tareas
- Respuestas habladas en tiempo real
- Clonación de voz para una identidad fija
- Generación de narración por lotes
Casos de uso
- Alimentar un agente de voz conversacional
- Añadir accesibilidad a una app
- Prototipar un producto multilingüe
Funciones clave
Salida en streaming que supera al TTS sin conexión
Kyutai TTS empieza a hablar en cuanto recibe las primeras palabras de un texto. Los motores sin conexión esperan al texto completo, lo que suma segundos de retraso. En un asistente de voz, esa diferencia separa una conversación fluida de una pausa incómoda.
Basado en delayed streams modeling
El modelo nace de la investigación de Kyutai sobre delayed streams modeling, un método para tareas en streaming que van entre texto y voz. Usa la misma arquitectura multistream que Moshi, así los flujos de texto y audio se alinean y la generación sale estable y rápida.
Clonación de voz mediante embeddings
Puedes darle al modelo una voz concreta si le pasas un embedding ya calculado del repositorio tts-voices. Kyutai eligió esta vía en lugar de la clonación libre por un motivo. Dice que la marca de agua se quita fácil en modelos abiertos, así que limitar la clonación a embeddings guardados es lo más seguro.
Procesamiento por lotes para mucho caudal
El modelo agrupa peticiones en lugar de atender una voz cada vez. Kyutai reporta cerca de 75x de audio generado por unidad de cómputo, y entrenó con destilación de CFG para no tener que duplicar el lote al guiar la salida.
Voz en inglés y francés
El modelo de 1.6B cubre inglés y francés de fábrica. Es un rango estrecho frente a algunos motores comerciales, pero basta para productos bilingües y mantiene el modelo lo bastante pequeño para autoalojarlo.
Varias formas de despliegue
Puedes ejecutar el modelo de tres maneras. La versión de PyTorch sirve para investigación y pruebas, el servidor en Rust aguanta tráfico de producción por websockets y una versión cuantizada corre en equipos de consumo.
Ventajas y desventajas
Ventajas
- Pesos abiertos y gratis con una licencia permisiva, así que no hay cobro por carácter.
- El diseño en streaming mantiene la latencia baja como para conversar en vivo.
- Procesa bien por lotes en una sola GPU, lo que baja el coste de atender a muchos usuarios a la vez.
- Respaldado por un artículo publicado, un cuaderno de Colab y un repositorio de voces, así que no partes de cero.
Desventajas
- No hay API alojada, así que tienes que montar y mantener el servidor por tu cuenta.
- Se recomienda una GPU, lo que descarta el hospedaje barato para una carga en tiempo real.
- Solo admite inglés y francés, así que otros idiomas requieren otro modelo.
- La clonación de voz se limita a embeddings ya calculados, lo que bloquea las imitaciones libres.
Preguntas frecuentes
Sí. Los pesos del modelo se publican bajo CC-BY 4.0, así que puedes descargarlos y ejecutarlos sin coste. Lo que pagas es el equipo donde lo corres.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Kyutai TTS.
Alternativas a Kyutai TTS

Foley
Hanamori Labs, LLC · Voz e idioma · Productividad · Asistente de IAFoley es una lista de tareas por voz que convierte una frase hablada en una tarea archivada, con el proyecto, la fecha y la hora ya puestos, y después te ayuda a organizar el día con lo que ya tienes anotado.

HireKey
HireKey · Voz e idioma · Productividad · AprendizajeHireKey es un copiloto de búsqueda de empleo con IA creado por una reclutadora de tecnología. Mide el encaje con el puesto, adapta el currículum, entrena entrevistas y ordena cada candidatura.

Fluence
Yay Software (Yannick Huchard) · Escritura · Voz e idioma · ProductividadFluence es una app para Android que lee en voz alta PDF, EPUB, archivos de Word y artículos web, sigue la frase que suena y responde preguntas sobre el texto sin salir del teléfono.