
LangWatch
LangWatch B.V. · Programación · Marketing
LangWatch es una plataforma de observabilidad de LLM de código abierto para trazar, probar y evaluar agentes de IA, con gateway de IA y gestión de prompts en el mismo sitio.
Acerca de LangWatch
What Is LangWatch
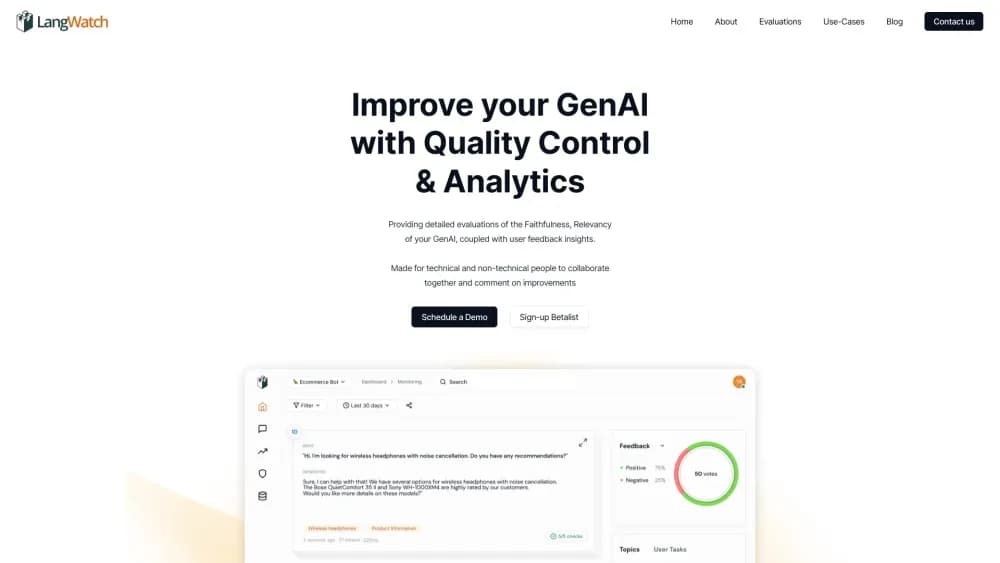
LangWatch es una plataforma de LLMOps de código abierto creada por LangWatch B.V., una empresa con sede en Ámsterdam. Cubre cuatro tareas que suelen vivir en herramientas separadas: trazabilidad de LLM, pruebas de agentes de IA, evaluación de LLM y gestión de prompts. Por encima hay un gateway de IA, así que cada llamada al modelo puede pasar por un único endpoint con un presupuesto asignado.
El proyecto se publicó como código abierto en septiembre de 2023 y su núcleo sigue bajo licencia Apache 2.0. Puedes ejecutar la plataforma en tu propia infraestructura con Docker o Helm, y LangWatch Cloud usa el mismo código. Las funciones enterprise, como la gobernanza de IA con varias fuentes y la detección de anomalías, viven en una carpeta con licencia aparte y exigen un plan de pago.
El hueco que cubre es la visibilidad. Cuando un agente llega a producción, una respuesta mala casi nunca viene con explicación. Necesitas saber qué llamada a herramienta falló, qué búsqueda volvió vacía y cuánto costó la conversación. LangWatch guarda cada paso como una traza y te deja reproducirla. La contrapartida es que hablamos de una herramienta para desarrolladores: alguien del equipo tiene que leer trazas y escribir tests, y no hay un camino sin código para un product manager que trabaje solo.
Primeros pasos
- Crea un proyecto en app.langwatch.ai. El plan Developer no pide tarjeta.
- Conecta tu aplicación con el SDK de Python o TypeScript, o apunta un exportador de OpenTelemetry al endpoint de ingesta. LangChain, LangGraph, CrewAI, Mastra y Pydantic AI envían trazas sin reescribir nada.
- Ejecuta el agente una vez y abre la vista de trazas para revisar los spans, los tokens, la latencia y la conversación completa.
- Añade un evaluador o un escenario con usuario simulado y bloquea el merge según la nota dentro del CI.
- Lleva los prompts al gestor cuando quieras versiones y pruebas A/B fuera del código.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de LangWatch.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de IA que ponen un agente en producción
- Equipos de plataforma en empresas medianas
- Responsables de ingeniería que vigilan el gasto en IA
Tareas
- Depurar una respuesta incorrecta
- Probar regresiones antes de un despliegue
- Comparar versiones de un prompt
- Auditar el uso de asistentes de código
Casos de uso
- Un agente falla en un segmento de clientes
- Un proveedor sube precios de un día para otro
- Un despliegue regulado exige autoalojamiento
Funciones clave
Trazabilidad de LLM en cualquier framework
Cada llamada al modelo, uso de herramienta, búsqueda y evaluación queda como un span dentro de una traza, con spans anidados y un grafo de ejecución para el agente. El recuento de tokens y el coste salen solos por proveedor, prompt y modelo. Las trazas se agrupan en sesiones por hilo, de modo que lees una conversación entera y no una petición suelta. También se capturan textos, imágenes y audio, algo que importa cuando el agente trabaja con capturas o notas de voz.
Pruebas de agentes con usuarios simulados
Las pruebas de agentes de IA empiezan con un escenario escrito, y un LLM hace de usuario generando mensajes realistas a partir de él. La ejecución cubre diálogo de varios turnos, no un único prompt. Un agente juez puntúa cada turno y puede marcar aprobado o suspenso en cualquier punto. La verificación de llamadas a herramientas comprueba que la herramienta correcta se activó en el momento correcto a lo largo de la conversación. Hay un visualizador para reproducir la ejecución paso a paso y pausar a mitad para anotar. Las pruebas de voz funcionan con ElevenLabs, OpenAI Realtime, Twilio, Pipecat y Gemini Live, con tiempo hasta el primer byte, latencia p50 y p95, además de ruido de fondo e interrupciones inyectadas. Los ataques adversariales usan escalada Crescendo y detección de rechazos para encontrar puntos débiles antes que un usuario.
Evaluación de LLM en experimentos y en producción
Los evaluadores incluidos cubren métricas RAGAS, alucinaciones, toxicidad, detección de PII y puntuación con LLM como juez. Puedes lanzar experimentos offline desde el SDK o desde un asistente sin código en la interfaz, y luego comparar ejecuciones por calidad, coste y latencia. Los monitores de producción puntúan el tráfico real y avisan cuando baja la calidad. La puntuación funciona sobre un hilo completo y también sobre un mensaje suelto, lo que encaja con bots de soporte y agentes de varios pasos. Los datasets se construyen desde trazas reales, se generan con IA o se suben con imágenes, y una bandeja de anotaciones recoge la revisión humana. Puedes definir un evaluador propio una vez y compartirlo entre proyectos; los mismos controles se ejecutan en línea como barreras de seguridad.
Gateway de IA con presupuestos por equipo
Un solo endpoint habla las APIs de OpenAI y Anthropic, y enruta a OpenAI, Anthropic, Google, Bedrock, Mistral o cualquier otro proveedor con tus claves. Cada cliente recibe una clave virtual con su presupuesto, definido por persona, equipo o cliente final. La empresa habla de 11 microsegundos de sobrecarga. Toda petición que pasa por ahí aterriza como traza en el mismo proyecto, así que el tráfico del gateway y el del SDK quedan juntos.
Gestión de prompts con versiones
Los prompts son objetos estructurados con mensajes, entradas y configuración, editables desde el código, la interfaz o la API. El motor de plantillas Liquid añade variables y lógica. La sincronización con GitHub deja revisar un cambio de prompt como cualquier pull request, y las etiquetas marcan las versiones de staging y producción. Un playground compara variantes entre modelos, y las pruebas A/B informan de calidad, coste y latencia por versión. Los webhooks y Slack avisan cuando cambia un prompt.
Seguimiento de asistentes de código y gobernanza de IA
Un comando, npx langwatch claude, lleva Claude Code, Codex, Copilot, Gemini CLI y opencode al mismo estándar de observación. Las sesiones muestran tokens, coste y uso de caché por ingeniero y por repositorio, lo que responde a dónde se va el gasto en IA. La parte de gobernanza de IA añade un inventario de cada herramienta y proveedor en uso, reglas de anomalías sobre la actividad y un registro de auditoría para revisiones de seguridad.
Ventajas y desventajas
Ventajas
- Núcleo de código abierto: la plataforma Apache 2.0 corre sobre tu propio ClickHouse con Docker o Helm, así que las trazas no tienen por qué salir de tu red.
- Cuatro herramientas en una cuenta: trazabilidad, pruebas, evaluación y prompts comparten las mismas trazas, y desaparece el copiar y pegar entre proveedores.
- Cobertura amplia de frameworks: LangChain, LangGraph, CrewAI, Mastra, Pydantic AI, el SDK de Vercel AI y OpenTelemetry envían trazas sin reescribir el agente.
- Plan gratuito útil: 50.000 eventos al mes, dos usuarios y 14 días de retención sin coste ni tarjeta, suficiente para un prototipo.
- El gateway mantiene el control: las claves de proveedor y los presupuestos por persona se quedan en tu cuenta, y cada llamada enrutada se traza sola.
Desventajas
- Herramienta para desarrolladores: no hay un camino de arrastrar y soltar para construir un agente, y la configuración de evaluaciones pide Python o TypeScript.
- El cobro por uso hay que vigilarlo: el plan Growth incluye 200.000 eventos y luego cobra 5 € por cada 100.000, así que un agente con muchas herramientas y búsquedas gasta eventos mucho más rápido que un chatbot simple.
- El autoalojamiento trae trabajo de operación: ClickHouse y la plataforma corren de tu parte, y las actualizaciones son tu responsabilidad salvo que pagues soporte Enterprise.
- Gobernanza y SSO quedan en Enterprise: el SSO propio, el RBAC, los registros de auditoría y el enmascarado de datos no están en Growth, lo que deja fuera a algunos equipos regulados hasta negociar.
Preguntas frecuentes
LangWatch es una plataforma de código abierto para observar, probar y evaluar aplicaciones LLM. Registra trazas de agentes, ejecuta conversaciones simuladas, puntúa la calidad de las respuestas y gestiona versiones de prompts desde un mismo panel.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con LangWatch.
Alternativas a LangWatch

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.