
Liquid Inference
Architect Financial Technologies Inc. · Programación · Productividad
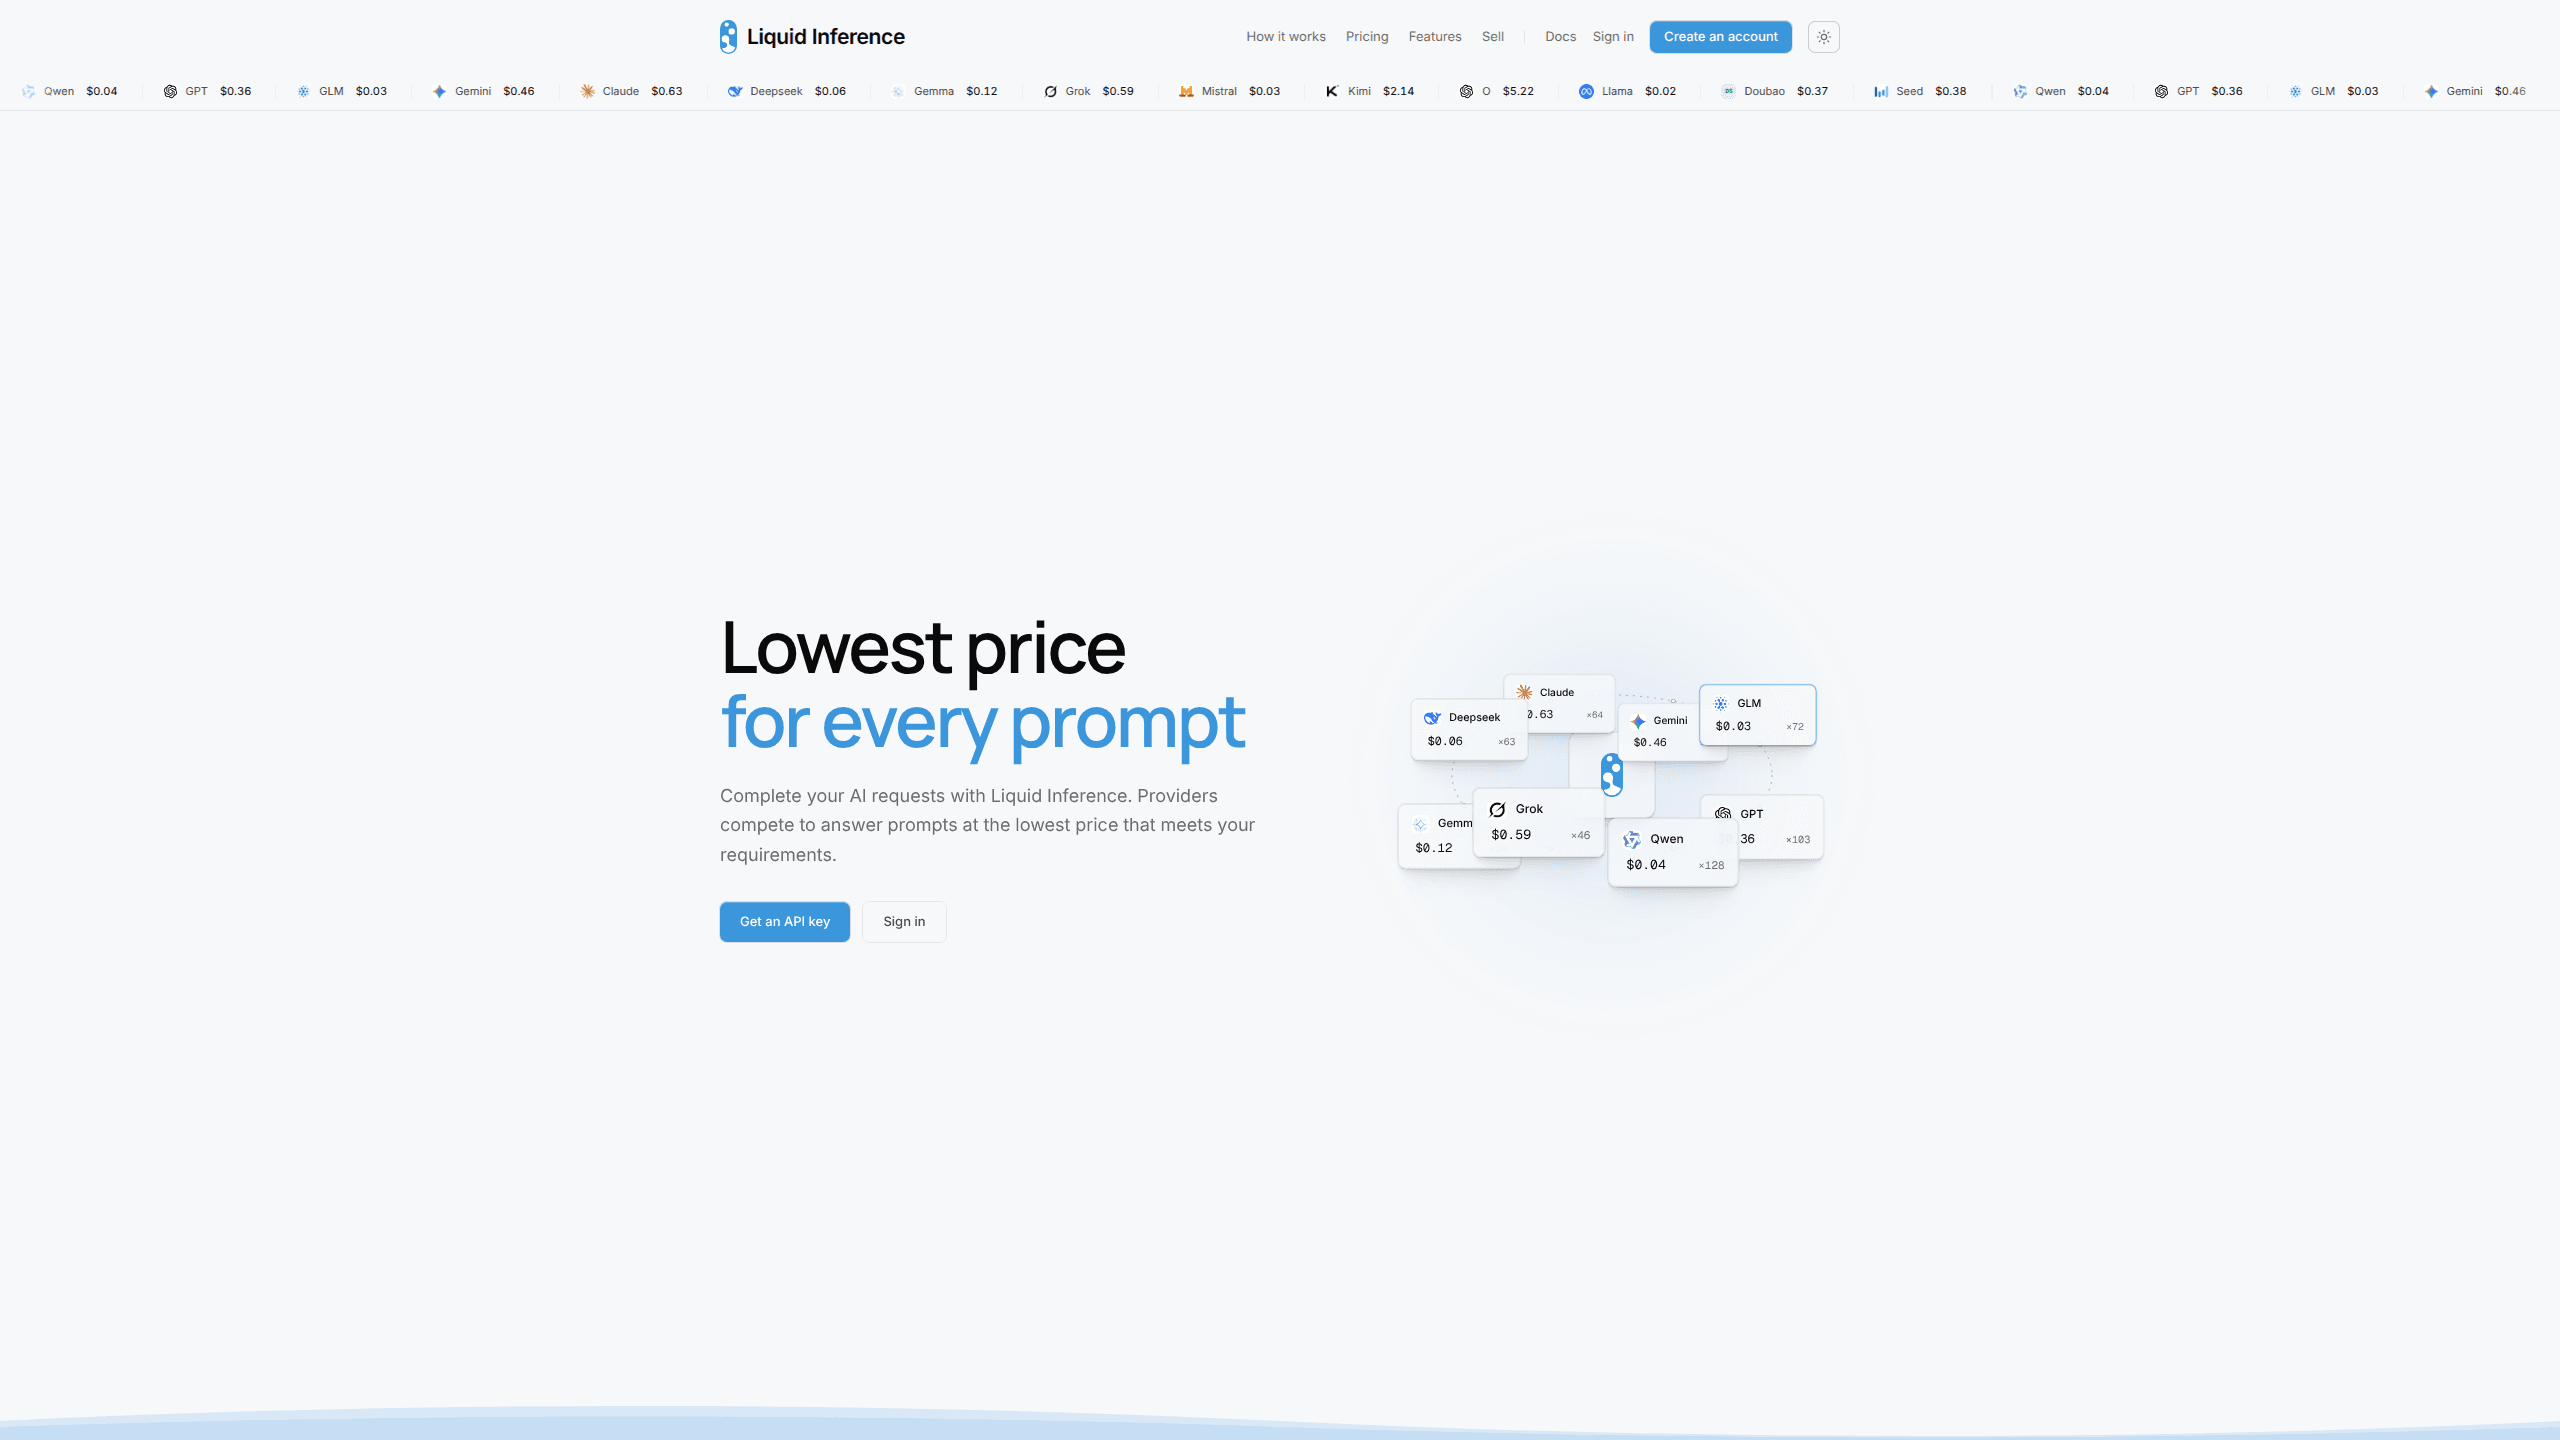
Liquid Inference es un mercado de inferencia de IA de Architect que subasta cada petición y la manda al proveedor más barato que cumpla tus condiciones.
Acerca de Liquid Inference
About
Qué es Liquid Inference
Liquid Inference es un enrutador de LLM que funciona como un mercado. Cada proveedor publica una oferta con su precio por token para los modelos que sirve, y tu petición se adjudica a la oferta más barata que cumpla tus condiciones. Se usa desde el chat del navegador o desde la API de inferencia, que acepta el formato de OpenAI y el de Anthropic. También hace de enrutador de modelos: tú eliges el nombre y el mercado decide quién lo sirve.
El problema que resuelve está en la factura, no en el modelo. Casi todos los equipos pagan la tarifa de lista de un proveedor cerrado aunque varios vendors sirvan el mismo modelo abierto. Aquí el precio máximo se fija antes del primer token, el pago por token depende de la oferta ganadora, el presupuesto que no gastas vuelve a tu saldo y cada trabajo deja un recibo con el proveedor ganador y el cargo final.
Conviene conocer los límites antes de mover una carga de trabajo. El mercado abrió en octubre de 2026, así que el número de vendedores y los modelos disponibles todavía cambian. La calidad varía según quién gane, y por eso las reglas incluyen latencia, rendimiento y región. Además hay un mínimo por token que, en modelos muy baratos, pesa más que el 5% anunciado.
Primeros pasos
- Regístrate en liquidinference.ai. La cuenta crea un espacio de trabajo con saldo, claves de API y recibos, y trae un crédito inicial para probar sin tarjeta.
- Crea una clave en la página de claves. El secreto se muestra una sola vez, así que cópialo antes de cerrar el panel.
- Apunta tu cliente de OpenAI o Anthropic a la URL base del mercado y sustituye la clave. Los nombres de modelo deben coincidir con los que lista la plataforma.
- Añade un objeto
exchangeal cuerpo de la petición si quieres fijar un tope de gasto, un límite de tiempo hasta el primer token, una política de retención o una lista de proveedores permitidos. - Lee el campo
exchangede la respuesta o abre el recibo para ver qué proveedor ganó y cuánto costó el trabajo.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Liquid Inference.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores con agentes de código
- Startups con volumen impredecible
- Ingenieros de plataforma que necesitan rastro documental
- Dueños de GPU con capacidad libre
Tareas
- Procesos por lotes con techo de gasto
- Comparar modelos con el mismo prompt
- Canales de RAG y búsqueda
- Comprar imágenes, voz o transcripciones
Casos de uso
- Un bucle de agente se repite y la factura sube
- Un proveedor se cae a mitad de una tanda larga
- Un equipo busca la API de LLM más barata para una herramienta interna y no puede probar a cada vendedor
Funciones clave
Una subasta en cada petición
Cada petición entra en un libro de ofertas en vivo. La plataforma descarta las que incumplen tus límites, ordena el resto por coste estimado más la espera prevista y adjudica el trabajo a la mejor. El precio se congela antes de generar, así que el peor caso se conoce de antemano.
Reglas de compra a tu medida
Un objeto exchange opcional lleva las condiciones. Puedes fijar un tope en dólares, un tiempo máximo hasta el primer token, un rendimiento mínimo, regiones permitidas, retención cero y listas de proveedores o modelos autorizados. Solo compiten las ofertas que cumplen todo, y la política pasa a ser un campo de la petición en lugar de un ticket a soporte.
Conmutación antes del primer token
Si el proveedor ganador falla antes de escribir nada, la plataforma pasa el trabajo a la siguiente oferta. Cuando ya hay salida, no cambia, de modo que una respuesta nunca mezcla dos modelos. Esa distinción importa en agentes con streaming, donde un cambio a mitad de flujo rompería las llamadas a herramientas ya enviadas.
Recibos y datos de mercado públicos
Cada trabajo liquidado tiene un recibo con el ganador, el tope, el consumo y la comisión. Los titulares de una cuenta ven además el libro de órdenes en vivo, las cotizaciones por proveedor y las operaciones cerradas. Puedes consultar esos datos por API antes de enviar una petición, útil para saber si un modelo cotiza por encima de su tarifa habitual.
Enrutador automático y enrutamiento por eje
Con liquid.auto la plataforma elige el modelo según la puntuación publicada y el cargo estimado dentro de tu tope, con variantes premium, balanced y economy. También puedes añadir un sufijo al nombre del modelo para ordenar por más inteligente, más rápido o más barato. En ambos casos la subasta sigue debajo, así que el precio sale de vendedores que compiten.
Funciona con tu stack actual
Los endpoints forman una API compatible con OpenAI para Chat Completions y Responses, más una ruta de Anthropic Messages. Los SDK oficiales funcionan tras cambiar la URL base. Hay guías para Claude Code, Codex, Cursor, Cline, Open WebUI, n8n, Dify, LangChain y muchas otras herramientas. La CLI de Liquid arranca un agente de código desde la terminal con la misma clave.
Un lado vendedor para dueños de GPU
Los proveedores registran despliegues, fijan un precio por modelo y cotizan durante una sesión. La plataforma reparte trabajos, mide el consumo y liquida los pagos. Quien tiene GPUs paradas puede monetizarlas sin construir su propia facturación, y quien ya vende en otro sitio puede listar el mismo despliegue aquí como segunda plaza.
Ventajas y desventajas
Ventajas
- El tope se fija antes de generar, así que un prompt con un límite de salida enorme no produce una factura sorpresa.
- Conservas tu SDK y tu cliente. En la mayoría de los casos la migración es una URL base y una clave, no una reescritura.
- Las reglas de compra cubren latencia, región y retención de datos, lo que hace el mercado viable para cargas con requisitos de cumplimiento.
- Los recibos y el libro público dejan constancia de cuánto costó cada trabajo y quién lo sirvió.
- El lado vendedor da a los dueños de GPU una forma de llenar capacidad ociosa sin montar su propia facturación.
Desventajas
- El mercado es nuevo. Abrió en octubre de 2026 y tiene menos vendedores que los enrutadores ya establecidos, con una cobertura de modelos que puede cambiar sin aviso.
- El mínimo de 0,01 dólares por millón de tokens castiga las ofertas baratas y gratuitas. En un modelo económico la comisión efectiva puede acercarse a la mitad de lo que cobra el proveedor.
- La calidad depende de quién gane. La subasta optimiza precio y rendimiento declarado, no la calidad de una respuesta concreta, y una puntuación alta no garantiza un mejor resultado.
- La petición no puede cambiar de proveedor cuando ya empezó la salida. Si el vendedor se degrada a mitad de flujo, te queda una respuesta parcial y un reintento.
Preguntas frecuentes
Liquid Inference es un mercado de inferencia de LLM de Architect Financial Technologies. Los proveedores publican precios para los modelos que sirven y cada petición se adjudica a la oferta más barata que cumpla las reglas de coste, velocidad, región y datos del comprador. Se usa por web, por API y por CLI.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Liquid Inference.
Alternativas a Liquid Inference

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.