
LiteLLM
BerriAI · Programación · Otro
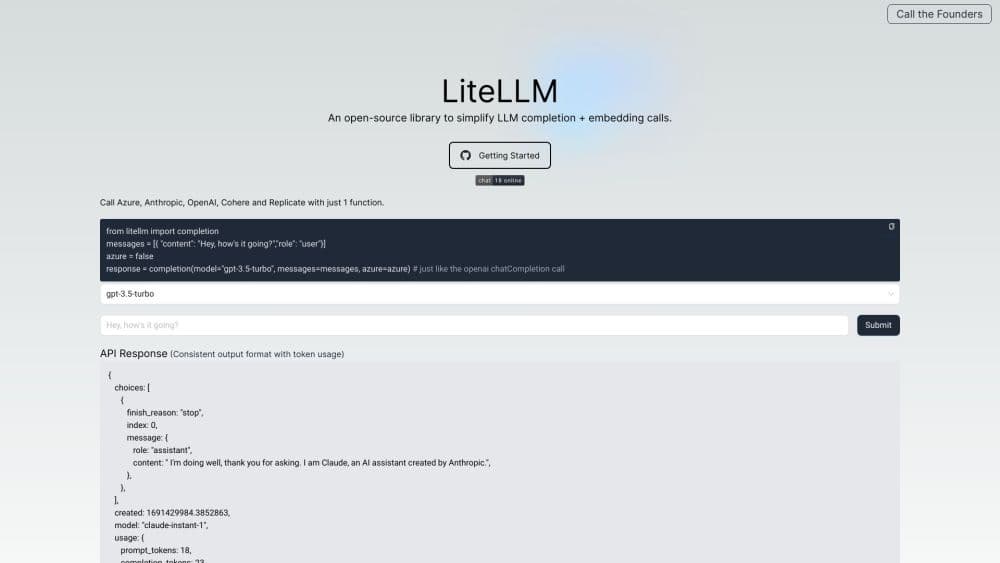
LiteLLM es un gateway de IA y una librería de Python de código abierto que llama a más de 100 LLM con una sola interfaz con formato OpenAI, con enrutado, control de gasto y barreras de seguridad.
Acerca de LiteLLM
What Is LiteLLM
LiteLLM es una herramienta de BerriAI que da a los desarrolladores una sola interfaz para llamar a modelos de OpenAI, Anthropic, Gemini, Bedrock, Azure, Ollama y decenas de proveedores más. En lugar de aprender un SDK, un sistema de autenticación y una estructura de respuesta distintos para cada proveedor, escribes una llamada y cambias el nombre del modelo cuando quieres pasar a otro backend.
El problema que resuelve es la dependencia de un solo proveedor. Los equipos que construyen sobre una única plataforma descubren a menudo que cambiar de modelo implica reescribir constructores de peticiones, gestión de errores y lógica de streaming en todo el código. LiteLLM coloca una capa de traducción debajo de tu código para que la lógica de negocio siga igual mientras el modelo subyacente cambia en un archivo de configuración.
Hay dos formas de usarlo y entre las dos cubren casi todas las necesidades. El SDK de Python se integra en una aplicación existente como un paquete, mientras que el gateway (servidor proxy) funciona como servicio autoalojado que centraliza claves virtuales, presupuestos y registros para todo un equipo. El precio de esa comodidad es que el gateway añade infraestructura que mantener, y la versión de código abierto espera que tú mismo la alojes y la actualices.
Getting Started
- Instala el paquete con
uv add litellmopip install litellmy configura las claves de API de tus proveedores como variables de entorno. - Para la vía del SDK, importa
completiony llámala con un nombre de modelo comoopenai/gpt-4ooanthropic/claude-sonnet-4, pasando tu lista de mensajes. - Para la vía del gateway, ejecuta
litellm --model gpt-4oo despliega la imagen de Docker, y luego apunta cualquier cliente de OpenAI a la URL base local. - Añade una configuración de Router cuando quieras reintentos y alternativas entre varios despliegues, y conecta Postgres y Redis si ejecutas más de una instancia del gateway.
- Sigue el uso desde el panel de administración o mediante un callback, y fija presupuestos por clave, usuario o equipo a medida que crece el tráfico.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de LiteLLM.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de backend
- Equipos de plataforma y de ML
- Product managers que hacen pruebas
Tareas
- Acceso unificado a modelos
- Control de costes
- Tolerancia a fallos y balanceo de carga
- Observabilidad
Casos de uso
- Una startup que empezó con un proveedor y quiere añadir modelos más baratos sin tocar la lógica de negocio.
- Una empresa que ejecuta un gateway autoalojado para que el tráfico de modelos y las claves se queden dentro de su propia infraestructura.
- Una sesión de prototipado en la que un solo script prueba el mismo prompt con cinco modelos distintos.
Funciones clave
API unificada para más de 100 proveedores
Una sola interfaz cubre OpenAI, Anthropic, Gemini, Bedrock, Azure, Vertex AI, Ollama, vLLM y muchos más. Todas las respuestas llegan con la estructura de chat completions de OpenAI, así que el código que lee choices[0].message.content sigue funcionando después de cambiar de proveedor.
Compatibilidad directa con OpenAI
Los proyectos que ya usan el SDK de OpenAI pueden apuntar su cliente a un gateway de LiteLLM cambiando la URL base y la clave. No hay que tocar el código de las peticiones, lo que convierte esto en una forma de bajo riesgo de añadir soporte multimodelo a una aplicación en marcha.
Servidor proxy y gateway de LLM
El gateway autoalojado actúa como punto de control central para un equipo. Gestiona claves virtuales, registra el gasto por clave, usuario, equipo y organización, aplica límites de RPM y TPM, e incluye un panel de administración para el día a día.
Router con reintentos y alternativas
El módulo Router coordina varios despliegues del mismo modelo. Reintenta las llamadas fallidas, recurre a un despliegue sano cuando un proveedor se cae y reparte la carga entre backends para que un endpoint lento no frene toda la aplicación.
Control de gasto y presupuestos
LiteLLM calcula el coste de cada llamada y lo registra contra la clave o el proyecto que la hizo. Los equipos pueden fijar presupuestos mensuales y límites de velocidad, y luego revisar el gasto sin montar su propio sistema de medición.
Observabilidad y barreras de seguridad
Una sola línea de callback envía registros, recuentos de tokens y trazas a Langfuse, MLflow, Helicone y otras herramientas. Las barreras de seguridad permiten filtrar o bloquear entradas y salidas inseguras, y la conversión de errores mantiene las excepciones propias de cada proveedor en tipos de OpenAI conocidos.
Ventajas y desventajas
Ventajas
- Una interfaz con formato OpenAI elimina la necesidad de aprender un SDK distinto para cada proveedor de modelos.
- Los cambios de modelo se hacen en la configuración, lo que reduce el riesgo de que un cambio de proveedor rompa el código en producción.
- El núcleo de código abierto es gratuito bajo licencia MIT y puede ejecutarse por completo en tus propios servidores.
- Los reintentos y las alternativas del Router mejoran la disponibilidad cuando un proveedor sufre una caída.
- El control de gasto y los presupuestos dan a los equipos visibilidad sobre un gasto que de otro modo suele quedar fuera de control.
Desventajas
- El gateway es otro servicio que desplegar, vigilar y actualizar, y eso añade trabajo operativo a los equipos pequeños.
- Ejecutarlo en varias instancias exige Postgres y Redis, así que un despliegue serio conlleva necesidades reales de infraestructura.
- Funciones como SSO, SCIM, registros de auditoría y despliegue en red aislada quedan detrás del plan Enterprise de pago.
- Las particularidades de proveedores nuevos pueden llegar más tarde que en los SDK oficiales, así que los endpoints poco usados a veces piden configuración extra.
Preguntas frecuentes
LiteLLM permite que una aplicación llame a muchos proveedores de LLM distintos a través de una sola interfaz con formato OpenAI. Los desarrolladores lo usan para no reescribir código cada vez que cambian de modelo y para centralizar claves, presupuestos y registros detrás de un gateway autoalojado.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con LiteLLM.
Alternativas a LiteLLM

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.