

LLMWare.ai
LLMWare.ai · Programación · Otro
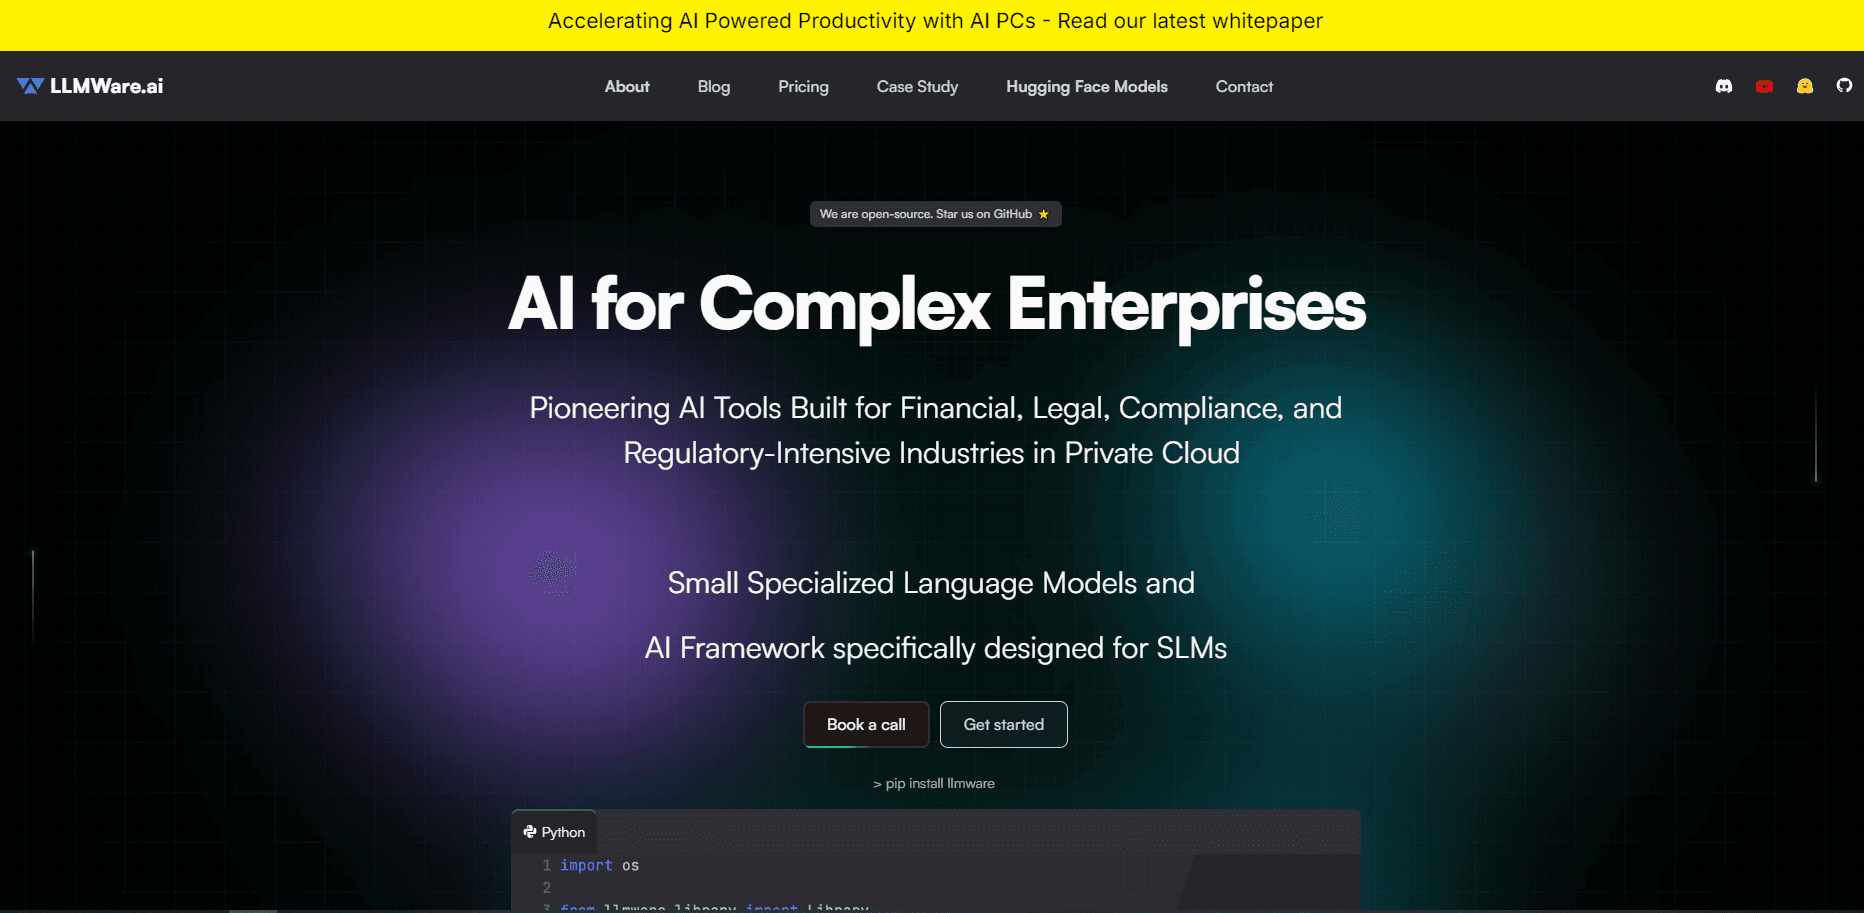
LLMWare.ai crea Model HQ, una plataforma sin código para ejecutar flujos de IA privada en tu propio hardware con más de 250 modelos pequeños de lenguaje, RAG en el dispositivo y sin coste por token.
Acerca de LLMWare.ai
What Is LLMWare.ai
LLMWare.ai es la empresa detrás de Model HQ, un motor de flujos de IA privada que ejecuta modelos de lenguaje en tu propio portátil, AI PC o centro de datos en lugar de en la nube de otro. Nació del framework de código abierto llmware, una librería de Python para construir aplicaciones de generación aumentada por recuperación (RAG) con modelos pequeños y especializados. El equipo mantiene ambas cosas: el framework para desarrolladores y Model HQ como producto listo para usar.
El argumento a favor de lo local es sencillo. Los documentos sensibles se quedan dentro de tu perímetro de seguridad, no hay cargos por token y el sistema funciona sin conexión en la mayoría de flujos. Eso encaja con equipos de finanzas, legal, seguros y cumplimiento, donde enviar contratos o expedientes de clientes a una API pública no es una opción. La empresa lo resume sin rodeos: sé dueño de tu IA y mantén los datos donde viven.
El precio de esa ventaja es que los modelos locales son más pequeños. Model HQ ejecuta modelos de hasta 32B parámetros en los AI PC actuales, suficiente para trabajo con documentos, clasificación y extracción estructurada, pero no el techo de los mayores modelos en la nube. Además instalas un agente cliente en lugar de entrar a una web, y las opciones de despliegue más completas se venden mediante conversación con el equipo comercial.
Getting Started
- Descarga el agente cliente de Model HQ, unos 200 MB, en tu AI PC o portátil
- Ábrelo y elige un modelo del catálogo de más de 250 modelos pequeños de lenguaje
- Señala tus archivos o conecta una fuente de datos para crear una base de conocimiento en el dispositivo
- Encadena modelos, datos y lógica en un flujo de trabajo y ejecútalo cuando quieras o con una programación
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de LLMWare.ai.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Equipos de sectores regulados
- Responsables de seguridad y TI
- Desarrolladores de apps RAG
- Equipos pequeños y medianos
Tareas
- Procesamiento de documentos
- Búsqueda de documentos en el dispositivo
- Extracción de datos estructurados
- Flujos de TI y servicio
- Automatización programada
Casos de uso
- Revisión legal o financiera
- Sedes aisladas o con mala conexión
- Despliegue de AI PCs
- Archivos sensibles de RRHH o médicos
- Prototipar antes de escalar
Funciones clave
Creador de flujos sin código
Model HQ te deja montar flujos de IA de varios pasos sin escribir código. Encadenas modelos, fuentes de datos y lógica en un proceso repetible, desde un simple paso de resumen hasta una cadena que lee un documento, extrae campos y enruta un resultado. Con eso el producto va más allá de un chatbot: ejecuta tareas de negocio de principio a fin. La empresa sitúa este creador como la pieza que abre la automatización con IA a quien nunca toca Python.
Más de 250 modelos pequeños de lenguaje
La plataforma trae un catálogo de más de 250 modelos pequeños de lenguaje, empaquetados en formatos cuantizados para correr en la GPU y la NPU del dispositivo. Incluye la familia SLIM (Structured Language Instruction Models) para llamadas a funciones y clasificación, los modelos DRAGON ajustados para preguntas y respuestas con RAG, y los BLING para prototipos rápidos. También admite los principales modelos en la nube de OpenAI, Anthropic y Google, así que mezclas local y nube donde tenga sentido.
RAG y búsqueda de documentos en el dispositivo
Model HQ incorpora un pipeline de generación aumentada por recuperación, la misma tecnología detrás del framework de código abierto llmware. Apuntas a una carpeta de PDF, documentos de Word u hojas de cálculo; el sistema los analiza, trocea e indexa, y luego responde usando ese contexto. La empresa lo conecta con varias bases de datos vectoriales, entre ellas FAISS, Milvus, Pinecone, Qdrant, Postgres (PG Vector), Redis y Chroma, para equipos que ya usan alguna.
Funciona en hardware de AI PC
El agente cliente está hecho para aprovechar el silicio que ya lleva un portátil moderno. Corre en CPU, GPU y NPU, y está afinado para chips de Intel, AMD, Apple, NVIDIA y Qualcomm Snapdragon. La empresa indica tiempos medios de descarga de unos 10 segundos para la app y de menos de 30 minutos para un conjunto de modelos en un dispositivo. Los modelos de hasta 32B parámetros corren en los AI PC más recientes, así que tienes capacidad útil sin servidor.
Cero coste por token y sin dependencia de la nube
Como la inferencia corre en tu hardware, no hay cargo por token ni factura medida de API. La empresa sitúa el coste incremental esperado por token en un AI PC en $0. La mayoría de los flujos funcionan sin conexión de red, algo que importa a equipos de campo, instalaciones seguras y a quien prefiere no depender de que un servicio externo esté disponible. Tus datos se quedan en tu entorno por defecto.
Opciones de despliegue privado
Model HQ está pensado para correr en tres sitios: en AI PCs, en tu centro de datos para inferencia por lotes y RAG sobre datos sensibles, o en una nube privada para operaciones grandes y sensibles al tiempo. Los tres se pueden enlazar en una configuración mixta, de modo que el agente del portátil tire de un despliegue central cuando necesite modelos mayores. Las empresas pueden crear apps de agentes de IA y desplegarlas en los dispositivos de su plantilla.
Herramientas de seguridad de IA para empresas
La plataforma incluye los controles que pide un comprador regulado: explicabilidad de la IA, filtrado de datos personales, control de toxicidad y sesgo, y detección de alucinaciones. Los despliegues de empresa añaden monitorización, actualizaciones y escalado sobre hardware variado. Junto con la ejecución en el dispositivo, eso da a los equipos de cumplimiento una forma de responder adónde fueron los datos y qué vio el modelo.
Ventajas y desventajas
Ventajas
- Corre en local, así que los documentos sensibles no salen de tu perímetro y no hay cuota por token
- El creador sin código abre flujos de IA de varios pasos a quien no programa, así que puedes montar agentes de IA sin código para la automatización de IA empresarial
- Admite tanto modelos locales pequeños como grandes modelos en la nube, para mezclar según convenga
- Trae un catálogo amplio de modelos especializados para RAG, clasificación y llamadas a funciones
- Se despliega en AI PCs, centros de datos y nube privada desde una sola plataforma, con una vía de entrada gratuita
Desventajas
- Los modelos locales se quedan en torno a 32B parámetros, así que las tareas de razonamiento más duras siguen favoreciendo a los grandes modelos en la nube
- Instalas y gestionas un agente cliente, más trabajo que abrir una web
- El despliegue completo en centro de datos y nube privada se vende por conversación con ventas, así que el precio no es público
- La mayoría de flujos van bien sin red, pero los modelos más grandes y las integraciones en la nube aún necesitan conexión
Preguntas frecuentes
LLMWare.ai es una empresa de IA que crea Model HQ, un motor de flujos de IA privada para ejecutar modelos de lenguaje en tu propio hardware. También mantiene el framework de código abierto llmware en Python para construir aplicaciones RAG. Se centra en sectores sensibles a los datos, como servicios financieros, legal y seguros.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con LLMWare.ai.
Alternativas a LLMWare.ai

Udon
Udon · Programación · ProductividadUdon convierte un Mac con Apple Silicon en un servidor doméstico que se gestiona desde el navegador, con contenedores, archivos compartidos y un administrador de sistemas con IA opcional.

offstage
offstage cloud · Programación · Productividadoffstage da a los agentes de IA y a los trabajos de CI un Mac de verdad: una cuenta de macOS 27 sobre Apple silicon, manejada por API y cobrada por segundo.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programación · ProductividadBotBus te deja controlar desde el móvil y el reloj los agentes de programación con IA que corren en tu ordenador: apruebas comandos, lanzas tareas y lees resultados sin volver al escritorio.