
Maxim AI
Maxim AI · Programación
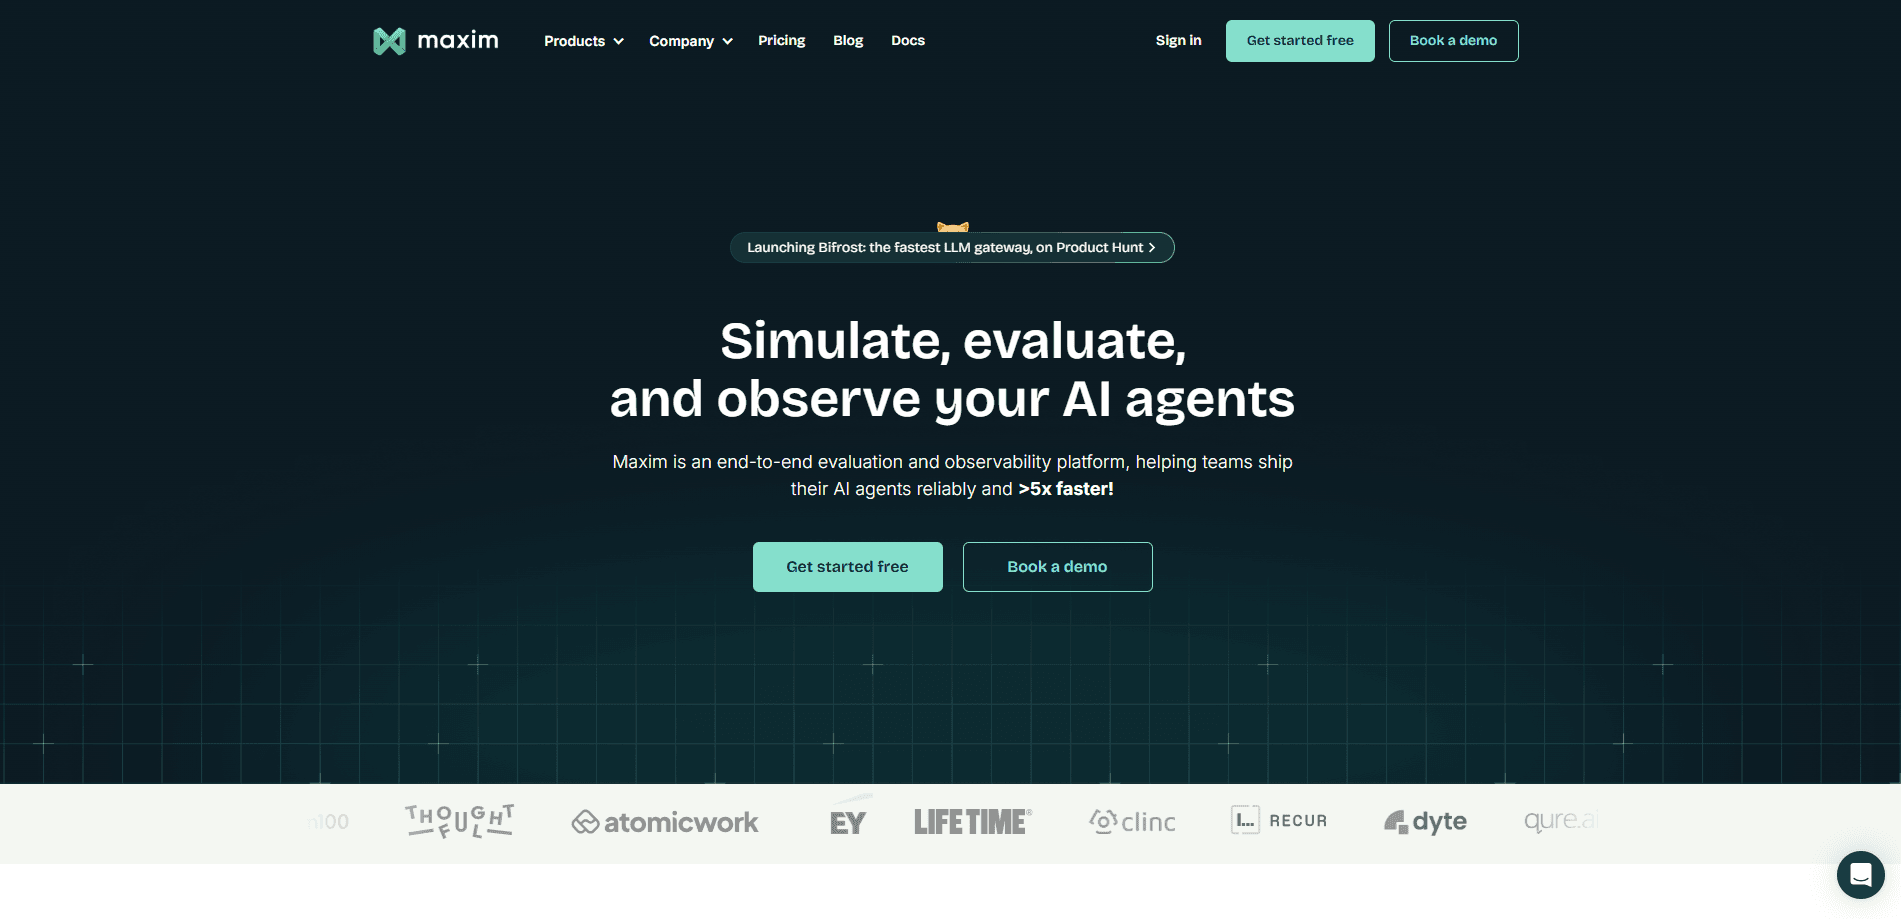
Maxim AI es una plataforma integral de evaluación y observabilidad que ayuda a los equipos a simular, probar y monitorear agentes de IA, prompts y flujos de trabajo antes y después de publicarlos.
Acerca de Maxim AI
What Is Maxim AI
Maxim AI es una plataforma pensada para equipos que construyen agentes de IA y aplicaciones basadas en LLM. Cubre el ciclo completo para preparar un agente de cara al usuario real: diseñar prompts, probarlos en muchos escenarios, puntuar los resultados y vigilar el tráfico en vivo una vez que el producto está activo.
El problema que resuelve es que la mayoría de las funciones de IA llegan a producción sin una prueba medible de que funcionan. Un prompt puede verse bien en una ventana de chat y aun así fallar en casos límite, en llamadas a herramientas o en pasos de recuperación. Maxim ofrece un lugar donde ejecutar esas comprobaciones a escala, con una biblioteca compartida de evaluadores y conjuntos de datos, en lugar de revisar resultados uno por uno a ojo.
El límite está en su alcance. Maxim es una herramienta para desarrolladores y equipos de producto, no una aplicación de consumo. Da por hecho que vas a integrar un SDK, definir métricas y gestionar conjuntos de datos, así que un usuario sin código obtiene poco de ella. El precio, además, funciona por niveles de uso, de modo que el coste sube con el volumen de trazas y evaluaciones que ejecutes.
Getting Started
- Crea una cuenta en getmaxim.ai y abre un espacio de trabajo para tu proyecto.
- Añade tus proveedores de modelos y claves de API, y conecta un prompt o un agente existente mediante el SDK de Python o TypeScript.
- Arma un conjunto de casos de prueba y elige evaluadores, ya sean integrados o puntuadores propios.
- Lanza una simulación o un experimento, lee las puntuaciones y activa el registro en vivo para que las ejecuciones de producción alimenten los mismos paneles.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Maxim AI.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de IA que construyen agentes
- Equipos de producto que lanzan funciones con LLM
- Responsables de calidad y evaluación
Tareas
- Probar prompts entre modelos
- Comprobaciones de regresión en agentes
- Monitoreo en producción
Casos de uso
- Preparar un agente para su lanzamiento
- Evaluar dentro de CI/CD
- Auditar un producto de IA en vivo
Funciones clave
Playground de experimentación
El playground es donde ocurre el trabajo con prompts. Pruebas y cambias prompts, modelos, herramientas y contexto sin tocar código, versionas prompts fuera de la base de código, encadenas piezas en un flujo con una vista de bajo código y despliegas la versión elegida con un conjunto de reglas. Para equipos que manejan varias ediciones de prompts a la semana, el versionado deja claro qué cambió y quién lo publicó.
Simulación y evaluación de agentes
Maxim ejecuta un motor de simulación y evaluación que pone a prueba agentes en miles de escenarios usando las métricas que definas. Las simulaciones empujan al agente por situaciones variadas, mientras que las evaluaciones puntúan la calidad de cada ejecución con métricas integradas o propias. Las automatizaciones conectan el motor a flujos de CI/CD, y la vista de analítica convierte los resultados en informes que puedes compartir.
Observabilidad y monitoreo en vivo
Cuando un agente ya está activo, Maxim registra trazas, así que ves flujos de varios pasos y cadenas largas de llamadas a herramientas ordenadas paso a paso. Las evaluaciones en línea puntúan interacciones reales, incluidas la generación, las llamadas a herramientas y la recuperación, y las alertas se disparan ante regresiones. Esto es lo que separa una prueba puntual del seguimiento continuo de la calidad.
Biblioteca unificada de evaluadores
Una sola biblioteca reúne evaluadores integrados y propios de varios estilos: LLM como juez, estadísticos, programáticos y de puntuación humana. Como los mismos evaluadores sirven tanto para las simulaciones como para el monitoreo en vivo, una puntuación significa lo mismo en pruebas y en producción.
Herramientas y salidas estructuradas
Maxim admite de forma nativa definiciones de herramientas y salidas estructuradas. Puedes crear y probar herramientas basadas en código o en API, y luego observar cómo el agente las elige y las llama. Esto importa en agentes que dependen de API externas, porque una llamada equivocada suele romper toda una ejecución.
Conjuntos de datos e integraciones
La plataforma maneja conjuntos multimodales sintéticos y propios con una importación sencilla, y se conecta mediante SDK de Python y TypeScript. Los equipos con un stack compatible pueden llevar los resultados a sus propias canalizaciones, y las reglas de precio personalizado mantienen el coste de tokens reportado en línea con las tarifas negociadas.
Ventajas y desventajas
Ventajas
- Cubre todo el ciclo en un solo lugar, del diseño de prompts a la simulación, la puntuación y el monitoreo en vivo, así que los equipos se ahorran coser varias herramientas.
- La biblioteca unificada de evaluadores permite que la misma métrica corra en pruebas y en producción, lo que mantiene las puntuaciones comparables con el tiempo.
- Los flujos de revisión y anotación humana escalan la puntuación manual en lugar de dejarla en una hoja de cálculo.
- Los SDK de Python y TypeScript, junto con las automatizaciones de CI/CD, encajan con equipos que ya tienen un flujo automatizado de compilación y pruebas.
Desventajas
- Exige código. Sin una base de código que instrumentar, la plataforma es difícil de usar, así que no encaja con usuarios no técnicos.
- El precio por uso hace que el coste crezca con el volumen de trazas y evaluaciones, lo que puede sorprender a los equipos en fases de pruebas intensas.
- Montar evaluaciones útiles lleva trabajo real. Tienes que definir métricas y armar conjuntos de datos antes de obtener puntuaciones valiosas.
- El plan gratuito tiene límites de uso, así que cualquier cosa más allá de pruebas ligeras pasa a un nivel de pago.
Preguntas frecuentes
Maxim AI sirve para evaluar y monitorear agentes de IA y aplicaciones con LLM. Los equipos diseñan y prueban prompts, pasan agentes por escenarios simulados, puntúan los resultados con evaluadores y siguen el tráfico en vivo por calidad y coste cuando el producto está activo.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Maxim AI.
Alternativas a Maxim AI
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.