
MemoryCustodian
Zekun Wang (waittim) · Programación
MemoryCustodian es una herramienta gratuita y de código abierto que da a los agentes de código una memoria de proyecto duradera. Guarda decisiones, restricciones e ideas descartadas como archivos Markdown simples dentro de tu repositorio y luego envía al agente solo las partes relevantes para la tarea mediante un manifiesto. El resultado: menos relleno en los prompts y un trabajo más constante entre sesiones, agentes y compañeros de equipo. Está hecha para la gestión del contexto de agentes de código IA, no para registros de chat.
Acerca de MemoryCustodian
Qué es MemoryCustodian
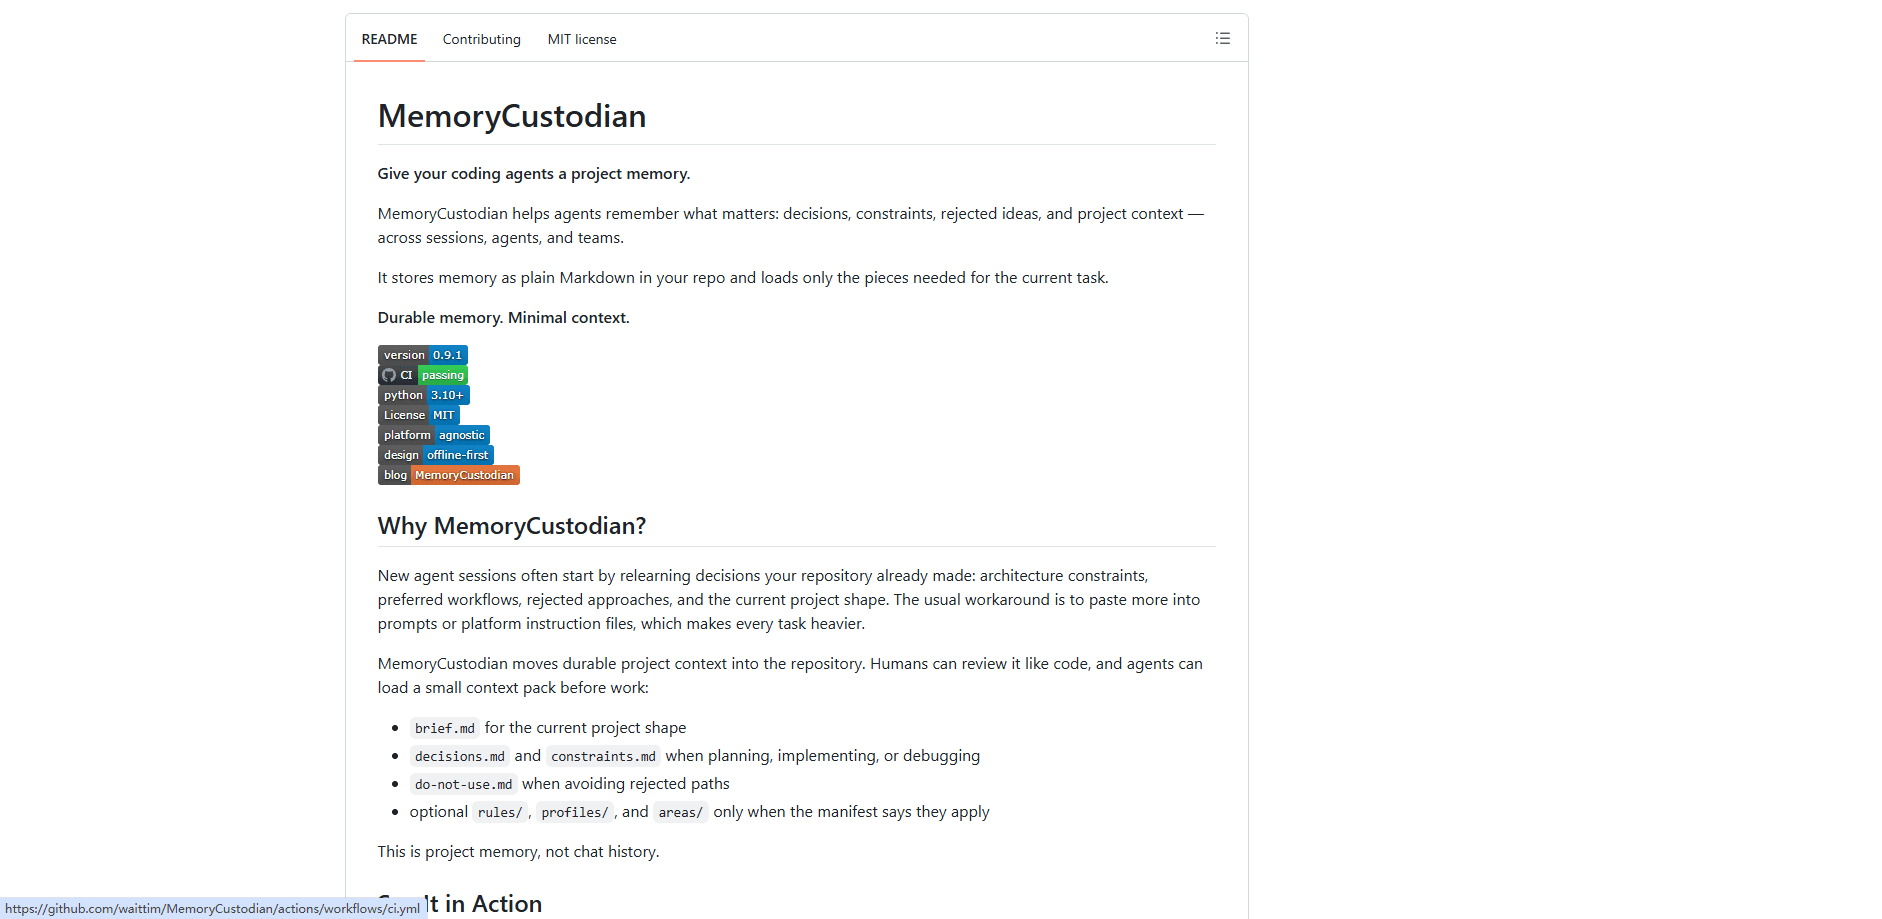
MemoryCustodian es una herramienta de memoria para agentes de código IA pensada para quien trabaja con Codex, Claude Code, Gemini o cualquier agente basado en shell. También encaja en equipos que comparten un mismo repositorio entre varios hosts de agentes y quieren una única fuente de verdad. El problema que ataca es concreto: cada nueva sesión de agente tiende a reaprender decisiones que tu repositorio ya tomó. Las restricciones de arquitectura, los flujos de trabajo preferidos, los enfoques descartados y la forma actual del proyecto vuelven a pegarse en los prompts, y eso hace que cada tarea pesa más que la anterior. ¿Y por qué pasa esto? Porque la memoria vive en el chat, y el chat se borra.
La solución es mover el contexto de proyecto duradero al propio repositorio. MemoryCustodian mantiene ese contexto en Markdown simple dentro de docs/memory/, así las personas pueden revisarlo y compararlo como si fuera código. Antes de una tarea, el agente lee un paquete de contexto pequeño y acotado en lugar de todo el historial. Eso es el enrutamiento de contexto del agente en la práctica. Mantiene bajo el uso de tokens y evita que el agente invente reglas que nunca acordaste.
No es historial de chat. Es memoria de proyecto. Esa distinción importa, porque significa que la memoria sobrevive a una conversación borrada, a un cambio de modelo o a la llegada de un nuevo compañero al repositorio. La principal contrapartida es que tienes que escribir los archivos iniciales a mano. Un brief pobre lo señalan los comandos integrados de estado y verificación.
Cómo empezar
- Pídele a tu agente de código que instale la skill MemoryCustodian desde su repositorio de GitHub y luego la inicialice.
- O ejecuta la CLI directamente:
memory-custodian init --project-root /path/to/project --agent all(cambiaallporcodex,claudeogeminipara apuntar a un solo host). - Revisa los archivos generados en
docs/memory/, sobre todobrief.md, y rellena los TODO con la documentación autorizada de tu proyecto. - Registra memoria duradera mientras trabajas con
memory-custodian add, etiquetando cada entrada con un sujeto y una evidencia. - Ejecuta
memory-custodian statusymemory-custodian checkpara confirmar que el protocolo está sano antes de depender de él.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de MemoryCustodian.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que usan agentes de código a diario
- Equipos pequeños que comparten un repositorio
- Quien alterna entre Codex, Claude Code y Gemini
Tareas
- Preservar decisiones de arquitectura
- Seguir los enfoques descartados
- Incorporar una sesión de agente nueva
Casos de uso
- Retomar un repositorio tras una larga pausa
- Revisar un pull request
- Ejecutar agentes en CI
Funciones clave
Memoria Markdown nativa del repositorio
MemoryCustodian guarda toda la memoria del proyecto como Markdown simple en docs/memory/. Eso significa que se puede revisar, comparar, confirmar y revertir sin riesgo igual que tu código fuente, que es justo el punto cuando la memoria codifica decisiones reales de ingeniería. Nada queda encerrado en una base de datos propietaria, y los compañeros pueden revisar los cambios de memoria en los mismos pull requests que el código.
Enrutamiento de contexto basado en manifiesto
En lugar de meter todo el historial en cada prompt, la herramienta lee primero manifest.md, luego brief.md y después solo los archivos que el manifiesto nombra para tu tarea. El enrutamiento usa entradas explícitas de tarea y alcance, sin adivinanzas semánticas ni ranking por LLM. El enrutamiento de contexto del agente se mantiene determinista y predecible. Obtienes un paquete de contexto acotado que encaja con el trabajo en curso.
Tipos de tarea canónicos
La CLI trae un conjunto fijo de categorías de tarea: general, planning, implementation, artifact, preferences, history y maintenance. Llamar a read --task implementation trae la memoria relevante para escribir código, mientras otras tareas cargan una porción distinta según el alcance que pases. Un flag --strict-routing falla en cerrado ante un alcance incompleto o ambiguo, en vez de adivinar.
Escrituras de memoria conservadoras
La memoria activa se respalda con evidencia. Las entradas reciben IDs estables como MC-DEC-... y MC-SUBJ-..., y cada escritura necesita confirmación del usuario o una fuente del proyecto para contar como real. Las observaciones no confirmadas del agente quedan como candidatas en inbox.md hasta que una persona las avala, lo que mantiene las reglas fantasma fuera de tu memoria de trabajo y lejos de tu código.
Olvido, verificaciones y mantenimiento
El olvido es con vista previa primero y con alcance: memory-custodian forget imprime un Plan ID que debes confirmar antes de que se borre nada. Ese paso de vista previa importa porque los archivos de memoria son compartidos, así que un borrado malo puede afectar a la vez al agente de todos. Comandos de mantenimiento como compact mantienen los archivos dentro del presupuesto y archivan las entradas más antiguas cuando lo pides. Hay verificaciones separadas de enrutamiento, frescura, privacidad, seguridad y conflictos, incluida la revisión con conocimiento de fusiones de Git contra una rama base.
CLI en Python sin dependencias
Toda la herramienta funciona con la librería estándar de Python. Ninguna dependencia de terceros en tiempo de ejecución. Funciona sin conexión y no necesita un pipeline RAG ni una base de datos vectorial, lo que evita la latencia de los embeddings y las recuperaciones alucinadas. Se instala con un solo pip install editable o con un script wrapper incluido.
Ventajas y desventajas
Ventajas
- Gratis y de código abierto bajo la licencia MIT, sin nivel de pago ni límites de uso.
- Funciona sin conexión, con cero dependencias de terceros en tiempo de ejecución y sin base de datos vectorial.
- La memoria vive en tu repositorio como Markdown comparable, así que se puede revisar y revertir sin riesgo.
- Un solo conjunto de memoria sirve a Codex, Claude Code, Gemini y agentes genéricos de shell.
- Las escrituras con evidencia y los IDs estables reducen las reglas fantasma y las sobrescrituras accidentales.
- Ligera en recursos: sin servidor, sin base de datos, solo archivos Markdown en tu repositorio.
Desventajas
- Es una herramienta de desarrollador orientada a agentes de código, así que a los usuarios no técnicos les resultarán pesados la CLI y los conceptos del protocolo.
- Obtener valor depende de curar el `brief.md` inicial; una configuración sin curar queda señalada y la calidad del enrutamiento se resiente.
- El recuerdo de la memoria es determinista y basado en reglas, así que no resumirá por ti conversaciones desordenadas.
Preguntas frecuentes
Da a los agentes de código IA una memoria de proyecto duradera. Guarda decisiones, restricciones y enfoques descartados en tu repositorio y carga solo las partes relevantes para la tarea. Así los agentes dejan de reaprender el mismo contexto en cada sesión.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con MemoryCustodian.
Alternativas a MemoryCustodian
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.