
Mercury
Inception Labs · Voz e idioma · Programación
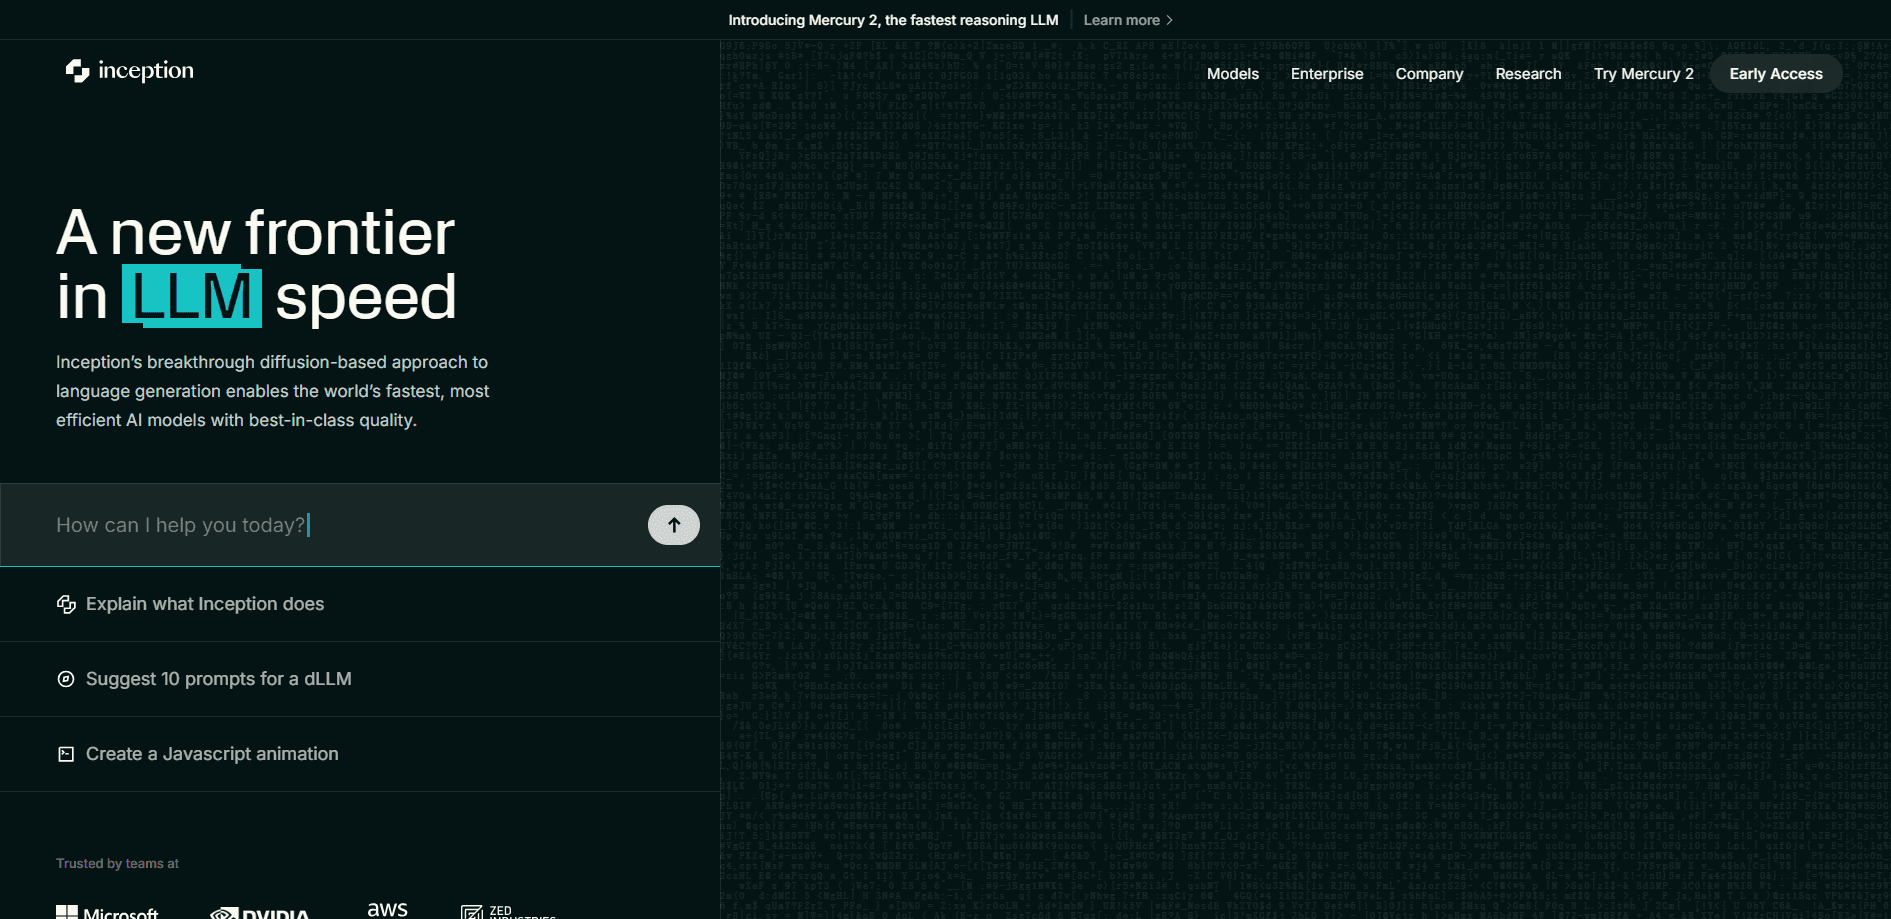
Mercury es una familia de modelos de lenguaje grandes de difusión de Inception Labs que genera texto en paralelo en lugar de palabra por palabra. La versión actual, Mercury 2.5, funciona a 1.107 tokens por segundo con una ventana de contexto de 260K. El precio está en 0,20 dólares por millón de tokens de entrada y 0,75 dólares por millón de tokens de salida. Como modelo de generación de texto, apunta a desarrolladores que necesitan resultados rápidos y baratos para búsqueda, voz y programación. Este modelo de IA de baja latencia se alquila mediante una API en lugar de ejecutarse en tu propia máquina, así que el precio de los modelos de IA es de pago por uso.
Acerca de Mercury
Qué es Mercury
Mercury es la línea de modelos estrella de Inception Labs, una empresa fundada por investigadores de Stanford, UCLA, Cornell, Google DeepMind, Meta AI, Microsoft AI y OpenAI. Su rasgo definitorio está en la arquitectura que hay debajo. Casi todos los LLM comerciales generan un token a la vez, de izquierda a derecha. Mercury usa difusión, la misma idea general que hay detrás de los generadores de imágenes, para producir muchos tokens a la vez y luego refinarlos. De ahí viene la velocidad. La empresa afirma que este enfoque ofrece una capacidad de procesamiento de 5 a 7 veces mayor y hasta un 70% menos de coste que los modelos estándar de calidad similar.
El compromiso que conviene entender desde el principio: Mercury es un modelo de texto y razonamiento servido a través de una API, no una aplicación descargable que instalas. No chateas con él en una web como harías con ChatGPT. Lo llamas desde tu propio software, pagando por token. Inception lo dirige a equipos que ya tienen un producto y necesitan que la capa del modelo se sienta instantánea.
La velocidad es el titular, pero el control es el argumento de venta más discreto. Como la difusión deja que el modelo ajuste los tokens como grupo, Inception dice que puede seguir esquemas JSON estrictos y reglas semánticas de forma más fiable que los modelos autorregresivos, y admite razonamiento ajustable y llamadas a herramientas en paralelo. Si tu canal encadena decenas de llamadas al modelo por cada petición de usuario, esa combinación importa más que las puntuaciones brutas de los benchmarks. Piénsalo. Un agente de búsqueda puede planificar, reescribir, reordenar y resumir antes de responder.
Cómo empezar
- Crea una cuenta en la plataforma de Inception Labs y reclama una clave de API en la consola.
- Elige un modelo Mercury en el panel y revisa las tarifas actuales por token antes de construir.
- Envía una primera petición con el endpoint de chat completions, usando el nombre de modelo que aparece en tu cuenta.
- Prueba el modo JSON alineado con esquemas si tu app necesita salida estructurada, y activa el razonamiento ajustable solo donde ayude.
- Conecta la clave en tu entorno de producción y vigila la latencia y el gasto a medida que crece el tráfico.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Mercury.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de backend y de ML
- Equipos de startups con presupuesto ajustado
- Creadores de voz y soporte
Tareas
- Canales de búsqueda y RAG
- Autocompletado y refactorización de código
- Extracción de datos estructurados
Casos de uso
- Añadir un asistente ágil a una app existente sin reconstruir tu infraestructura en torno a la latencia.
- Prototipar una función de IA con poco presupuesto y luego escalarla a medida que crece el uso.
- Ejecutar trabajos por lotes de gran volumen donde el coste por tarea pesa más que exprimir el último punto de calidad.
Funciones clave
Generación de tokens en paralelo
Mercury escribe tokens en paralelo en lugar de uno a uno, la razón principal por la que es varias veces más rápido que los modelos convencionales. Inception reporta un tiempo hasta el primer token por debajo de 300 ms y 1.107 tokens por segundo en GPUs NVIDIA ampliamente disponibles. Esa diferencia suena técnica hasta que la usas. Para un usuario, eso es la distancia entre un asistente que se siente instantáneo y otro que le hace esperar mientras gira un indicador, justo el tipo de pequeña demora que aleja a la gente de un producto sin que se note.
Ventana de contexto larga de 260K
El modelo Mercury 2.5 acepta hasta 260.000 tokens de contexto en una sola petición. Eso basta para contener documentos largos, archivos de código grandes o un historial de conversación extenso sin trocearlo. Contexto largo más alta velocidad son una pareja poco habitual, ya que la mayoría de los modelos rápidos mantienen ventanas modestas, y los equipos que trabajan con bases de código grandes o informes largos suelen notar esa carencia de inmediato. Enorme ventaja para archivos grandes.
Razonamiento ajustable
Puedes regular cuánto razonamiento interno hace el modelo por petición. Súbelo para problemas difíciles que necesitan pensamiento paso a paso; bájalo para consultas simples donde el razonamiento extra solo añade latencia y coste. Ese control es raro en modelos alojados, donde el razonamiento suele estar activado o desactivado. Genial.
Salida JSON alineada con esquemas
Mercury puede limitar su salida para que coincida con un esquema JSON que definas. La difusión le deja corregir tokens como grupo, lo que según Inception hace que la salida estructurada sea más fiable. Menos respuestas rotas. Los desarrolladores tienen menos salida malformada que limpiar cuando alimentan los resultados al siguiente paso de un canal, el tipo de corte pequeño que se acumula rápido cuando un flujo de trabajo se ejecuta miles de veces al día en producción.
Llamadas a herramientas en paralelo
El modelo puede lanzar varias llamadas a herramientas o funciones a la vez en lugar de esperar a que termine cada una. En un agente que consulta un calendario, interroga una base de datos y busca en la web, ese paralelismo recorta segundos reales de la respuesta. Encaja con los flujos de varios pasos para los que se promociona Mercury, y quien haya visto a un agente avanzar a duras penas por cinco llamadas secuenciales sabe cuánto suma esa espera en una sola conversación. Gran baza para los agentes.
Arquitectura de difusión
Mercury es un LLM de difusión, o dLLM. Inception lo describe como uno de los mayores modelos de lenguaje de difusión entrenados hasta la fecha. La arquitectura también abre un camino para mezclar texto con audio, imágenes y vídeo en un solo marco. El producto que se envía hoy es primero texto.
Ventajas y desventajas
Ventajas
- Capacidad de procesamiento de 1.107 tokens por segundo y latencia hasta el primer token por debajo de 300 ms, rápida incluso para los estándares de los modelos frontera.
- Precio de 0,20 dólares por millón de tokens de entrada y 0,75 por millón de salida, muy por debajo de la mayoría de los modelos comparables.
- Ventana de contexto de 260K que maneja documentos largos y bases de código sin dividirlos.
- JSON alineado con esquemas y razonamiento ajustable que dan a los desarrolladores un control más fino sobre la salida.
Desventajas
- Solo API: no hay app de escritorio ni app móvil, así que los usuarios ocasionales no pueden simplemente abrir Mercury y chatear.
- La calidad se presenta como comparable a modelos frontera optimizados en coste, no al nivel más alto absoluto, así que las tareas de razonamiento más difíciles pueden seguir favoreciendo a modelos más grandes.
- La adopción aún es temprana, lo que significa menos ejemplos de la comunidad e integraciones de terceros que en los ecosistemas de LLM dominantes.
- Las tarifas y los nombres de los modelos cambian rápido, así que conviene revisar el precio actual antes de comprometerse.
Preguntas frecuentes
Hay un nivel gratuito para probarlo a través de la plataforma de Inception Labs, pero el modelo en sí se factura por token en producción. En su lanzamiento, Mercury 2.5 se ofreció con un 80% de descuento, lo que salía a 0,04 dólares por millón de tokens de entrada y 0,15 por millón de salida.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Mercury.
Alternativas a Mercury
Sayble
Sayble · Voz e idioma · Productividad · NegociosSayble es un copiloto de IA para llamadas de ventas y reuniones. Escucha a las dos partes, muestra la frase que conviene decir y después redacta el resumen y el correo de seguimiento.
Lattice
Lattice · Escritura · Voz e idiomaLattice es un humanizador de IA gratuito que reescribe textos rígidos o acartonados pasándolos por otros idiomas y devolviéndolos al original, para que suenen a una persona.
Hemory
Beautiful ONES Inc. · Voz e idioma · Productividad · Asistente de IAHemory es una app de memoria con IA siempre activa para iPhone y Apple Watch. Transcribe las conversaciones que te rodean y deja que tus agentes de IA las consulten por MCP.