
MyScale
MOQI SINGAPORE PTE. LTD. · Programación
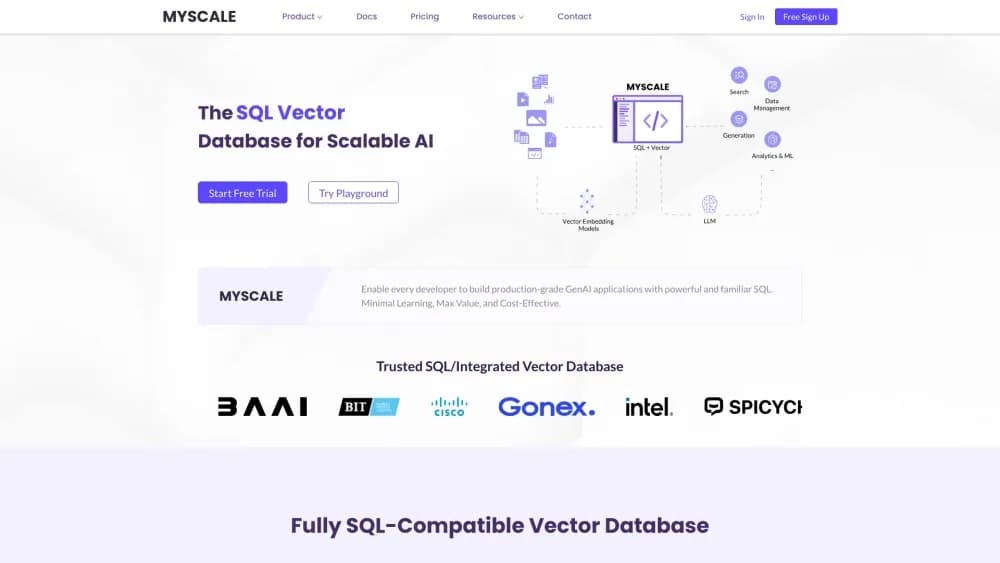
MyScale es una base de datos vectorial SQL sobre ClickHouse. Ejecuta búsqueda vectorial, búsqueda de texto y analítica en un motor que consultas con SQL, ideal para RAG y apps de IA.
Acerca de MyScale
What Is MyScale
MyScale es una base de datos en la nube pensada para aplicaciones de IA, y funciona sobre el motor de código abierto ClickHouse. La idea es simple: guardas datos estructurados, vectores y texto en un mismo sistema, y luego lo consultas todo con el SQL que ya conoces. Su motor, llamado MSTG, está ajustado para búsqueda vectorial a escala de miles de millones, y la empresa asegura que supera a las bases de datos vectoriales dedicadas entre 4x y 10x en velocidad y coste. Ese dato es su propio benchmark, así que verifícalo con tus vectores antes de darlo por bueno.
El problema que resuelve es la dispersión de herramientas. Un stack RAG típico añade un almacén vectorial a una base de datos relacional y a un buscador, y luego mantienes tres sistemas con tres lenguajes de consulta. MyScale los une en uno, así que una sola consulta puede filtrar por metadatos y ordenar por similitud vectorial a la vez. Quien programa conserva sus conocimientos de SQL en lugar de aprender una API vectorial propia.
La contrapartida es que MyScaleDB es joven y más limitada que ClickHouse en sí. Bifurca ClickHouse y modifica el motor de almacenamiento y ejecución para el trabajo vectorial, por lo que puede ir por detrás de la versión original. Hay una versión de código abierto que puedes alojar tú mismo bajo Apache 2.0, pero la experiencia pulida, con el motor MSTG incluido, llega a través de MyScale Cloud.
Getting Started
- Regístrate en myscale.com y lanza un clúster desde la página Clusters.
- Copia el host, el usuario y la contraseña en Connection Details, y conéctate con el cliente de Python, Node.js, Go, JDBC o HTTPS.
- Crea una tabla, inserta tus filas y añade un índice vectorial a la columna de vectores con una métrica como cosine.
- Lanza una búsqueda vectorial en SQL, con ORDER BY distance y LIMIT, o filtra las filas primero con WHERE.
- Conéctala a tu stack mediante las integraciones con OpenAI, LangChain o LlamaIndex, y publica.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de MyScale.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores backend y de IA
- Creadores de RAG
- Equipos de datos
Tareas
- Alimentar la recuperación en RAG
- Búsqueda híbrida
- Búsqueda vectorial filtrada
- Añadir búsqueda semántica a una app
Casos de uso
- Un equipo que lanza su primera función RAG
- Una startup que sustituye un stack de varias bases de datos
- Una app de IA con datos crecientes
Funciones clave
Consultas vectoriales en SQL
MyScale trata la búsqueda vectorial como una operación SQL. Añades un índice vectorial a una columna y luego ordenas las filas con una función de distancia dentro de ORDER BY, mezclada sin problema con WHERE, JOIN y GROUP BY. Si sabes SQL, ya sabes consultar aquí una base de datos vectorial.
Motor vectorial MSTG
El motor MSTG es el algoritmo de indexación propio de MyScale, y usa SSD NVMe para meter más datos por nodo. La empresa dice que así alcanza unas 10x la densidad de datos de configuraciones estándar y supera a las bases vectoriales especializadas en coste. Es su benchmark, así que pruébalo con tus propios vectores antes de decidir.
Búsqueda de texto e híbrida
Junto a los vectores, MyScale incluye un índice de texto completo BM25 con tokenizadores configurables para distintos idiomas. Puedes lanzar la búsqueda de texto por sí sola o combinarla con resultados vectoriales en una consulta híbrida. Para RAG, esa mezcla suele recuperar mejores fragmentos que cualquiera de los dos métodos por separado.
Búsqueda filtrada a cualquier ratio
La búsqueda filtrada es donde muchas bases vectoriales se quedan cortas. MyScale aplica primero el filtro por metadatos y luego busca en las filas restantes, así que la precisión se mantiene incluso cuando un filtro deja solo una porción mínima de una tabla de mil millones de filas. En la práctica, esa es la diferencia entre un resultado limpio y otro lento y difuso.
Gestión de datos unificada
El almacenamiento no se limita a los vectores. MyScale maneja columnas estructuradas, JSON, texto, datos geoespaciales y series temporales en la misma tabla. Un producto, su embedding y su historial de ventas conviven, así que una sola consulta puede unir funciones de IA con datos de negocio.
Integraciones y clientes
MyScale se conecta con OpenAI, LangChain, LangChain JS/TS y LlamaIndex, e incluye clientes para Python, Node.js, Go y JDBC además de una interfaz HTTPS. La mayoría de los equipos la enganchan a un pipeline que ya existe en vez de empezar de cero, y así la migración es corta.
MyScale Telemetry
Telemetry te da observabilidad para sistemas LLM, así que puedes trazar prompts, respuestas y pasos de recuperación en un solo sitio. Depurar un pipeline RAG sin esto es adivinar de dónde salió una mala respuesta; con esto, ves la recuperación que alimentó al modelo.
Seguridad y control de acceso
MyScale ofrece control de acceso basado en roles con SQL y declara cumplimiento con SOC 2 e ISO 27001. Para equipos que manejan datos sensibles, eso da una vía para dar acceso limitado sin exponer todo el clúster.
Ventajas y desventajas
Ventajas
- Como es totalmente compatible con SQL, quien sabe SQL puede lanzar búsqueda vectorial sin aprender una API propia ni un lenguaje de consulta nuevo.
- Búsqueda vectorial, búsqueda de texto y analítica comparten un motor, lo que elimina los servicios extra que necesita un stack RAG típico.
- El motor MSTG apunta a vectores a escala de miles de millones en disco, así que las colecciones grandes no tienen que vivir enteras en memoria.
- La búsqueda filtrada aplica los filtros de metadatos antes de ordenar, lo que mantiene la precisión en consultas selectivas.
- El pod gratuito para 5M vectores de 768D y las integraciones con OpenAI, LangChain y LlamaIndex hacen que probarla sea rápido.
Desventajas
- Las cifras de rendimiento y coste de 4x a 10x salen del benchmark de la propia empresa, así que conviene reproducirlas con tus datos antes de fiarte.
- Como bifurcación de ClickHouse, MyScaleDB puede ir por detrás del motor original y de su conjunto de funciones, algo que importa si necesitas lo último de ClickHouse.
- Las funciones más potentes, incluido el motor MSTG, viven en MyScale Cloud, así que alojar tú mismo la versión de código abierto te deja un producto menos completo.
- No hay app móvil ni de escritorio amplia, así que encaja en trabajo de servidor y pipelines más que en herramientas de usuario final.
Preguntas frecuentes
MyScale almacena y consulta los datos que hay detrás de las apps de IA, sobre todo para la recuperación en sistemas RAG y la búsqueda semántica. Mantienes juntos vectores, texto y filas estructuradas, y luego los consultas con SQL.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con MyScale.
Alternativas a MyScale

Udon
Udon · Programación · ProductividadUdon convierte un Mac con Apple Silicon en un servidor doméstico que se gestiona desde el navegador, con contenedores, archivos compartidos y un administrador de sistemas con IA opcional.

offstage
offstage cloud · Programación · Productividadoffstage da a los agentes de IA y a los trabajos de CI un Mac de verdad: una cuenta de macOS 27 sobre Apple silicon, manejada por API y cobrada por segundo.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programación · ProductividadBotBus te deja controlar desde el móvil y el reloj los agentes de programación con IA que corren en tu ordenador: apruebas comandos, lanzas tareas y lees resultados sin volver al escritorio.