

OpenAI WebSocket Mode for Responses API
OpenAI · Programación
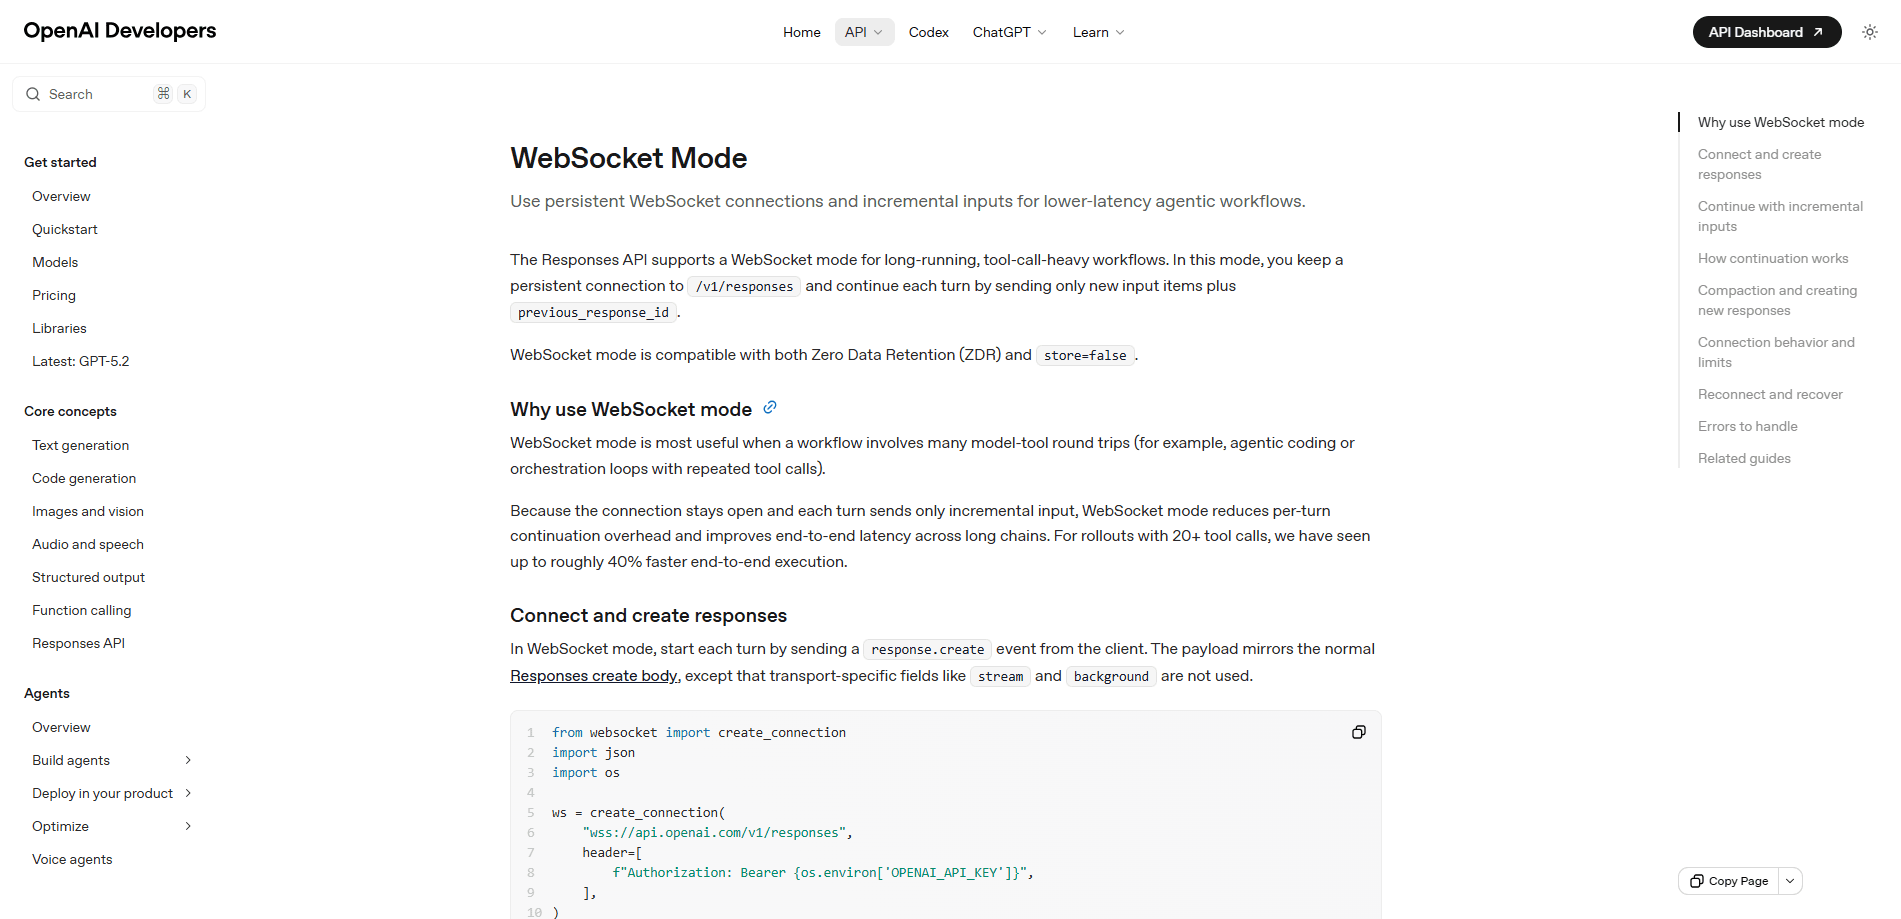
El modo WebSocket de OpenAI para la API Responses es un modo de conexión persistente que te deja ejecutar flujos de agentes largos y cargados de herramientas sobre un único WebSocket en lugar de repetir peticiones HTTP. Abres una conexión al endpoint de Responses y mantienes cada turno ligero enviando solo los elementos de entrada nuevos más un previous_response_id. Está pensado para bucles de codificación agéntica y orquestación donde la misma tarea dispara decenas de llamadas a herramientas, y funciona con store=false en entornos sensibles a la privacidad.
Acerca de OpenAI WebSocket Mode for Responses API
Qué es el modo WebSocket de OpenAI para la API Responses
El modo WebSocket de OpenAI es una opción de transporte para la API Responses, no un producto aparte. La API Responses es la primitiva con estado de OpenAI para construir apps de tipo agente, y es el endpoint donde arrancan casi todos los proyectos nuevos. Lo que cambia es la tubería que hay debajo. Nada más. Todo lo demás sobre tus prompts y tus herramientas sigue igual.
El problema que resuelve es el sobrecoste de continuación. En modo HTTP estándar, cada turno reabre una conexión y reenvías el contexto, que no deja de crecer. Eso va bien para una sola pregunta. Para un agente que llama a herramientas veinte o treinta veces seguidas, todos esos viajes de ida y vuelta se acumulan. El modo WebSocket mantiene la conexión abierta al endpoint de Responses y deja que cada seguimiento envíe solo el delta, encadenado mediante un previous_response_id. No es ciencia ficción. Es solo una tubería mejor.
La mayor limitación es el alcance. Este modo es para flujos largos y cargados de herramientas, no para todo. La propia guía de OpenAI dice que las peticiones puntuales y los chats cortos deberían quedarse en la API Responses por HTTP estándar, donde la optimización apenas aporta. La conexión además tiene un límite de tiempo, así que tendrás que gestionar reconexiones en una ejecución larga. Algo molesto, pero manejable.
Primeros pasos
- Consigue una clave de API de OpenAI e instala un cliente WebSocket como el paquete websocket-client para Python.
- Abre un socket al endpoint WebSocket de Responses y pasa tu clave en la cabecera Authorization.
- Envía tu primer turno con un evento response.create, incluyendo el modelo, las herramientas y la entrada inicial.
- Continúa la conversación enviando un nuevo response.create que referencie el previous_response_id del turno anterior e incluya solo los elementos de entrada nuevos, como function_call_output.
- Lee los eventos del servidor según llegan en streaming y luego cierra el socket o reconecta si alcanzas el límite de tiempo de la conexión.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de OpenAI WebSocket Mode for Responses API.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de backend y de IA que construyen agentes que necesitan bucles de herramientas de baja latencia, ya que el modo apunta al tráfico servidor a servidor.
- Equipos de plataforma que ejecutan cargas de orquestación donde el mismo trabajo llama a herramientas decenas de veces por despliegue.
- Desarrolladores con restricciones de privacidad que necesitan un transporte compatible con store=false y retención cero de datos.
Tareas
- Codificación agéntica
- Manejo de llamadas a herramientas
- Orquestación multiturno
Casos de uso
- Un agente de código que recorre análisis de archivos, generación de parches y ejecución de pruebas sobre un socket vivo.
- Un servicio de backend que coordina varias llamadas a herramientas por petición de usuario, donde importa la latencia por turno.
- Un equipo que quiere recortar el sobrecoste en tráfico de agentes de alto volumen sin tocar su modelo ni sus prompts.
Funciones clave
Conexión persistente al endpoint de Responses
El modo WebSocket mantiene una conexión abierta a la API Responses durante muchos turnos. Lo controlas con eventos response.create, y el primero arranca un turno nuevo igual que una petición normal. Como el socket sigue abierto, te saltas la configuración de conexión que la API de streaming estándar paga en cada turno. Ese sobrecoste es pequeño una vez. En una ejecución larga de agente, ya no lo es.
Entrada incremental con previous_response_id
Cada turno de seguimiento envía solo los elementos de entrada nuevos, más un previous_response_id que enlaza con el turno anterior. No reenvías todo el contexto, y ahí está la mayor parte del ahorro en cadenas largas. El payload del primer turno replica el cuerpo estándar de create, menos los campos exclusivos del transporte como stream y background, que aquí no aplican. Así la petición se mantiene ligera aunque la conversación crezca.
Continuación más rápida para flujos cargados de herramientas
El beneficio estrella aparece cuando un flujo implica muchos viajes de ida y vuelta entre modelo y herramienta. Ese es el mundo de los flujos de agentes de baja latencia, y este transporte se construyó para ellos. La guía de OpenAI apunta a una mejora de velocidad notable en despliegues con muchas llamadas a herramientas, con la ganancia viniendo del camino de continuación y no solo del primer token, que es justo la parte que más tiempo pierde cuando un agente recorre las mismas herramientas una y otra vez. No todos los flujos lo notan. Si tu agente apenas llama a herramientas, no vas a notar gran cosa. Si las llama sin parar, ahí está todo el sentido.
Funciona con store=false y retención cero de datos
El modo WebSocket funciona con store=false y con configuraciones de retención cero de datos, algo que importa si no puedes permitir que OpenAI guarde el estado de las respuestas. El servidor mantiene el estado reciente de la respuesta en memoria durante la vida de la conexión, así que sigues teniendo continuaciones rápidas sin persistir los turnos entre peticiones, que de otro modo dejarían datos atrás en el servidor. Para equipos en entornos regulados o sensibles a la privacidad, esa combinación es la razón para elegir este transporte.
Eventos en streaming y orden iguales al modelo HTTP
Los eventos del servidor y su orden coinciden con el modelo de streaming actual de Responses. Si ya gestionas eventos de streaming por HTTP, las formas de los eventos te resultarán familiares, así que no tienes que reescribir la lógica de tu cliente desde cero. La diferencia está en el canal de entrega, no en el formato del mensaje. Entonces, ¿por qué cambiar? Por velocidad, en los casos donde cuenta. Eso mantiene bajo el coste de migración.
Ventajas y desventajas
Ventajas
- Menor latencia de continuación en flujos con muchas llamadas a herramientas, que es justo donde el modo HTTP más duele.
- Enviar solo la entrada incremental reduce la transmisión repetida y el sobrecoste de configuración de conexión.
- Admite store=false y retención cero de datos, así que los equipos sensibles a la privacidad pueden usarlo.
- Los eventos del servidor y su orden coinciden con el modelo de streaming HTTP, así que el código de cliente existente se adapta fácil.
- Un solo socket abierto encaja mejor en bucles de codificación agéntica y orquestación que peticiones HTTP apiladas.
Desventajas
- Solo merece la pena en flujos largos y cargados de herramientas; los chats cortos y las llamadas puntuales apenas ganan.
- La conexión tiene un límite de tiempo, así que hay que construir lógica de reconexión para agentes de larga duración.
- El transporte es más código que gestionar que una llamada HTTP simple, lo que eleva la complejidad del cliente.
- Sigues pagando las tarifas estándar de uso de la API; el modo recorta la latencia, no el coste por token.
Preguntas frecuentes
Es un modo de transporte que mantiene una conexión WebSocket persistente a la API Responses en vez de hacer una petición HTTP nueva en cada turno. Envías solo los elementos de entrada nuevos y un previous_response_id, lo que recorta el sobrecoste por turno en ejecuciones largas de agente. Piénsalo como quedarte en la línea en lugar de colgar y volver a marcar.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con OpenAI WebSocket Mode for Responses API.
Alternativas a OpenAI WebSocket Mode for Responses API

AI Mock Interview
SQLPad · Programación · AprendizajeAI Mock Interview es una herramienta de práctica integrada en SQLPad que simula entrevistas de trabajo reales y te da comentarios instantáneos tanto sobre lo que dices como sobre cómo lo dices. Eliges una plantilla de puesto o subes una descripción del trabajo, respondes a las preguntas en voz alta en tiempo real y luego revisas una transcripción con notas sobre estructura, claridad y gramática. Está pensada para profesionales de datos que se preparan para puestos de SQL, Python, ingeniería de datos, aprendizaje automático y diseño de sistemas, y funciona por completo en el navegador. No hace falta instalar nada.
Codeflying
Kuafu Technology (Codeflying) · Programación · Marketing · ChatbotCodeflying es un creador de apps con IA que convierte una descripción en lenguaje natural en una web, una app móvil o una mini app que funcionan. Trabaja como creador de apps sin código, así que escribes lo que quieres y un equipo de agentes de IA se encarga de los requisitos, la arquitectura, las pantallas de front-end, la lógica de back-end y el despliegue. El objetivo es sencillo: crear una app desde un prompt, incluso sin experiencia en programación. También incluye herramientas de marketing y un agente de chat para clientes, así que el resultado es más que un prototipo olvidado en un disco duro.
Runware
Runware, Inc. · Imagen · Vídeo · ProgramaciónRunware es una plataforma de inferencia de IA generativa que da a los desarrolladores una sola API para modelos de imagen, vídeo, audio, 3D y lenguaje. En lugar de registrarte en una docena de proveedores, llamas a un único endpoint, cambias de modelo con una línea de código y pagas solo por las peticiones que envías. No hay servidores que mantener. Está pensada para equipos que quieren lanzar funciones de IA rápido sin montar ni cuidar su propia infraestructura de GPU.