
Parallax by Gradient
Gradient · Otro
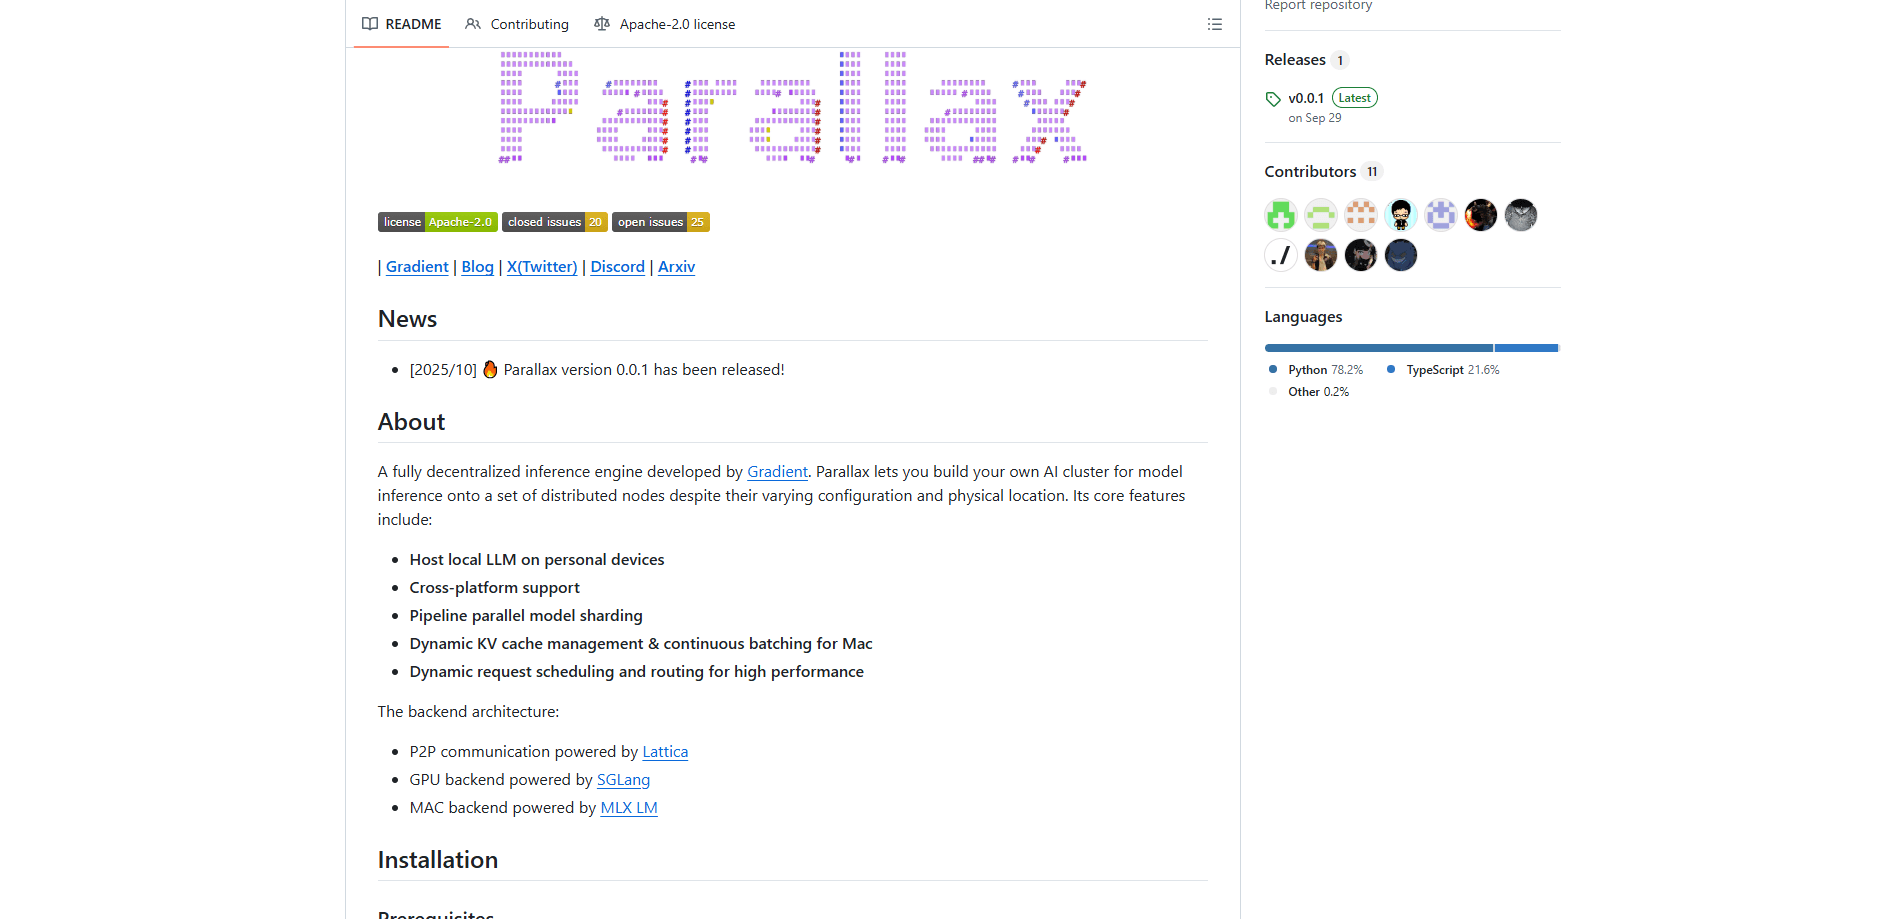
Parallax by Gradient es un motor de inferencia totalmente descentralizado con el que montas tu propio clúster de IA para ejecutar modelos de lenguaje grandes en varios dispositivos, por muy distintos que sean sus componentes o el lugar donde estén físicamente. En lugar de alquilar GPU en la nube, reúnes las máquinas que ya tienes y sirves modelos como Qwen, DeepSeek y GLM desde un único endpoint local.
Acerca de Parallax by Gradient
Qué es Parallax by Gradient
Parallax es un marco de trabajo de código abierto para clústeres de IA distribuidos, creado por Gradient. Divide un modelo de lenguaje grande entre varias máquinas y ejecuta la inferencia en todas a la vez, así que un portátil, un sobremesa con GPU y un pequeño servidor al otro lado de la red doméstica actúan como una sola máquina más grande. Todo habla un protocolo entre pares, lo que significa que no hay un servidor central que deba permanecer en línea. Esa es la propuesta.
El problema que resuelve es fácil de enunciar y doloroso de vivir. Ejecutar un LLM competente normalmente implica pagar por token a un proveedor en la nube o comprar una GPU carísima que quepa en el modelo completo. Parallax toma una tercera vía. Fragmenta el modelo capa por capa y transmite las peticiones por el hardware que tengas, así que aprovechas más los dispositivos que ya están sobre tu escritorio. Tus prompts y resultados se quedan en tus propias máquinas, algo que importa si manejas material que prefieres no enviar a terceros.
La limitación principal es que es una herramienta para desarrolladores, no una app de instalar con un clic. Te sentirás cómodo en la terminal y, en Linux, ten por seguro que tocarás Docker o configurarás controladores de GPU. El proyecto es joven. La versión 0.0.1 llegó en octubre de 2025, así que cabe esperar asperezas y el soporte de modelos cambia cada poco. Si quieres algo que funcione nada más sacarlo de la caja, sin configurar nada, una API alojada te tratará mejor.
Primeros pasos
- Instala el cliente clonando el repositorio y ejecutando
./install.sh, que prepara un entorno virtual de Python y compila los binarios necesarios. Los usuarios de Windows pueden descargar un instalador independiente. - Activa el entorno con
source .venv/bin/activatey confirma que se detectaron los extras de tu hardware, porque las compilaciones de GPU de macOS y Linux instalan componentes de backend distintos. - Arranca el nodo local con un comando como
parallax serve -m Qwen/Qwen3.5-0.8B, eligiendo un modelo que quepa en tu memoria combinada. - Une más máquinas al mismo clúster para que los fragmentos del modelo abarquen todos los dispositivos que hayas añadido.
- Apunta tu app o script al endpoint local y envía peticiones como lo harías a cualquier API compatible con OpenAI.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Parallax by Gradient.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que ya tienen unas cuantas máquinas y quieren ejecutar cargas de LLM autoalojadas sin facturas de nube, siempre que no les importe trabajar desde la terminal.
- Equipos atentos a la privacidad que manejan texto sensible y prefieren mantener la inferencia en hardware local antes que enviar prompts a una API alojada.
- Aficionados con curiosidad por los montajes de clúster de IA distribuidos y ganas de dedicar una tarde a la configuración.
Tareas
- Alojar un endpoint de LLM compartido para un laboratorio doméstico u oficina pequeña donde varias personas apuntan sus herramientas a un mismo servidor local.
- Probar y comparar modelos abiertos como Qwen, DeepSeek o GLM en hardware real en lugar de pagar por cada ejecución de benchmark.
- Construir agentes y herramientas internas que necesiten un backend de inferencia de IA local, sin dependencia de un proveedor ni límite de uso.
Casos de uso
- Un proyecto de fin de semana para exprimir un modelo más grande con un portátil más un sobremesa de repuesto con GPU.
- Ejecutar un asistente de código en las máquinas de la oficina para que no salga ningún código fuente del edificio.
- Experimentar con la fragmentación de modelos por paralelismo de pipeline para ver hasta dónde llega el hardware de consumo sumado.
- Cualquiera que quiera ejecutar un LLM en local entre un par de máquinas mixtas y saltarse la nube por completo.
Funciones clave
Fragmentación distribuida del modelo
Parallax divide un modelo entre dispositivos usando paralelismo de pipeline, así que cada máquina solo guarda una porción de la red en lugar de toda ella. Eso es lo que permite que hardware con especificaciones muy distintas coopere en un mismo modelo. Puedes ampliar el clúster añadiendo nodos, y el marco ajusta cómo se reparte el trabajo.
Clúster independiente del hardware
El motor no exige máquinas idénticas. Resuelve la parte difícil de enrutar peticiones entre nodos con distinta configuración y ubicación física, que es justo el sentido de un montaje descentralizado. Un Mac, un equipo Linux con GPU y una máquina Windows pueden participar en el mismo clúster.
Comunicación entre pares
Los nodos hablan entre sí mediante Lattica, una capa P2P, así que no hay un único punto de fallo en la red. Si un nodo se cae, el clúster no se derrumba con él. Este diseño es lo que hace que ejecutar el clúster "en cualquier parte" sea algo más que una frase de marketing.
Compatibilidad multiplataforma
Puedes instalar Parallax en Windows, Linux y macOS. El backend de GPU se apoya en SGLang y vLLM, mientras que los Mac funcionan con MLX LM. Las rutas de instalación cambian según el sistema, y el proyecto incluye un instalador para Windows más imágenes Docker para máquinas con GPU. La recompensa es alojamiento de LLM realmente multiplataforma: un clúster, varios sistemas operativos, sin tocar el código.
Gestión optimizada de peticiones
En Mac, Parallax añade gestión de caché KV paginada y batching continuo, técnicas que mantienen a raya el uso de memoria mientras atiende muchas peticiones. La planificación de peticiones se ajusta sobre la marcha para decidir qué nodo atiende cada cosa, con el objetivo de mantener alto el rendimiento en todo el clúster.
Servicio compatible con OpenAI
Una vez que un nodo está funcionando, expone un endpoint que tus herramientas actuales pueden llamar casi como una API alojada. Eso significa que las apps, scripts y agentes que ya has construido no necesitan reescribirse. El proyecto también documenta una vía de integración para OpenClaw.
Ventajas y desventajas
Ventajas
- Gratis y de código abierto, así que no hay factura por token y puedes leer exactamente cómo funciona la inferencia.
- Convierte hardware que ya tienes en un clúster de LLM operativo, incluidas máquinas de características dispares.
- Mantiene los prompts y los resultados en tus propios dispositivos, lo que ayuda con la privacidad y el cumplimiento.
- El soporte multiplataforma permite compartir un mismo despliegue entre Macs y máquinas Linux con GPU.
- La arquitectura P2P evita un servidor central, así que no hay un único punto de fallo.
Desventajas
- La configuración es de nivel desarrollador. No es una app de un clic, y las instalaciones de GPU en Linux pueden implicar Docker o trabajo con controladores.
- El proyecto está en fase temprana. Cuenta con soporte de modelos cambiante y fallos ocasionales.
- El rendimiento depende por completo de tu hardware; los dispositivos de consumo sumados no igualarán a un clúster de GPU en la nube.
- La documentación aún se está completando, así que parte del diagnóstico pasa por leer el repositorio o preguntar en Discord.
Preguntas frecuentes
Sí. Parallax by Gradient es de código abierto y gratis, sin suscripción. Solo pagas la electricidad y el hardware en el que ya lo ejecutas. No hay nivel de pago, así que el precio de "$0" cubre todo el producto.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Parallax by Gradient.
Alternativas a Parallax by Gradient
BinkBink
BinkBink · OtroBinkBink es una plataforma de juegos online gratuita y un creador de juegos con IA que deja que cualquiera convierta una breve descripción de texto en un juego de navegador jugable. Puedes meterte en cientos de juegos hechos por la comunidad. O describes tu propia idea y la juegas en segundos, y luego la compartes con amigos. ¿Quieres crear tu propio juego? No necesitas programar. Sin configurar un motor, sin descargas, sin complicaciones.

Audiogen
Audiogen Inc. · OtroAudiogen es un generador de música con IA creado por Audiogen Inc., un equipo de investigación pequeño que pasó unos 2,5 años entrenando su propio modelo de música generativa y diseñando una interfaz web a su alrededor. En lugar de un simple cuadro de texto, esta herramienta de música con IA convierte la línea de tiempo en una Estación de Trabajo de Audio Generativo (GAW, por sus siglas en inglés), pensada para principiantes, donde el inpainting, la extensión, la remezcla y la edición de pistas funcionan más como pintar sobre un lienzo. El producto sigue en beta, así que el acceso pasa por una lista de espera o una invitación. Los planes de pago todavía no están publicados.

Aiml API
AIMLAPI OÜ · OtroAiml API es una API unificada de modelos de IA que pone más de 1000 modelos de OpenAI, Google, Anthropic y otros detrás de un solo endpoint y una sola factura. Escribes código contra un único esquema compatible con OpenAI y luego cambias entre modelos de chat, imagen, vídeo y audio modificando una cadena de modelo. Encaja con desarrolladores y equipos pequeños que quieren acceso multimodelo sin manejar una docena de cuentas de proveedor distintas, y elimina el dolor de cabeza habitual de la facturación cuando pruebas varios vendedores. Una sola clave lo cubre todo.