
PDFMerse
PDFMerse · Programación · Productividad
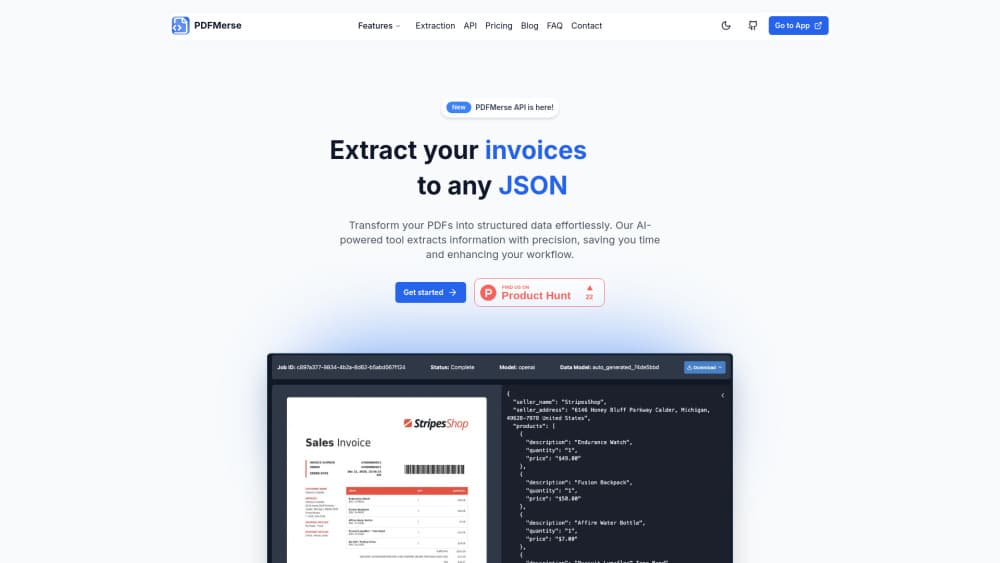
PDFMerse es una herramienta de IA que extrae datos de cualquier PDF y los convierte en datos estructurados como JSON o CSV, pensada para equipos que necesitan documentos convertidos en filas utilizables.
Acerca de PDFMerse
Qué es PDFMerse
PDFMerse es una herramienta de extracción de datos de PDF con IA. Le das un documento, lee la maquetación como lo haría una persona y te devuelve datos estructurados que puedes ordenar, filtrar o cargar en una base de datos. La propuesta es sencilla: dejar de copiar a mano los números de facturas, informes y extractos. Eso es todo.
Mucha gente busca primero cómo extraer datos de archivos PDF cuando el método manual acaba agotándola. PDFMerse responde a esa necesidad directamente.
La herramienta apunta a un problema concreto. Casi todos los PDF están hechos para imprimirse, no para procesarse. El texto cae en columnas raras, las tablas se cortan entre páginas y las páginas escaneadas son solo imágenes. Sacar datos de esos archivos con un convertidor normal te deja un montón de texto ilegible que todavía necesita horas de limpieza antes de servir. PDFMerse trata la extracción como un problema de comprensión, así que el resultado conserva su estructura.
El detalle es que ninguna herramienta de extracción es perfecta, y PDFMerse no finge lo contrario. La precisión depende de lo limpios que estén tus archivos. Una factura digital nítida se procesa mucho mejor que la foto torcida de un recibo hecha con el móvil. Si esperas un 100 % de precisión en cada página, te vas a decepcionar. Cuenta con revisar el resultado por muestreo, sobre todo en la primera pasada con un tipo de documento nuevo.
Cómo empezar
- Crea una cuenta en el sitio de PDFMerse e inicia sesión en tu panel.
- Sube un PDF o conecta la fuente de la que vienen tus documentos.
- Define los campos que quieres recuperar, como número de factura, fecha, total o proveedor.
- Ejecuta la extracción y deja que la IA lea cada página.
- Revisa el resultado estructurado y expórtalo como JSON o CSV para tu hoja de cálculo, base de datos o API.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de PDFMerse.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Equipos de finanzas y contabilidad
- Personal de operaciones y administración
- Ingenieros de datos y operaciones
Tareas
- Extracción de datos de facturas
- Digitalización de informes
- Procesamiento de formularios
Casos de uso
- Contabilidad de fin de mes
- Trabajo de investigación y encuestas
- Migración de registros en papel
Funciones clave
PDF a datos estructurados
La tarea principal es convertir un PDF en datos estructurados que puedas usar en otro sitio. PDFMerse lee el documento, identifica los campos que te interesan y los devuelve en un formato ordenado en vez de como un muro de texto. La diferencia importa cuando llevas el resultado a una hoja de cálculo o a una base de datos, donde una columna limpia gana a un copiar y pegar cualquier día.
Definición de campos personalizados
Tú decides qué extraer. En lugar de confiar en que la herramienta acierte, fijas los nombres de campo que quieres, como número de factura, fecha de vencimiento o importe total. Así el resultado encaja con el sistema en el que lo cargas y pasas menos tiempo rehaciendo los datos después.
Exportación a JSON y CSV
Los datos extraídos salen en formatos que tus otras herramientas ya entienden. ¿Quieres PDF a JSON para un flujo de desarrollo? Hecho. ¿Necesitas PDF a CSV para una hoja de cálculo? También funciona. El JSON le va a desarrolladores y flujos con API, mientras que el CSV entra directo en Excel o Google Sheets para quien vive en hojas de cálculo. Tener los dos evita un paso de conversión por medio.
Con maquetaciones complejas
Los PDF reales no son ordenados. Las tablas cruzan páginas, las columnas van en paralelo y los encabezados se repiten. Entonces, ¿qué pasa cuando una tabla se parte en tres páginas con un encabezado repetido que no quieres copiar dos veces? La IA está preparada para leer esas maquetaciones en un orden sensato en vez de agarrar el texto por posición y destrozarlo. Ahí es donde una herramienta de extracción útil se distingue de un volcado de texto plano.
Precisión con documentos desordenados
Los documentos varían muchísimo, y la extracción debe aguantar ese abanico. Un archivo digital bien formado se extrae limpio; una página escaneada o una captura de baja calidad cuesta más y puede necesitar un repaso. Un escaneo claro de una factura estándar de un proveedor conocido suele salir casi perfecto, mientras que un recibo arrugado fotografiado con un móvil viejo y con mala luz pondrá a prueba al modelo y a tu paciencia. Saber en qué grupo caen tus archivos te dice cuánta revisión hay que reservar.
Procesamiento de documentos por lotes
Cuando trabajas con más de un archivo, el manejo por lotes es lo que ahorra tiempo de verdad. La meta no es una extracción única y perfecta, sino despachar una cola de facturas o formularios de una pasada. Ahí es donde un extractor de datos de PDF justifica su precio frente a hacer el mismo trabajo a mano. Le das cincuenta extractos y te vas. Vuelves a una tabla.
Ventajas y desventajas
Ventajas
- Convierte los PDF en JSON o CSV estructurado en vez de dejarte texto en bruto.
- Las definiciones de campos personalizados mantienen el resultado adaptado a tu flujo de trabajo.
- Lee maquetaciones complejas, incluidas páginas a varias columnas y tablas.
- Maneja documentos escaneados e imperfectos razonablemente bien.
- Reduce el tecleo manual en documentos repetitivos como facturas y formularios.
Desventajas
- La precisión baja con escaneos de poca calidad, así que tendrás que revisar esos resultados.
- Solo funciona en el navegador, sin app de escritorio ni versión móvil para uso sin conexión.
- Los precios y niveles de plan exactos pueden cambiar, así que confirma los detalles actuales en el sitio oficial antes de decidirte.
- Los datos públicos sobre el acceso a la API son escasos, lo que es un problema si buscas automatizar a escala.
Preguntas frecuentes
Extrae datos de documentos PDF y los devuelve como salida estructurada, como JSON o CSV. Subes un archivo, le dices qué campos quieres y lee el documento para sacar esos valores.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con PDFMerse.
Alternativas a PDFMerse

Udon
Udon · Programación · ProductividadUdon convierte un Mac con Apple Silicon en un servidor doméstico que se gestiona desde el navegador, con contenedores, archivos compartidos y un administrador de sistemas con IA opcional.

offstage
offstage cloud · Programación · Productividadoffstage da a los agentes de IA y a los trabajos de CI un Mac de verdad: una cuenta de macOS 27 sobre Apple silicon, manejada por API y cobrada por segundo.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programación · ProductividadBotBus te deja controlar desde el móvil y el reloj los agentes de programación con IA que corren en tu ordenador: apruebas comandos, lanzas tareas y lees resultados sin volver al escritorio.