
Polarity
Polarity · Programación
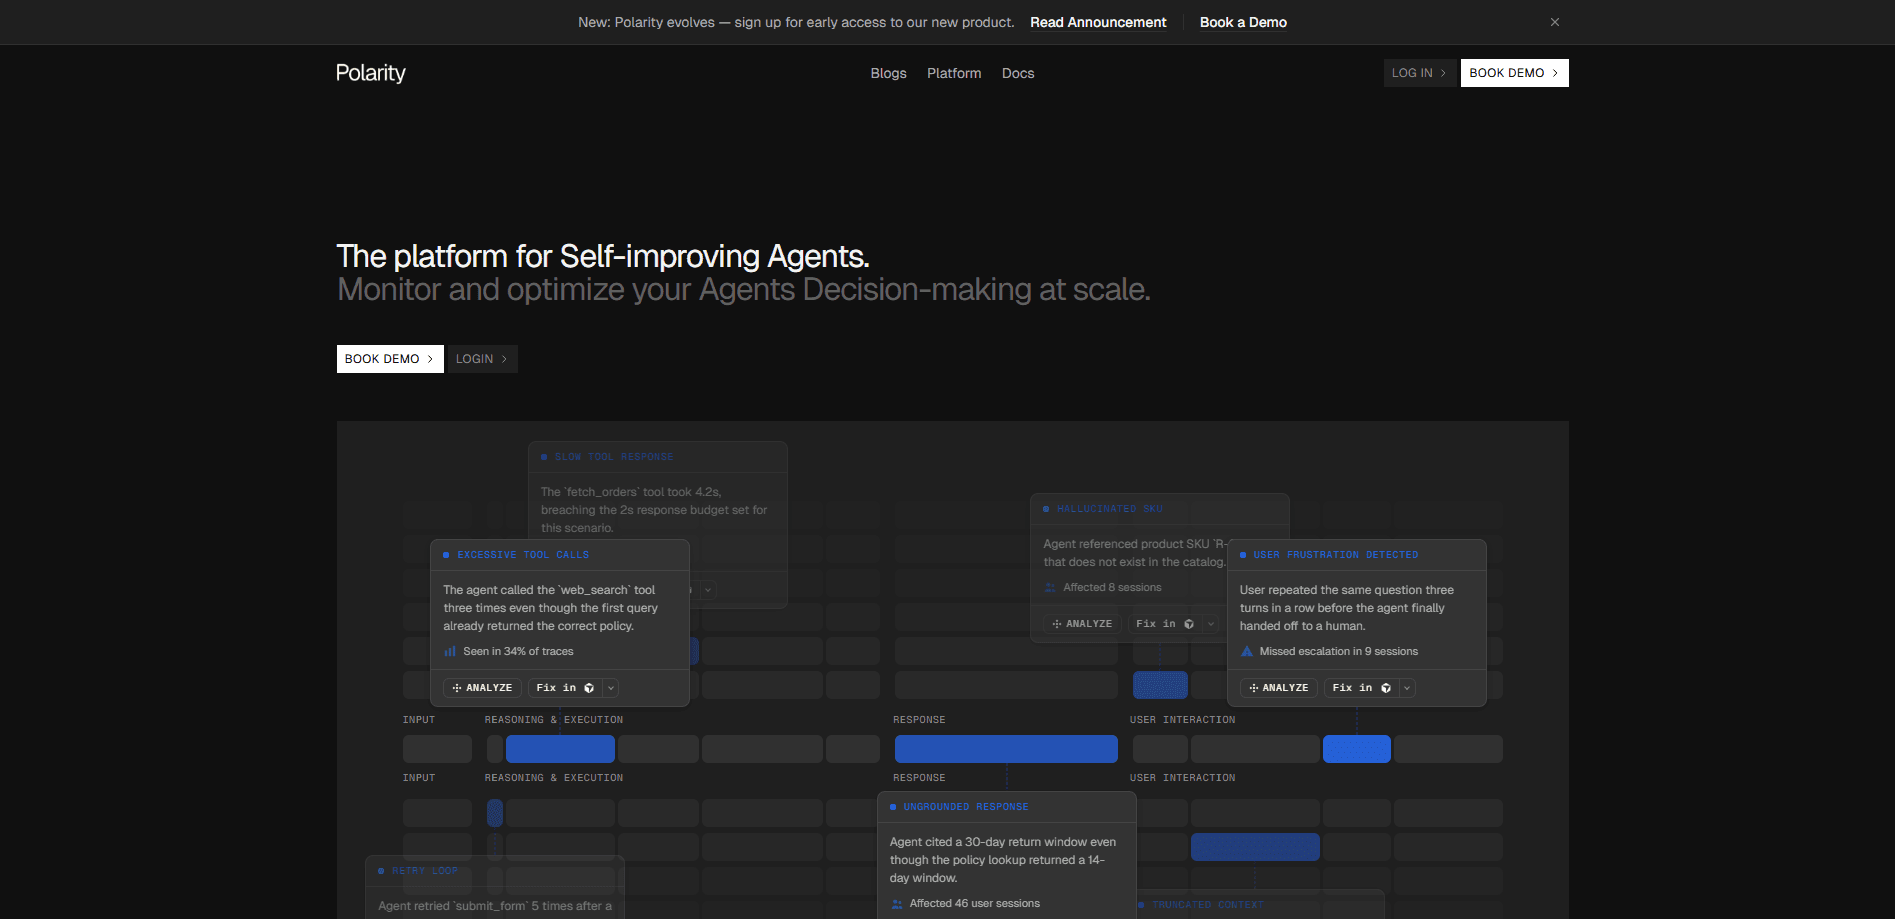
Polarity es una plataforma de evaluación y monitoreo en sandbox para agentes de IA. Ejecuta tu agente dentro de entornos Docker aislados con servicios reales de respaldo, puntúa lo que hace el agente frente a invariantes y reglas prohibidas, y mide cuánto varía su comportamiento entre ejecuciones repetidas. Piénsalo como una herramienta de evaluación de agentes que trata el comportamiento en vivo como la prueba. Cuando una ejecución falla, la reproducción basada en semilla te deja reconstruir las condiciones exactas y depurar el fallo en lugar de adivinar.
Acerca de Polarity
Qué es Polarity
Polarity es una plataforma de evaluación pensada para equipos que despliegan agentes de IA. En lugar de probar los agentes contra un simulacro escrito, los ejecuta en un entorno Docker en sandbox conectado a servicios reales de respaldo, así el agente ve las mismas APIs, bases de datos y herramientas que tocaría en producción. Esa configuración importa, porque la mayoría de los fallos de un agente no vienen de una respuesta mala. Vienen de que el agente toma una acción que nadie quería.
La plataforma revisa dos cosas a la vez. Primero, si cada ejecución respeta las reglas que definiste, que Polarity divide en invariantes que siempre deben cumplirse y reglas prohibidas que nunca deben activarse. Segundo, cuán estable es el comportamiento. Correr la misma tarea en varias réplicas saca a la luz la no determinación que una sola pasada ocultaría por completo. Y esa distinción importa, porque un agente que pasa una ejecución y falla la siguiente es el tipo que rompe producción en silencio mucho después de que todos dejaron de mirarlo.
El límite principal es el alcance. Polarity es una herramienta para desarrolladores, no una app de consumo, así que necesitas tu agente empaquetado y tus servicios de respaldo accesibles desde el sandbox antes de obtener valor. Los equipos que aún no tienen pruebas automatizadas pasarán sus primeros días conectando todo.
Primeros pasos
- Entra en el sitio de Polarity y crea un proyecto para el agente que quieres evaluar.
- Apunta el proyecto a tu agente y define los servicios de respaldo que necesita, para que el sandbox arranque con las mismas dependencias que tiene producción.
- Escribe tus invariantes y reglas prohibidas como los controles contra los que se puntúa cada ejecución.
- Corre una tarea en una o más réplicas para ver si el comportamiento se mantiene estable o se desvía entre intentos.
- Abre cualquier fallo, reprodúcelo desde su semilla y corrige la causa raíz antes de desplegar.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Polarity.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Equipos de ingeniería de IA
- Ingenieros de plataforma e infraestructura
- Responsables de QA y fiabilidad
Tareas
- Puntuar el comportamiento del agente
- Detectar la no determinación
- Depurar fallos
- Pruebas de regresión de agentes antes del lanzamiento
Casos de uso
- Desplegar un agente nuevo en producción
- Depurar un fallo intermitente del agente
- Auditar un agente tras cambiar de modelo
Funciones clave
Ejecuciones en sandbox con servicios reales
Polarity ejecuta cada tarea del agente dentro de un sandbox Docker para agentes de IA, no en un banco de pruebas simulado. El sandbox está conectado a servicios reales de respaldo, así el agente interactúa con APIs y almacenes de datos genuinos durante la evaluación. Eso significa que el comportamiento que puntúas se acerca más a lo que los usuarios vivirán de verdad.
Puntuación con invariantes y reglas prohibidas
Cada ejecución se califica contra dos tipos de regla. Las invariantes describen condiciones que deben cumplirse en toda ejecución, mientras que las reglas prohibidas nombran las acciones que nunca deben ocurrir. Escribirlas obliga a un equipo a ponerse de acuerdo sobre qué significa "correcto", que suele ser la parte más difícil.
Medición de la no determinación
Los agentes no se comportan igual todas las veces, y una única ejecución exitosa prueba muy poco. Polarity corre la misma tarea en varias réplicas y compara los resultados, así ves cuánto se desvía el agente entre intentos. Una varianza alta suele ser la primera señal de un prompt frágil o de una herramienta inestable.
Reproducción basada en semilla
Cuando una ejecución falla, Polarity puede reproducirla desde su semilla original. La reproducción reconstruye las mismas condiciones que produjeron el fallo, lo que convierte un bug intermitente en algo que puedes inspeccionar, corregir y verificar. Para los equipos acostumbrados a perseguir agentes inestables a mano, esta es la función que más tiempo ahorra.
Monitoreo para agentes desplegados
La evaluación no termina en la revisión de código. Polarity también se ocupa del monitoreo de agentes de IA una vez que están corriendo, y puntúa el comportamiento en vivo contra las mismas reglas que usaste en las pruebas. Detectas una violación de reglas en producción en lugar de enterarte por un usuario.
Ventajas y desventajas
Ventajas
- Los servicios reales en el sandbox hacen que las puntuaciones reflejen el comportamiento en producción, no un simulacro simplificado.
- La puntuación con invariantes y reglas prohibidas da una definición clara y testeable de comportamiento correcto.
- Las ejecuciones en réplica hacen visible la no determinación, algo que la mayoría de las herramientas de evaluación de una sola pasada se pierden.
- La reproducción basada en semilla acorta el ciclo de depuración de fallos intermitentes.
- El monitoreo extiende el mismo conjunto de reglas desde las pruebas hasta producción.
Desventajas
- No hay plan gratuito y los precios no se publican, así que tienes que hablar con ventas antes de poder juzgar el costo.
- Es una herramienta para desarrolladores, así que obtener valor depende de que tu agente y sus servicios ya estén empaquetados para correr en un sandbox.
- Almacenar y ejecutar servicios reales de respaldo aumenta el esfuerzo de configuración y el costo de infraestructura frente a las herramientas de evaluación basadas en simulacros.
- No es ideal para equipos que solo quieren una demo rápida. Polarity asume que ya estás probando.
Preguntas frecuentes
Evalúa y monitorea agentes de IA. Tú defines reglas, Polarity corre tu agente en un entorno Docker en sandbox con servicios reales, puntúa cada ejecución contra esas reglas y te deja reproducir los fallos. Entonces, ¿qué te aporta eso? Menos sorpresas cuando el agente sale a producción.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Polarity.
Alternativas a Polarity
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.