
PredictOPs
PredictOPs · Programación · Marketing
PredictOPs es una plataforma de operaciones con IA generativa para equipos de TI y DevOps. Monitoriza logs, correlaciona alertas, detecta anomalías y anticipa la tasa de fallos en microservicios e infraestructura.
Acerca de PredictOPs
About
Qué es PredictOPs
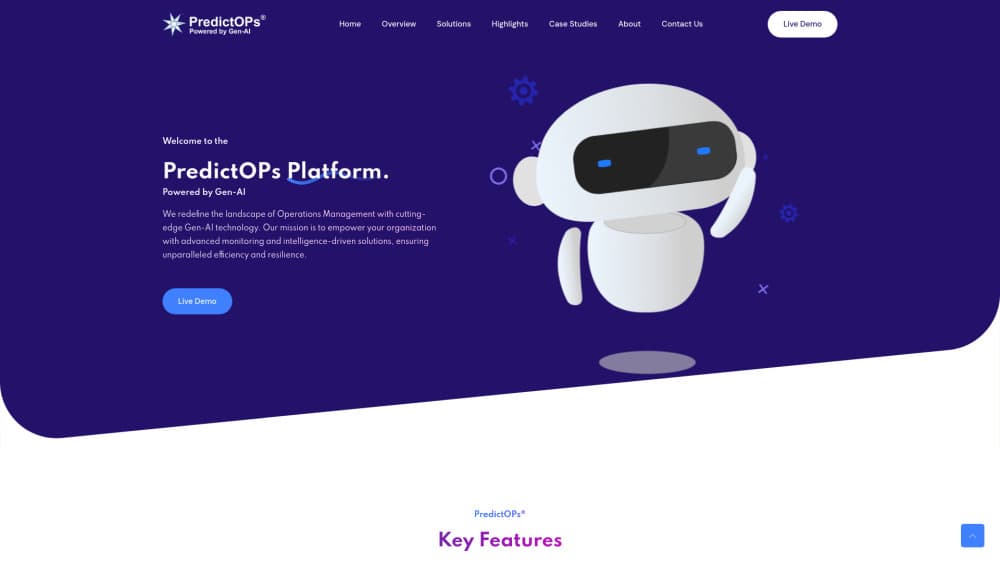
PredictOPs es una plataforma AIOps construida alrededor de una idea: detectar los problemas operativos antes de que los reporten los usuarios. Recoge los logs de los sistemas que ya tienes en marcha, agrupa las alertas que comparten origen en un solo incidente y usa aprendizaje automático para señalar comportamientos que se alejan de la línea base aprendida. La empresa lo llama Gen-AIOps porque añade una capa de IA generativa al trabajo habitual de monitorización y correlación. Esa mezcla de previsión y vigilancia diaria es lo que el fabricante denomina operaciones predictivas.
El producto apunta a equipos con arquitecturas de microservicios. En lugar de revisar una docena de paneles, obtienes una vista conjunta de la salud de los servicios, los grupos de alertas y las tendencias de fallo. PredictOPs dice que encaja en entornos cloud y on-premises y que se conecta a herramientas de monitorización de terceros, así que convive con los colectores que ya pagas. El fabricante también afirma que sus algoritmos están escritos en Python y cubiertos por una patente en trámite.
Los límites pesan tanto como la lista de funciones. No hay tarifas públicas ni registro por cuenta propia, así que la conversación con ventas va primero. La calidad de la detección depende del historial que guardes y de lo limpios que estén esos logs. Además, las cifras de rendimiento de la web las firma el propio fabricante y no hay ninguna comparación independiente publicada. La prueba real es un piloto con tus datos.
Cómo empezar
- Pide una demo desde la web de PredictOPs. Prepara una llamada sobre tu stack, el volumen de logs y si trabajas en cloud, en tus servidores o en ambos.
- Conecta las fuentes de logs y las herramientas de monitorización. La plataforma se coloca encima de los colectores existentes, no los sustituye.
- Deja que el sistema aprenda una línea base y define después las reglas de alerta y su gravedad. El ajuste inicial decide si la detección de anomalías ayuda o solo añade ruido.
- Trabaja los incidentes desde el panel. Las alertas correlacionadas, la salud de los microservicios y las tendencias de fallo aparecen en el mismo sitio.
- Revisa las tendencias cada semana. El análisis del comportamiento de los logs de infraestructura y la tasa de fallos sirven cuando alguien actúa sobre los patrones que muestran.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de PredictOPs.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Equipos de DevOps y SRE con microservicios
- Responsables de operaciones de TI en empresas medianas
- Administradores de sistemas en entornos híbridos
Tareas
- Reducir el ruido de alertas tras un pico de incidentes
- Localizar el servicio detrás de una regresión de latencia
- Prever qué componentes fallarán
- Preparar una revisión de fiabilidad
Casos de uso
- Un despliegue de microservicios que cambia los patrones de tráfico
- Un equipo que ya recoge logs pero no tiene capa analítica
- Un entorno on-premises o híbrido
Funciones clave
Monitorización de logs
PredictOPs ingiere los logs y los presenta con visibilidad en tiempo real, no como una caja de búsqueda en bruto. El objetivo es mostrar patrones y valores atípicos cuando aparecen, no horas después durante el análisis del incidente. Si ya envías logs a un almacén, mantienes esa tubería y añades encima la analítica de operaciones de TI.
Correlación de alertas
Es la función que más afecta al trabajo diario. La plataforma agrupa las alertas que comparten una causa y reduce la lluvia de notificaciones que recibe la persona de guardia. El fabricante lo presenta como claridad del incidente: menos avisos y una lectura más rápida de la causa raíz. Las reglas de correlación necesitan ajuste, sobre todo en entornos ruidosos.
Gestión de microservicios
Ofrece una vista de extremo a extremo de la arquitectura de microservicios, con datos de salud y rendimiento de cada servicio. También cubre el comportamiento del autoescalado, así que puedes comprobar si el escalado siguió el ritmo de la demanda. Para equipos con decenas de servicios, eso evita juntar capturas de herramientas separadas.
Detección de anomalías
La detección de anomalías aprende cómo se comporta tu sistema y señala las desviaciones. El fabricante asegura que los algoritmos se adaptan cuando cambia el comportamiento, y ahí está la diferencia frente a un umbral fijo. Rinde mejor con varias semanas de historial limpio y necesita revisión humana antes de tratar un aviso como fallo confirmado.
Análisis del comportamiento de los logs de infraestructura
Esta función observa cómo evolucionan los logs de infraestructura con el tiempo, no solo si una línea coincide con un patrón de error. El uso práctico está en capacidad y rendimiento: detectar un disco que se llena más rápido cada semana o un nodo que reinicia más que sus vecinos. PredictOPs lo presenta como base para ajustar el rendimiento.
Análisis de la tasa de fallos
El análisis de tasa de fallos mide con qué frecuencia fallan los componentes y si la tendencia sube. Así los equipos de operaciones pueden priorizar mantenimiento en vez de reaccionar a la alerta más ruidosa. El fabricante lo vende como trabajo proactivo, y su valor depende de actuar sobre la tendencia antes del corte.
Ventajas y desventajas
Ventajas
- Reúne monitorización de logs, correlación de alertas, detección de anomalías y análisis de fallos en una sola plataforma AIOps, lo que reduce el número de herramientas que debe gestionar un equipo de operaciones.
- La capa de IA generativa apunta a explicar y encontrar patrones, no solo a dibujar gráficas, así que puede acortar el camino entre una alerta y su causa probable.
- Admite despliegues en cloud y on-premises, una ventaja real para entornos regulados o híbridos.
- La monitorización de microservicios cubre el comportamiento del escalado, útil durante picos de tráfico y despliegues.
- El fabricante ofrece una demo antes de comprar, así que puedes probar el análisis con tus propios logs.
Desventajas
- Sin precios públicos ni plan gratuito. No puedes evaluar el coste ni hacer una prueba por tu cuenta sin hablar con ventas.
- La calidad de la detección depende del volumen y el historial de logs. Un conjunto pequeño o desordenado produce líneas base débiles y más falsos avisos.
- No hay comparaciones independientes publicadas, así que las cifras de rendimiento salen del material del propio fabricante.
- El conjunto de funciones es amplio, pero el flujo está pensado para operaciones de TI. Los equipos fuera de DevOps encontrarán poco para analítica o previsión de negocio.
Preguntas frecuentes
PredictOPs sirve para monitorizar operaciones de TI con IA. Recoge logs, correlaciona alertas relacionadas, detecta anomalías y analiza la tasa de fallos para que los equipos corrijan problemas antes de que se conviertan en cortes. Sus usuarios principales son equipos de DevOps, SRE y administración de sistemas.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con PredictOPs.
Alternativas a PredictOPs
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.