

QAgent
QAgent Inc. · Programación · Negocios
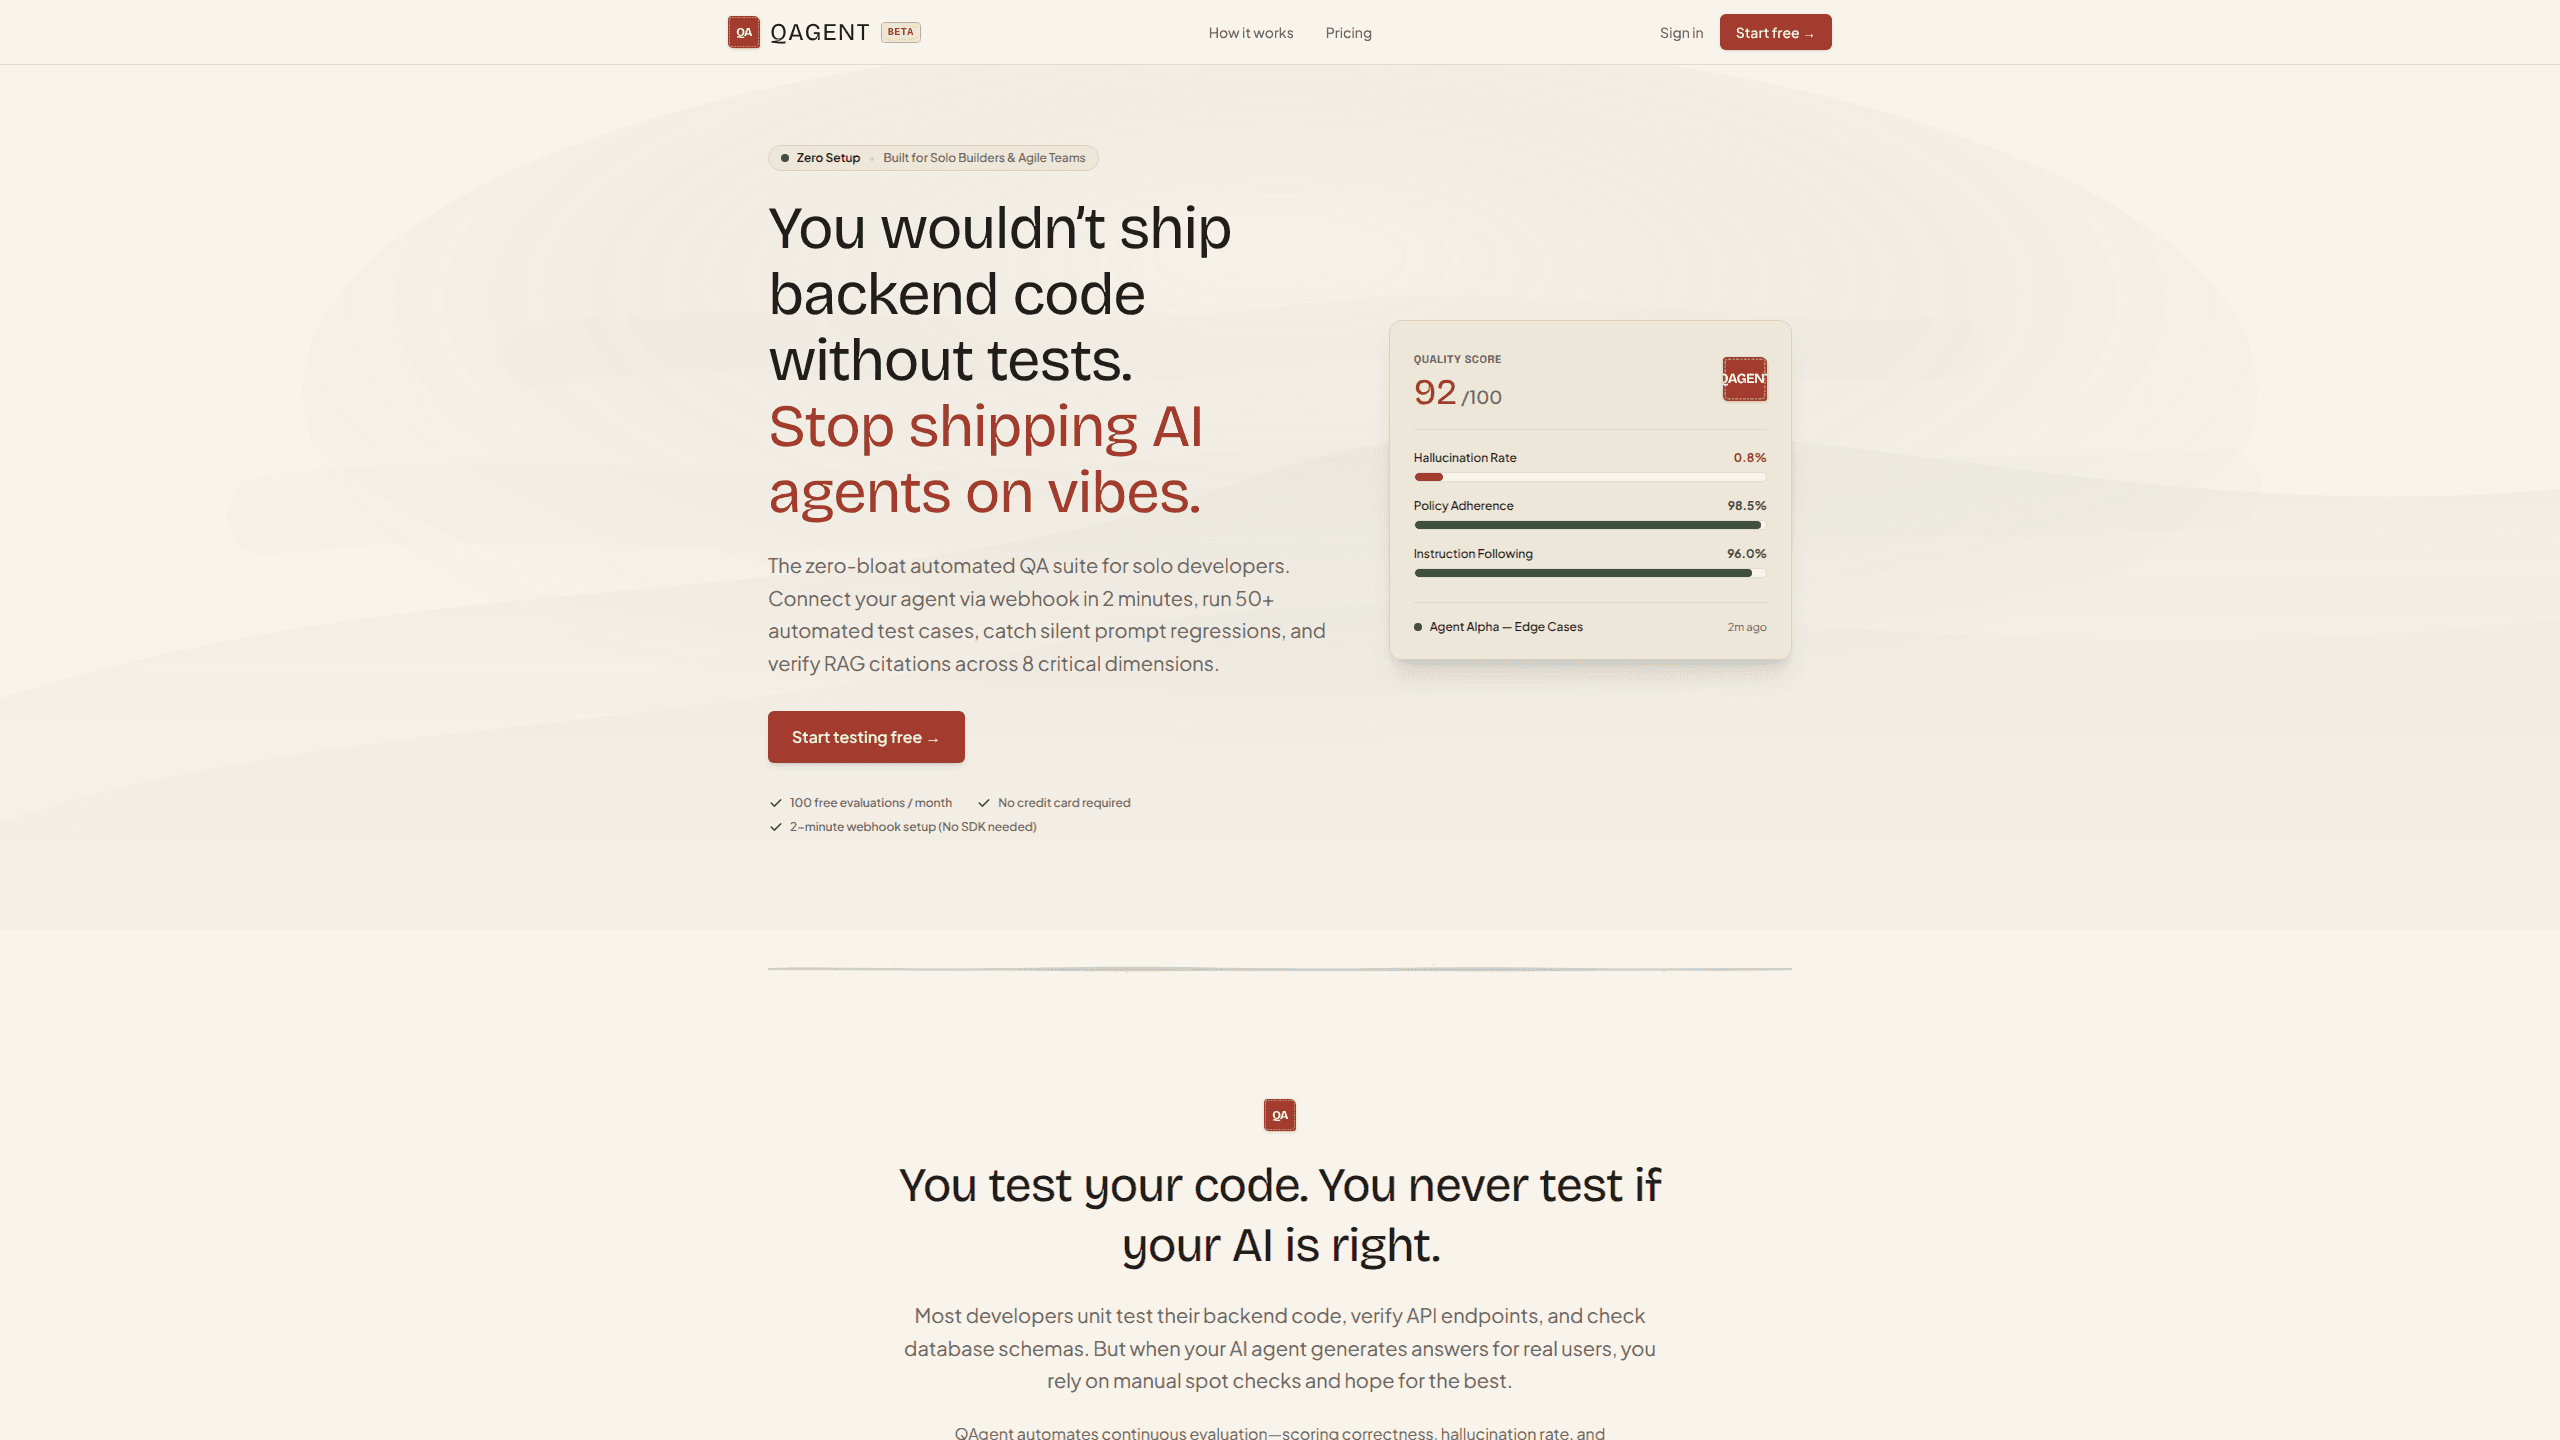
QAgent es una plataforma de aseguramiento de calidad automatizada para agentes de IA. Apuntas a la plataforma hacia el endpoint de tu agente, defines la verdad de referencia que debe seguir y ejecuta baterías de pruebas que puntúan la calidad de las respuestas, la tasa de alucinaciones, el cumplimiento de políticas y la memoria multiturno en cada lanzamiento. Funciona como una herramienta de evaluación de LLM que cualquiera puede ejecutar en minutos. Está pensada para desarrolladores independientes y equipos pequeños que lanzan agentes sin un departamento de QA dedicado.
Acerca de QAgent
Qué es QAgent
QAgent es una plataforma de pruebas basada en web que responde una pregunta que la mayoría de quienes construyen IA se salta: ¿tu agente da respuestas correctas de verdad? En lugar de leer unas cuantas respuestas en un playground y esperar que todo salga bien, conectas tu agente y dejas que QAgent ejecute la misma batería de comprobaciones después de cada cambio de prompt.
El producto apunta a un hueco concreto. Los desarrolladores hacen pruebas unitarias del código del backend y verifican endpoints de API, pero en el momento en que un LLM genera una respuesta para un usuario real, los controles de calidad se convierten en revisiones manuales al azar. Eso es un problema. QAgent trata la salida del agente como algo testeable y la puntúa contra reglas que tú escribiste, no contra lo que suene convincente en ese momento.
La limitación principal es el alcance. QAgent evalúa precisión, seguridad y consistencia. No arregla tus prompts por ti, y su puntuación vale solo lo que valga la verdad de referencia que le das. Escribe reglas reales. Si tu política de reembolsos o tus niveles de precios no están definidos, el juez no tiene con qué comparar.
Primeros pasos
- Crea una cuenta gratuita y conecta tu agente mediante un endpoint de webhook, un flujo de LangChain o un destino HTTP POST simple.
- Define tu verdad de referencia: niveles de precios, plazos de reembolso, temas prohibidos y cualquier documento de conocimiento que el agente deba respetar.
- Escribe rúbricas de prueba que emparejen un prompt con el comportamiento esperado, usando reglas claras de debe y no debe.
- Ejecuta la batería y revisa las calificaciones de aprobado o suspenso, junto con las causas raíz paso a paso de cada fallo.
- Conecta la misma batería a tu flujo de lanzamiento para que las ediciones de prompt se vuelvan a puntuar antes del despliegue.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de QAgent.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores independientes
- Equipos pequeños sin un especialista de QA contratado
- Freelancers y agencias
Tareas
- Detectar alucinaciones
- Seguir regresiones de prompt
- Verificar citas de RAG
- Probar la memoria multiturno
Casos de uso
- Un ajuste de prompt de madrugada para corregir el caso límite de un cliente, seguido de una ejecución de regresión completa en aproximadamente un minuto.
- Entregar un chatbot de IA a un cliente y adjuntar una tarjeta de puntuación que muestre fundamentación factual y cumplimiento de políticas.
- Condicionar el lanzamiento de un despliegue a los resultados de evaluación automatizada en lugar de a la intuición.
- Probar entradas adversarias para confirmar que el agente escala a un humano en lugar de prometer descuentos que no puede dar.
Funciones clave
Ocho dimensiones de evaluación
QAgent puntúa a los agentes con ocho métricas separadas en lugar de una única puntuación vaga. Cubren calidad de respuesta, fundamentación factual, cumplimiento de políticas, corrección de escalado, fidelidad de RAG, relevancia contextual, recuperación de contexto y memoria multiturno, y cada dimensión corresponde a un modo de fallo real en producción. Ese detalle importa. Un número bajo señala un problema concreto, no un estado de ánimo general.
Puntuación determinista con LLM como juez
En lugar de comparar cadenas o patrones regex, QAgent interroga cada respuesta con un modelo juez calibrado. Se ejecuta en LPU de Groq para ganar velocidad, algo que importa cuando quieres una batería de regresión completa en menos de un minuto. Las decisiones de aprobado y suspenso llegan con un nivel de confianza, así sabes cuándo un resultado está cerca del límite y merece una revisión manual antes de fiarte de él.
Sistema de verdad de referencia y rúbricas
Cada prueba combina tres ingredientes: tus reglas oficiales, el prompt de prueba con el comportamiento esperado al estilo RFC 2119 y la respuesta en vivo del agente. El juez comprueba estrictamente contra la rúbrica. Una respuesta educada pero incorrecta igual suspende. Eso es lo que separa a QAgent de una comprobación de vibra en una ventana de chat.
Exenciones inteligentes para falsos positivos
El juez distingue entre una alucinación y el comportamiento normal. Los identificadores de ticket que cambian por sesión, los saldos en vivo y los saludos corteses no se marcan como afirmaciones sin respaldo. Bien. Si el fragmento mejor recuperado contiene la respuesta completa, los resultados de rango inferior no arrastran la puntuación hacia abajo. Las pruebas de jailbreak no penalizan al recuperador por no tener documentos de ataque.
Seguimiento de regresiones de prompt
QAgent registra las diferencias de puntuación en cada iteración de prompt. Ves al instante si un cambio que arregló un caso provocó una caída en otro punto. Ese es justamente el objetivo. Para equipos que editan prompts de sistema a menudo, esto convierte una degradación silenciosa en una línea visible en un gráfico.
Informes de auditoría de calidad
El plan Solo exporta CSV e informes de auditoría de calidad listos para imprimir. Muestran porcentajes de fundamentación, fidelidad de RAG y cumplimiento de políticas, algo útil cuando un cliente quiere pruebas y no una promesa. Envía el archivo. Los informes convierten una ejecución de pruebas en algo que puedes adjuntar a la entrega de un proyecto.
Ventajas y desventajas
Ventajas
- La configuración por webhook tarda unos dos minutos, sin SDK que instalar ni código repetitivo que escribir.
- Ocho dimensiones con nombre dan comentarios concretos en lugar de una sola puntuación mezclada.
- El plan gratuito de 100 evaluaciones al mes facilita probarlo antes de pagar.
- Un rastro de auditoría transparente muestra la consulta, la rúbrica, la respuesta y los hallazgos del evaluador en cada prueba.
- Precio mensual fijo sin compromiso anual ni llamadas de ventas.
Desventajas
- Un solo endpoint de agente conectado en el plan gratuito, así que probar varios agentes exige el plan de pago.
- La puntuación depende por completo de la verdad de referencia que aportes; las reglas vagas producen resultados vagos.
- La plataforma sigue en beta, así que las funciones y los límites pueden cambiar.
Preguntas frecuentes
Prueba si tu agente de IA da respuestas correctas y conformes con las políticas. Eso abarca detección de alucinaciones, seguimiento de instrucciones, fidelidad de RAG, comportamiento de escalado y memoria multiturno, puntuados en ocho dimensiones.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con QAgent.
Alternativas a QAgent

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.