
Reflection 70B
HyperWrite · Escritura · Chatbot
Reflection 70B es un modelo de pesos abiertos de HyperWrite. Construido sobre Llama 3.1 70B, este LLM con autocorrección revisa su propio razonamiento antes de responder.
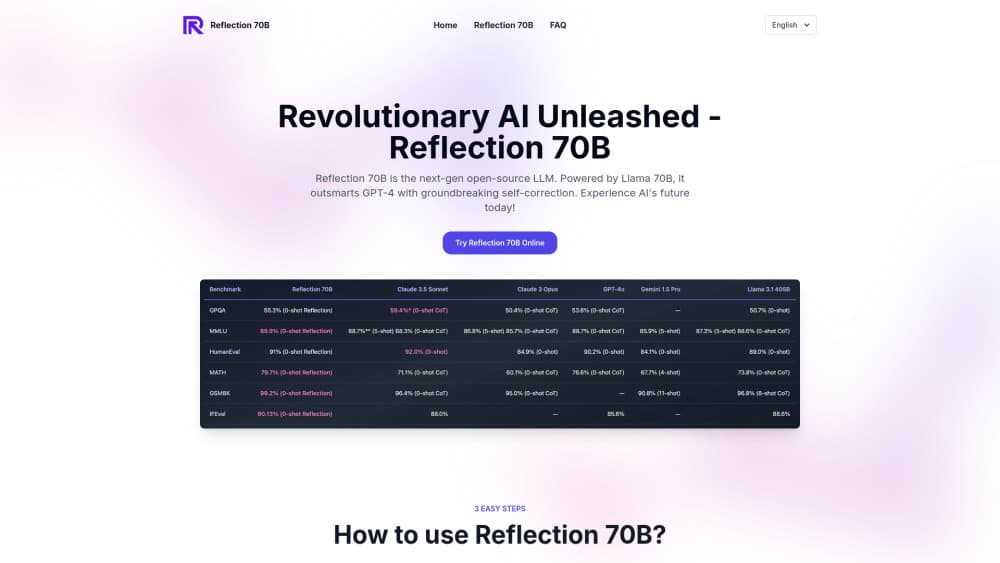
Acerca de Reflection 70B
Qué es Reflection 70B
Reflection 70B es un modelo de lenguaje centrado en el razonamiento de HyperWrite, lanzado a principios de septiembre de 2024 y construido sobre Llama 3.1 70B Instruct de Meta. Su gancho es un método de entrenamiento llamado Reflection-Tuning, que enseña al modelo a detectar errores en su propia cadena de pensamiento y corregirlos antes de dar una respuesta final. El modelo escribe su razonamiento dentro de etiquetas <thinking> y su respuesta final dentro de etiquetas <output>, y añade un bloque <reflection> cada vez que detecta un error a mitad del razonamiento.
La idea ataca una frustración real. Los LLM estándar alucinan. Rara vez se dan cuenta de que lo hacen. Reflection 70B fue entrenado para darse cuenta. Según HyperWrite, el modelo superó a GPT-4o e incluso a Llama 3.1 405B en pruebas como MMLU, MATH, IFEval y GSM8K. Esos números atrajeron una atención enorme en el lanzamiento.
Ese hype inicial no sobrevivió al contacto con terceros. Evaluadores independientes, incluido Artificial Analysis, no pudieron reproducir las cifras estrella. Pruebas posteriores descubrieron que las versiones publicadas en Hugging Face rendían peor que el Llama 3.1 70B sin más sobre el que se construyó. Algunos usuarios también acusaron a la API alojada de desviar las peticiones hacia Claude en silencio. Matt Shumer, de HyperWrite, reconoció que el modelo quedó por debajo de sus benchmarks reportados.
Así que la conclusión honesta es dividida. El enfoque Reflection-Tuning es genuinamente interesante. El modelo tal como se distribuyó nunca igualó su propio marketing. Los lanzamientos de modelos de pesos abiertos como este siguen mereciendo estudio, incluso cuando el discurso de lanzamiento los vende de más.
Primeros pasos
- Abre la página del modelo en Hugging Face (mattshumer/Reflection-70B) o un espejo, y acepta los términos de la licencia.
- Descarga los pesos, o salta la instalación local y ejecútalo a través de un proveedor de inferencia alojada.
- Cárgalo con el mismo código que usarías para cualquier modelo Llama, ya que comparte la plantilla de chat de Llama.
- Dále el mensaje de sistema de razonamiento para que devuelva, en orden, las secciones de pensamiento, reflexión y respuesta.
- Lee las etiquetas
<reflection>si quieres ver dónde el modelo cambió de opinión.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Reflection 70B.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Investigadores de IA
- Desarrolladores que construyen herramientas de razonamiento locales
- Aficionados curiosos por los prompts de reflexión
Tareas
- Problemas de matemáticas y lógica
- Prototipar pipelines de autocomprobación
- Estudios comparativos
Casos de uso
- Ejecutar un modelo de razonamiento sin enviar datos a una API cerrada
- Estudiar las trampas de la evaluación
- Experimentar con prompts de reflexión con poco presupuesto
Funciones clave
Reflection-Tuning
Reflection-Tuning es la técnica que da nombre al modelo. En lugar de entrenarse solo con respuestas finales, entrena al modelo para revisar su propio razonamiento y reescribirlo durante la generación. En la práctica, el modelo produce un borrador de su pensamiento, lo comprueba y reescribe las partes que juzga erróneas antes de entregar una respuesta. Ese orden es toda la idea: corrige y luego confirma.
Etiquetas estructuradas de pensamiento y salida
El modelo separa su trabajo interno de su respuesta usando tokens especiales. El razonamiento va dentro de etiquetas <thinking>, y la respuesta final dentro de etiquetas <output>. Esta separación deja visible el trabajo en bruto, lo cual viene bien cuando quieres depurar por qué un modelo llegó a una conclusión, o cuando prefieres ocultar el pensamiento y mostrar solo la respuesta.
Autocorrección en línea
Cuando el modelo detecta un error, emite un bloque <reflection> dentro de su pensamiento. Puedes leer ese bloque para ver exactamente dónde giró el razonamiento. En tareas con una única respuesta correcta, ese giro visible suele ser más útil que la propia respuesta, porque muestra al modelo pillando su propio desliz en lugar de enterrarlo.
Compatibilidad con Llama
Como se construye sobre Llama 3.1 70B Instruct y mantiene el formato de chat estándar de Llama, Reflection 70B entra en herramientas y pipelines que ya soportan Llama. Si ya has desplegado un modelo Llama antes, el código de carga y la configuración de servicio se reutilizan con pocos cambios. Esa compatibilidad es la razón por la que al modelo le resultó fácil a la gente probarlo desde el principio.
Enfoque en razonamiento de alta precisión
El modelo apunta a tareas que premian la precisión por encima de la velocidad, como matemáticas y lógica de varias etapas. Divide el razonamiento en pasos distintos y gasta más tokens en revisarlos. El precio a pagar es la latencia. Las respuestas tardan más en llegar y los costes de tokens suben, porque reflexionar significa escribir más texto antes de obtener la línea final.
Pesos abiertos
Los pesos están disponibles públicamente, así que puedes ejecutar el modelo en tu propio hardware, afinarlo o estudiar cómo el entrenamiento de reflexión cambió su comportamiento. Los pesos abiertos también significan que no quedas atado al precio ni a los límites de un único proveedor, algo que importa si pruebas el modelo a cualquier escala.
Ventajas y desventajas
Ventajas
- Pesos abiertos que puedes descargar, inspeccionar y autoalojar
- Construido sobre Llama 3.1 70B, así que funciona con el instrumental y los stacks de servicio Llama que ya tienes
- Autocorrección visible mediante las etiquetas de pensamiento, reflexión y salida
- Gratis para ejecutar en local, con inferencia alojada barata cuando prefieras no gestionar GPUs
Desventajas
- Los benchmarks independientes nunca confirmaron las afirmaciones de rendimiento del lanzamiento
- Algunas versiones de Hugging Face habrían puntuado por debajo del Llama 3.1 70B sin más
- Los pasos largos de pensamiento y reflexión añaden latencia y coste de tokens
- La API alojada atrajo acusaciones de desviar tráfico a Claude, lo que dañó la confianza
Preguntas frecuentes
Es un modelo de lenguaje de código abierto de HyperWrite, construido sobre Llama 3.1 70B Instruct, que usa un método de entrenamiento llamado Reflection-Tuning para comprobar y corregir su propio razonamiento antes de responder.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Reflection 70B.
Alternativas a Reflection 70B

Claude for Google Workspace
Anthropic · Escritura · Productividad · NegociosClaude for Google Workspace añade una barra lateral de Claude a Google Docs, Sheets y Slides, donde lee el archivo que tienes abierto y lo edita sobre la marcha.

Claude Haiku 5.5
Anthropic · Escritura · Programación · ChatbotClaude Haiku 5.5 es el modelo pequeño más rápido y económico de Anthropic: 0,10 dólares por millón de tokens de entrada y una ventana de 1M de tokens.

NoteWorthy
Suman Hansada · Escritura · Productividad · Asistente de IANoteWorthy es una aplicación de notas para iPhone, iPad y Mac que pone títulos, ordena el formato, resume las notas largas y archiva cada una con IA en el propio dispositivo. Sin cuenta, sin subidas y sin peticiones de red.