
RLAMA
Dontizi · Programación · Productividad
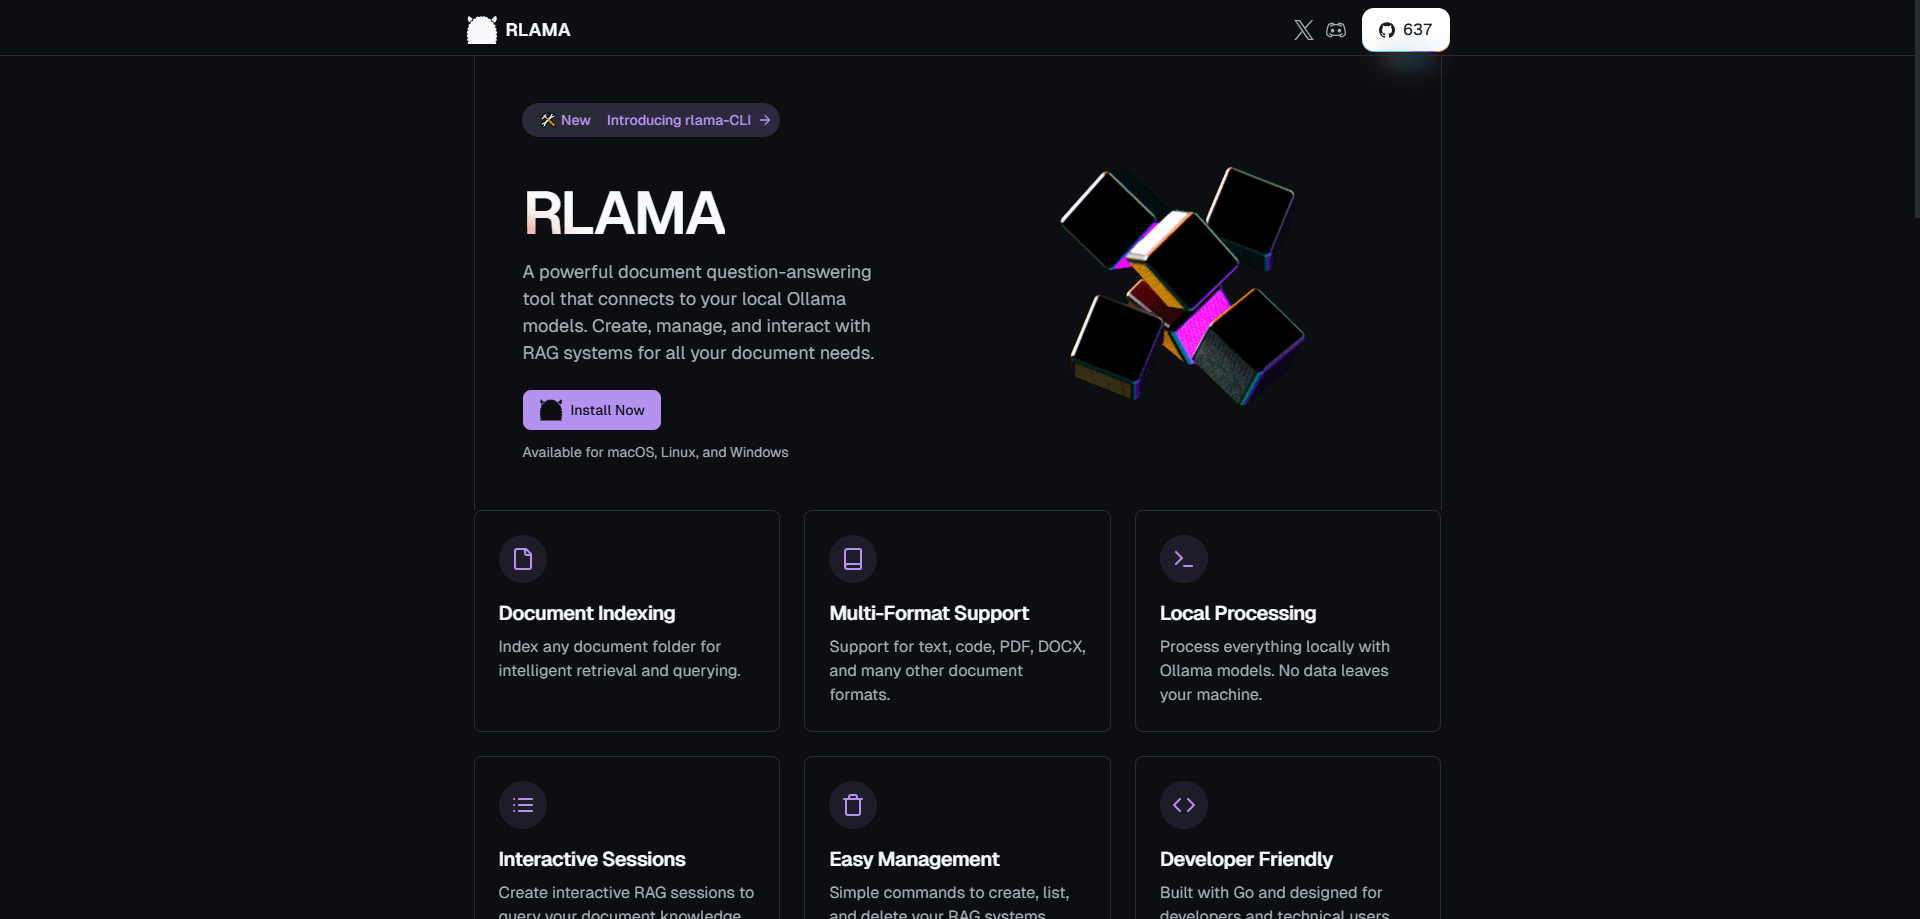
RLAMA es una herramienta de línea de comandos gratis y de código abierto que crea sistemas RAG privados sobre tus documentos, con modelos locales de Ollama para que nada salga de tu equipo.
Acerca de RLAMA
What Is RLAMA
RLAMA es una herramienta de preguntas y respuestas para tus propios documentos, pensada para funcionar entera en tu ordenador. Es una herramienta RAG local de línea de comandos que se apoya en Ollama, la aplicación que ejecuta modelos de lenguaje sin conexión, y convierte una carpeta de archivos en una base de conocimiento consultable. El desarrollador la publica bajo licencia Apache 2.0, así que el código es abierto y se puede usar gratis.
La idea es simple. Señalas una carpeta, RLAMA lee los archivos, los parte en fragmentos y guarda en tu disco los vectores de cada fragmento. Cuando haces una pregunta, la herramienta localiza los pasajes que encajan, se los pasa a tu modelo local y el modelo responde usando tu material como contexto. Ese método se llama generación aumentada por recuperación (RAG), y es lo que mantiene las respuestas atadas a fuentes reales en vez de dejar que el modelo improvise de memoria.
El problema está en la puesta en marcha. RLAMA es una CLI, no una app de un clic, así que trabajas en una terminal y necesitas Ollama instalado y en marcha antes de que nada funcione. Tampoco hay versión alojada, que es justo lo que se busca en una herramienta RAG autoalojada. Los resultados dependen del modelo que elijas y de la calidad de tus documentos, y un equipo flojo o un modelo pequeño se notan en las respuestas. Además, el proyecto está en pausa, así que ahora mismo no llegan funciones nuevas.
Getting Started
- Instala Ollama desde ollama.ai y descarga al menos un modelo, por ejemplo ollama pull llama3.
- Instala RLAMA con el script de una línea: curl -fsSL https://raw.githubusercontent.com/dontizi/rlama/main/install.sh | sh.
- Crea un sistema RAG apuntando a una carpeta: rlama rag llama3 mis-docs ./docs.
- Abre una sesión interactiva y pregunta: rlama run mis-docs.
- Añade archivos después con rlama add-docs, o activa la vigilancia de carpeta para que entren solos en el índice.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de RLAMA.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que quieren búsqueda local de documentos
- Equipos que cuidan la privacidad
- Quien ya usa Ollama
- Cualquiera que quiera entender cómo funciona RAG
Tareas
- Preguntar sobre una carpeta de documentación
- Consultar un repositorio de código
- Crear una base desde una web
- Mantener la base al día
- Integrar RAG en otra herramienta
Casos de uso
- Un autónomo con contratos de clientes que no puede subir a ningún sitio
- Un desarrollador que busca en un repositorio grande
- Un investigador con una pila de PDF
- Un aficionado que prueba modelos pequeños
Funciones clave
Pipeline RAG local
Usa el comando rag para indexar una carpeta, run para consultarla y los archivos locales en ~/.rlama para guardarlo todo. Los documentos se leen, se trocean, se convierten en embeddings con Ollama y se almacenan en disco. Nada toca un servidor externo, que es justo la gracia de la herramienta.
Varias estrategias de troceado
RLAMA parte los documentos de cuatro formas: tamaño fijo, semántica, jerárquica e híbrida. El modo híbrido elige el mejor método según el tipo de archivo y trata el Markdown por encabezados, el código por funciones y clases, y el texto plano por párrafos. Mejores fragmentos significan mejor recuperación, y aquí es donde muchas herramientas RAG se quedan en lo básico.
Rastreo y seguimiento de webs
El comando crawl-rag crea un RAG desde una web en vez de una carpeta, con controles de profundidad, concurrencia y rutas excluidas. Web-watch vigila ese sitio e incorpora páginas nuevas al índice, así que una web de documentación se mantiene al día sin reindexar a mano.
Vigilancia de carpetas
Puedes apuntar un RAG a una carpeta y hacer que RLAMA la revise cada cierto tiempo, o solo cuando se usa el RAG. Los archivos nuevos se indexan solos, lo que quita el paso de acordarse de lanzar add-docs tras cada cambio.
Servidor API integrado
El comando api arranca un servidor HTTP, y un único endpoint POST /rag acepta el nombre del RAG, un prompt y un tamaño de contexto opcional. Así puedes conectar preguntas y respuestas sobre documentos locales a un script, una app pequeña o una herramienta que no habla CLI.
Modelos de Ollama y Hugging Face
RLAMA se apoya en Ollama tanto para los embeddings como para la generación, y acepta cualquier modelo que Ollama pueda ejecutar. Los comandos hf-browse y run-hf llegan al catálogo GGUF de Hugging Face para que busques y pruebes un modelo antes de montarlo en un sistema RAG.
Ventajas y desventajas
Ventajas
- Funciona totalmente sin conexión, así que los documentos no salen de tu equipo y no hay coste por consulta.
- Gratis y de código abierto bajo Apache 2.0, con un único binario en Go que se instala en una línea.
- Cuatro estrategias de troceado y un rastreador web van más allá de la mayoría de las soluciones RAG locales.
- El servidor API integrado convierte la CLI en algo que otras herramientas pueden llamar.
- Va en Linux, macOS y Windows sin depender de la nube.
Desventajas
- Es solo una CLI, así que quien espere una app de escritorio tendrá que trabajar desde una terminal.
- La instalación exige Ollama en marcha y modelos descargados antes de empezar, y ese paso frena a los novatos.
- La calidad de las respuestas depende del modelo elegido, así que un modelo pequeño en hardware flojo da resultados pobres.
- El desarrollo está en pausa, lo que significa que ahora no hay funciones nuevas y los arreglos van más lentos.
Preguntas frecuentes
RLAMA crea un sistema privado de preguntas y respuestas sobre tus propios archivos. Indexas una carpeta o una web, luego preguntas y recibes respuestas sacadas de ese material, todo con modelos locales de Ollama.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con RLAMA.
Alternativas a RLAMA
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.