

Salad - GPU Cloud
Salad Technologies · Programación
Salad es una nube de GPU distribuida que ejecuta contenedores de IA y modelos de pesos abiertos en unos 16.000 GPUs activas diarias repartidas por más de 190 países, desde unos 0,015 dólares por hora de GPU.
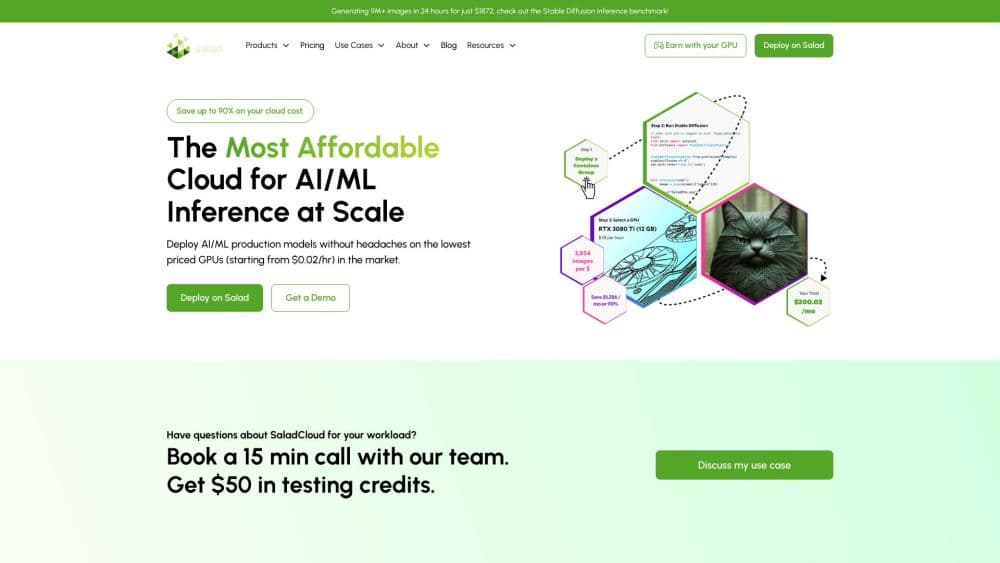
Acerca de Salad - GPU Cloud
What Is Salad
Salad es una nube de GPU montada sobre hardware que la empresa no posee. En lugar de llenar centros de datos con racks idénticos, reúne GPUs de consumo y de estación de trabajo que quedan libres en PC para juegos y pequeñas oficinas de todo el mundo, y alquila esa capacidad a desarrolladores y empresas que ejecutan cargas de IA. El resultado es una bolsa de cómputo que cuesta mucho menos que las nubes tradicionales. También se comporta de forma distinta en varios puntos clave.
Como plataforma de inferencia de IA, cubre tres frentes. Puedes hacer despliegue de contenedores en GPU sobre una red distribuida de GPUs de la gama RTX, llamar a modelos de pesos abiertos desde un endpoint de tokens compatible con OpenAI, o transcribir y sintetizar audio con APIs dedicadas. La misma capa de orquestación funciona en Community Cloud, en hardware reservado de Dedicated y en Private Cloud dentro de tus propias máquinas.
El principal compromiso es la previsibilidad. Como los nodos pertenecen a particulares, las instancias se pueden reubicar o desconectar cuando un equipo se apaga. Salad lo maneja con niveles de prioridad y reubicación automática, pero encaja en cargas que toleran interrupciones, no en clústeres rígidos de disponibilidad permanente.
Getting Started
- Crea una cuenta de SaladCloud y verifica tus datos.
- Genera una clave de API desde el portal, o una clave del AI Gateway si solo necesitas tokens de modelos.
- Empaqueta tu carga como contenedor Docker, o elige un modelo de pesos abiertos del catálogo del Gateway.
- Despliega desde el portal o con una sola llamada a la API. Define un nivel de prioridad y un número de réplicas.
- Consulta los registros y revisa los resultados. La facturación corre solo mientras la instancia está en ejecución.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Salad - GPU Cloud.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Startups de IA con presupuesto ajustado
- Desarrolladores individuales y creadores independientes
- Ingenieros de ML que prototipan canalizaciones de inferencia
Tareas
- Generación de imágenes y vídeo por lotes
- Transcripción de audio y texto a voz
- Servicio de LLM de pesos abiertos
Casos de uso
- Escalar una demo a producción sin reservar capacidad de centro de datos
- Estirar una beca de investigación
- Mantener inferencia sensible en tu propio hardware
Funciones clave
Red distribuida de GPU
Salad agenda contenedores en unas 16.000 GPUs activas diarias, tomadas de PC para juegos y estaciones de trabajo en más de 190 países. El hardware ya existe, así que la plataforma coordina suministro en vez de financiar nuevos centros de datos. Eso es lo que mantiene bajos los precios.
Salad Container Engine
Esta capa de orquestación despliega contenedores en GPU sobre nodos que nunca antes vio. Verifica cada máquina, la aísla tras un hipervisor y reubica el trabajo en cuanto un nodo desaparece. Envías una imagen Docker con unos pocos ajustes de recursos, sin afinar servidores a mano.
AI Gateway
El Gateway es una API compatible con OpenAI para modelos de pesos abiertos como Qwen 3.6 y Qwen 3.5. Las variantes mayores llevan una ventana de contexto de 262.144 tokens. Apunta cualquier SDK de OpenAI a una URL base nueva y tus agentes, asistentes de código o apps empiezan a pagar por token o una cuota mensual fija.
Niveles de prioridad y facturación por segundo
Cuatro niveles de prioridad te dejan cambiar fiabilidad por coste. La prioridad alta nunca sufre preempción; el nivel más bajo es el más barato y el más interrumpible. La facturación se detiene en cuanto una instancia para, y la asignación, la descarga de imágenes y el arranque en frío son gratis.
APIs especializadas por modalidad
Salad publica endpoints ajustados para tareas concretas. Su API de transcripción alcanzó un 95,1% de precisión en CommonVoice, y su servicio de texto a voz se cita en hasta 6 millones de palabras por dólar. Cada cifra enlaza a una metodología declarada, no a una promesa de marketing.
Despliegues privados y dedicados
Más allá de la bolsa compartida, los servidores Dedicated reservados corren por contrato con tarjetas RTX PRO 6000 Blackwell, y Private Cloud licencia la misma pila de orquestación para hardware que ya tienes. En Private Cloud, los datos de la empresa se quedan en los equipos de la empresa.
Ventajas y desventajas
Ventajas
- Alquiler de GPU barato: el precio por hora de GPU arranca en unos 0,015 dólares por nodo RTX 4090 en la nube distribuida, una fracción de lo que cobran las nubes al uso por trabajo comparable.
- La facturación por segundo, sin contratos ni mínimos, abarata los experimentos pequeños.
- El motor de contenedores y el AI Gateway reutilizan herramientas estándar de Docker y OpenAI, lo que reduce el trabajo de migración.
- Los endpoints especializados de transcripción y texto a voz cubren tareas de audio habituales sin montar nada.
- Las opciones Private Cloud y Dedicated mantienen las cargas sensibles en hardware que controlas.
Desventajas
- Las instancias pueden sufrir preempción o desconectarse cuando los dueños de los nodos se van, así que los servicios permanentes necesitan lógica de reintento.
- Los nodos son GPUs de consumo en casas y oficinas pequeñas, lo que descarta el entrenamiento multi-GPU fuertemente acoplado que sí permiten los centros de datos.
- No hay prueba gratuita, así que pagas desde la primera prueba. El coste de entrada es bajo, pero nada es gratis.
- El AI Gateway sigue en acceso anticipado y su catálogo de modelos es más estrecho que el de los proveedores de tokens dedicados.
Preguntas frecuentes
No. Solo se te cobra por los segundos que una instancia pasa en ejecución. La asignación, la descarga de imágenes y el arranque del contenedor son gratis.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Salad - GPU Cloud.
Alternativas a Salad - GPU Cloud

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.