
Scrapeless
Scrapeless · Programación
Scrapeless es una plataforma en la nube para scraping web y automatización de navegador. Es una API de scraping web que junta un navegador antidetectección, API de desbloqueo, proxies residenciales y scrapers estructurados en un solo kit pensado para agentes de IA y equipos de datos.
Acerca de Scrapeless
What Is Scrapeless
Scrapeless es una plataforma gestionada de datos web. En lugar de mantener tus propios navegadores headless, pools de proxies y solucionadores de CAPTCHA, le mandas una URL o abres una sesión de navegador en la nube desde una sola API. El servicio se encarga de la detección de bots, la rotación de IP, el renderizado de JavaScript y los retos de CAPTCHA por detrás.
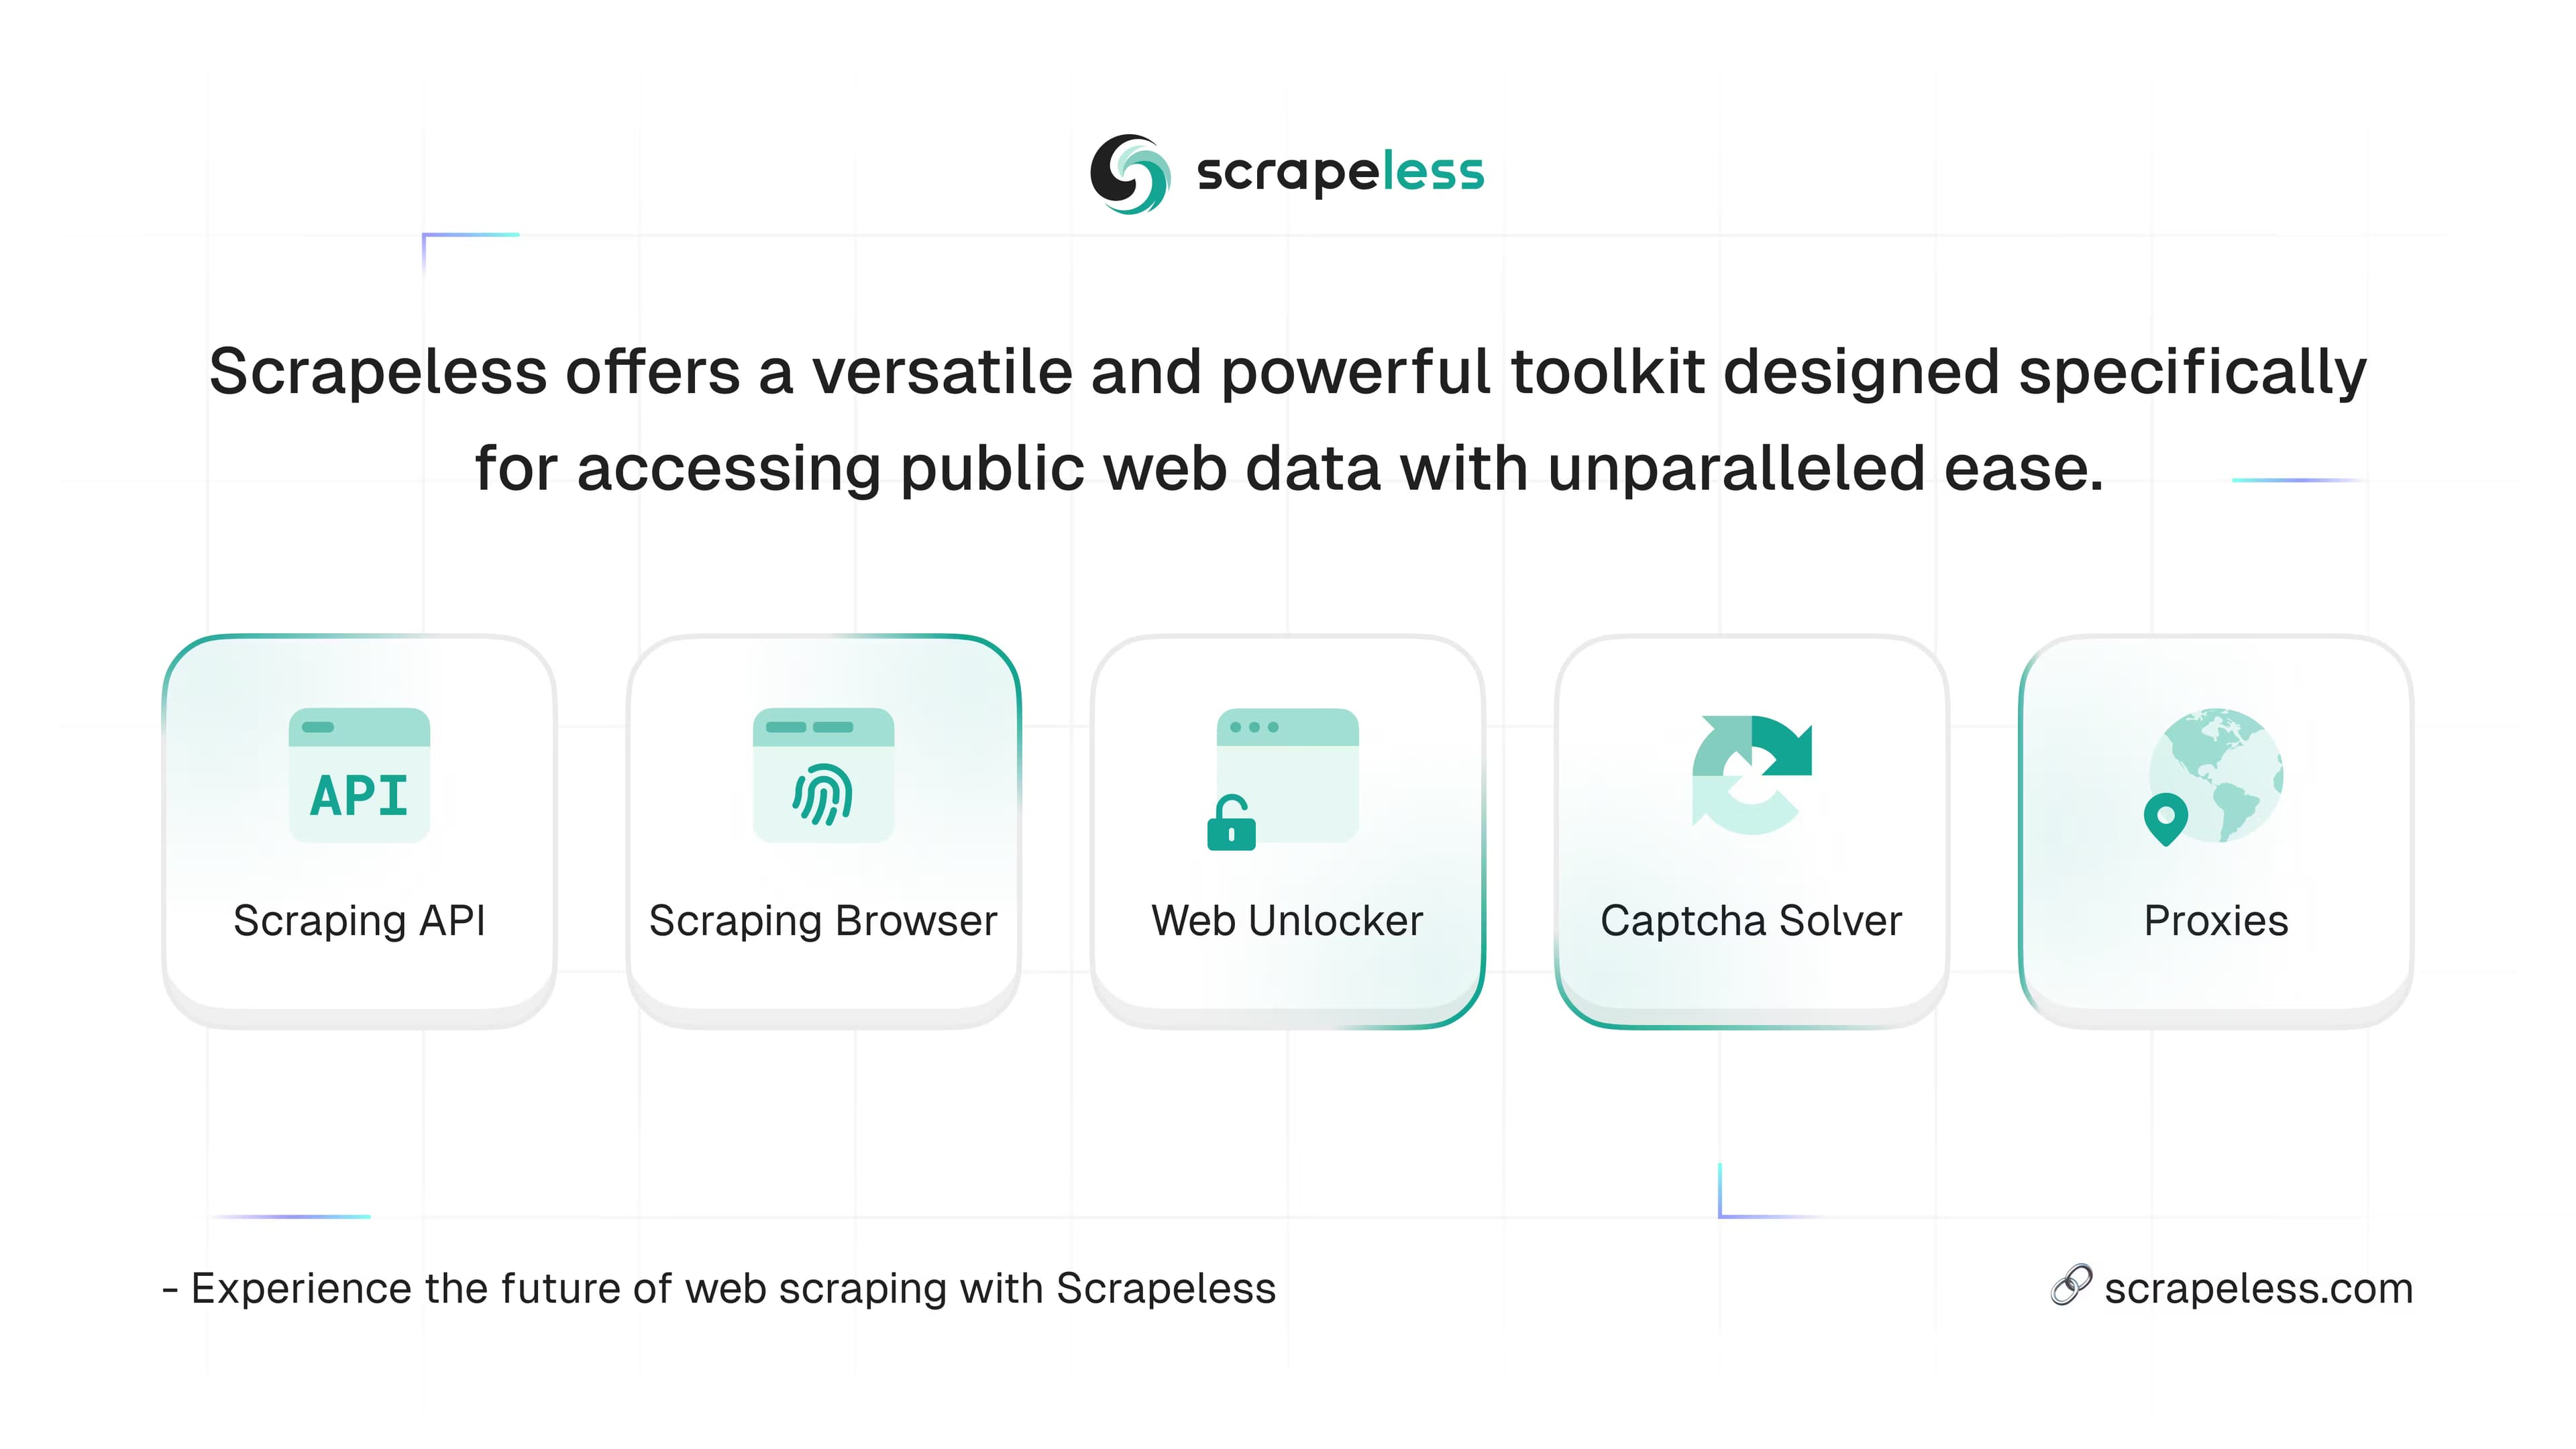
La línea de productos cubre varios frentes. Agent Browser le da a los agentes de IA un navegador real en la nube para navegar, hacer clic y rellenar formularios. Web Unlocker saca contenido de páginas protegidas por Cloudflare, DataDome o AWS WAF. AI Scraper recopila respuestas y citas de motores como ChatGPT, Perplexity y Gemini. Hay scrapers dedicados para Google Search, Amazon y TikTok. Crawl convierte sitios enteros en Markdown o HTML para pipelines RAG, y Proxies te da IP geolocalizadas para tu propia infraestructura.
La pega principal está en el alcance. Scrapeless está pensado para desarrolladores y equipos de datos, así que necesitas algo de código o una integración como n8n o Make para sacarle partido. El precio va por uso, lo que abarata los trabajos pequeños, aunque una gran recolección puede subir de precio.
Getting Started
- Regístrate en el panel de Scrapeless. Las cuentas nuevas reciben 5 dólares de crédito gratis, sin tarjeta de crédito.
- Copia tu clave de API desde el panel y no la compartas.
- Elige el producto que encaje con tu tarea, como Agent Browser, Web Unlocker o la Scraping API.
- Envía una petición de prueba por la API REST, un SDK en Python, Node o Go, o el servidor MCP.
- Revisa el HTML, JSON o Markdown que devuelve y conéctalo a tu pipeline.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Scrapeless.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de datos
- Creadores de agentes de IA
- Equipos de SEO y crecimiento
- Analistas de comercio electrónico
Tareas
- Raspar sitios cargados de JavaScript
- Sortear defensas antibot
- Montar corpus para RAG
- Vigilar la visibilidad de marca en IA
Casos de uso
- Ejecutar flujos largos de agentes
- Recolección de gran volumen
- Investigación puntual
Funciones clave
Agent Browser con sigilo a nivel de motor
Agent Browser es un navegador en la nube que expone un endpoint CDP por WebSocket, así que tu código actual de Puppeteer y Playwright funciona cambiando una línea. La antidetectección vive dentro de un motor de navegador propio, no como plugin. Eso cubre huellas TLS y JA3, ruido en Canvas y WebGL, aleatorización del contexto de audio y bloqueo de fugas de IP por WebRTC.
Resolución de CAPTCHA integrada
Los retos de reCAPTCHA, Cloudflare Turnstile y AWS WAF se resuelven solos dentro de la sesión. Scrapeless dice que su solucionador supera los tipos comunes de CAPTCHA con una tasa del 98% o más, en menos de dos segundos de media. Viene gratis, sin un solucionador de pago aparte.
API Web Unlocker
Web Unlocker recibe una URL y devuelve HTML limpio, JSON, Markdown o una captura de pantalla, con lo que obtienes extracción de datos estructurados sin montar nada de parseo. Detecta el sistema antibot que haya delante, rota IP, renderiza JavaScript y reintenta por su cuenta. El cobro es solo por petición exitosa, así que los intentos fallidos no te cuestan nada.
Red de proxies residenciales
Cada producto se apoya en una red de proxies residenciales que cubre 195 países, con segmentación por estado y ciudad y sesiones fijas para rastreos con estado. Scrapeless lista cuatro tipos de proxy: residencial, ISP estático, centro de datos e IPv6.
Sesiones persistentes y Live View
Los perfiles guardados en la nube mantienen la sesión iniciada entre ejecuciones y evitan repetir autenticaciones en trabajos largos. Live View transmite el DOM de la sesión en menos de 100 milisegundos, y Session Replay reproduce los fotogramas junto a los registros de red y consola, así ves qué encontró un agente cuando falló.
Servidor MCP y SDK en varios lenguajes
Un servidor MCP nativo expone las acciones de navegador, el scraping y la búsqueda como herramientas que pueden llamar clientes como Claude Code, Cursor y Cline. Para una integración más profunda, hay SDK oficiales de Python, Node con TypeScript y Go, con conectores propios para n8n, Make, LangChain y Dify.
Ventajas y desventajas
Ventajas
- Una sola plataforma cubre navegación en la nube, desbloqueo, proxies, rastreo y scrapers estructurados, así evitas juntar varios proveedores.
- Precio por uso con 5 dólares de crédito gratis y sin tarjeta para empezar.
- Resolución de CAPTCHA y proxies residenciales vienen incluidos, no como complementos de pago aparte.
- Tu código actual de Puppeteer y Playwright conecta por un endpoint CDP estándar.
Desventajas
- Es una herramienta para desarrolladores. Quien no programe necesita una integración como n8n o Make para hacer algo útil.
- El coste por uso puede crecer rápido en rastreos enormes, así que conviene vigilar el consumo de crédito.
- Algunas cifras de éxito y velocidad las da la propia Scrapeless y no están verificadas por terceros.
- La gama de productos es amplia y a los recién llegados puede costarles elegir por dónde empezar.
Preguntas frecuentes
Scrapeless recopila datos web públicos y ejecuta automatización de navegador en la nube. Los equipos lo usan para raspar sitios protegidos, alimentar pipelines RAG, vigilar resultados de búsqueda con IA y dar a los agentes de IA un navegador real con el que trabajar.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Scrapeless.
Alternativas a Scrapeless

Base Code
Base44 (Wix) · Programación · ProductividadBase Code es un entorno de desarrollo en la nube compartido de Base44. El equipo describe cambios sobre un repositorio de GitHub en el chat, los ve en una vista previa y los envía como pull requests.

Google EmbeddingGemma 2
Google DeepMind · Escritura · Imagen · ProgramaciónGoogle EmbeddingGemma 2 es un modelo abierto de 740 millones de parámetros que convierte texto, código, imágenes, audio y fotogramas de vídeo en vectores de un mismo espacio de 768 dimensiones, y funciona en móviles y portátiles.

GitGlow
GitGlow · Programación · ProductividadGitGlow es un cliente Git de escritorio que reúne tu código y los cambios de tus agentes de IA en una sola revisión, para que sepas qué va a salir de tu máquina antes de publicarlo.