
Seemore Data
Seemore Data · Programación
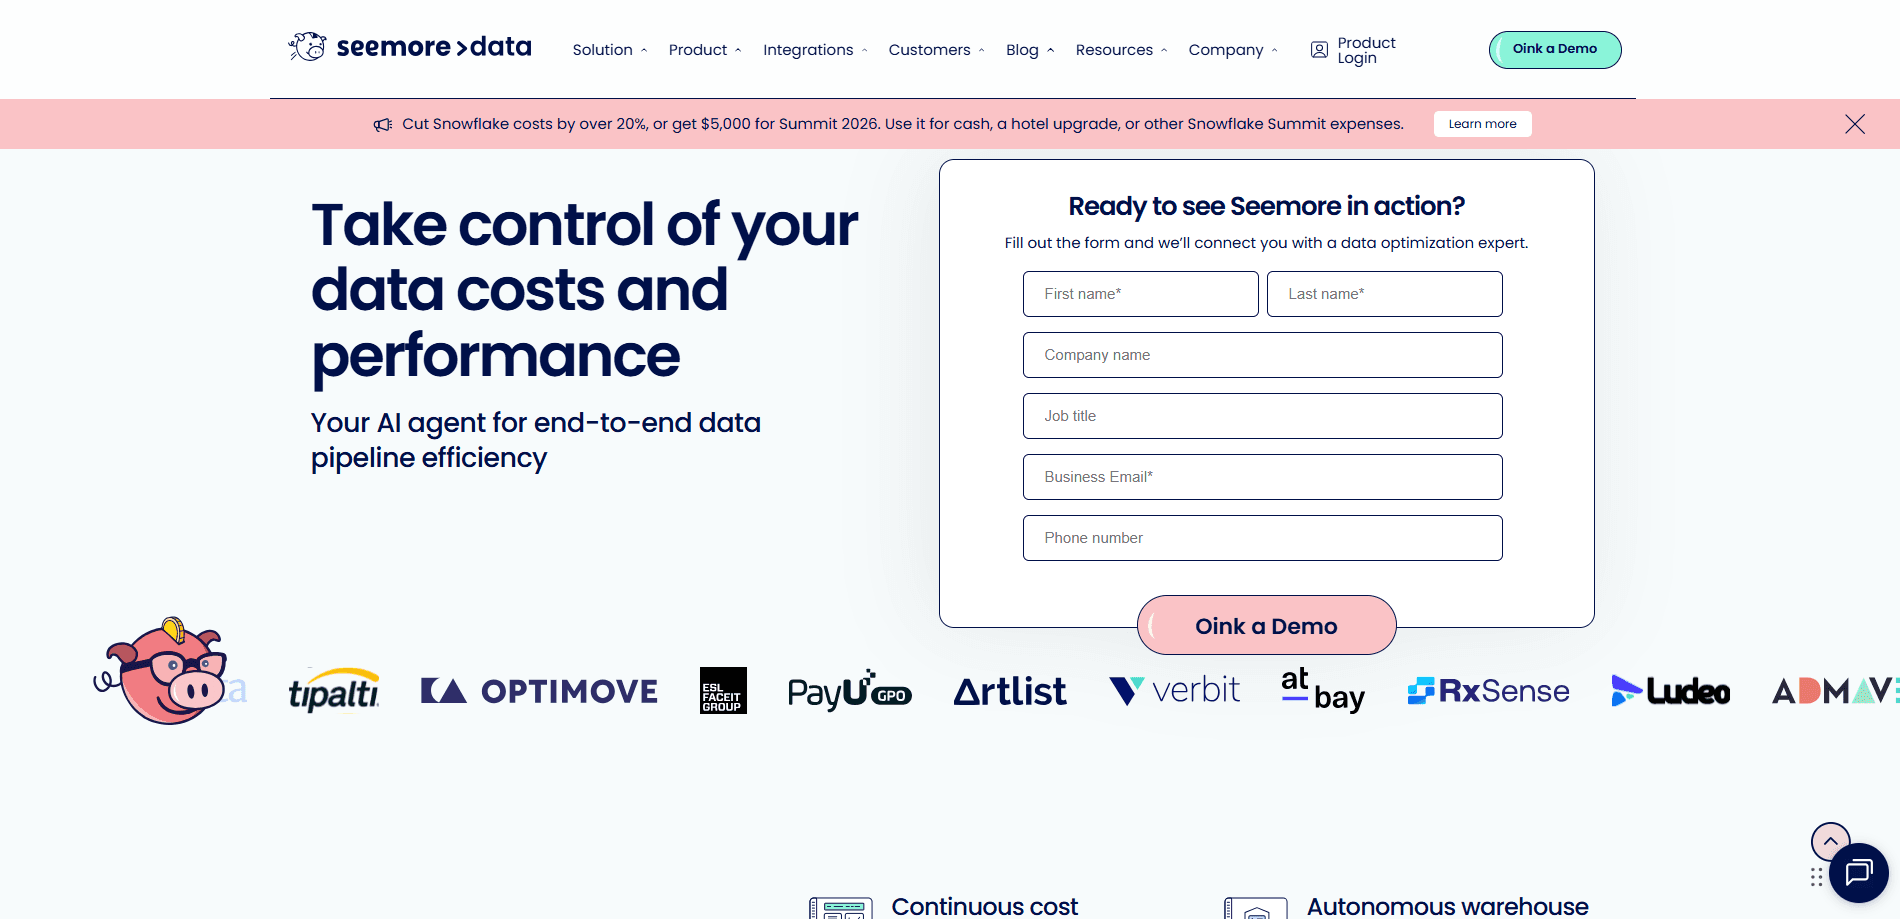
Seemore Data es una plataforma de gestión de costos de datos en la nube impulsada por IA, pensada para equipos que ejecutan cargas pesadas en Snowflake y stacks de datos parecidos. Vigila tus almacenes y pipelines sin descanso, detecta dónde se quema el dinero y recomienda o aplica correcciones. La propuesta es simple. Ves a dónde va cada dólar de gasto en datos. Tienes herramientas para bajar esa cifra sin frenar tus consultas. Funciona junto a lo que ya usas, más cerca de una capa de monitoreo que de una plataforma de datos completa.
Acerca de Seemore Data
Qué es Seemore Data
Seemore Data es una capa de monitoreo y optimización para almacenes de datos en la nube, con Snowflake como centro de gravedad evidente. Lee tu historial de consultas, el uso de los almacenes y la actividad de los pipelines, y convierte esa telemetría en respuestas claras sobre costo, rendimiento y desperdicio.
El problema que ataca le resulta familiar a cualquiera que haya abierto una factura de datos en la nube. El precio de Snowflake es flexible, así que decisiones pequeñas de configuración se convierten en cargos mensuales grandes. Un almacén sobredimensionado que sigue encendido el fin de semana. Un patrón de consultas que nadie notó. Un pipeline que arrastra más datos de los que necesita. Seemore Data existe para atrapar esos casos de forma automática.
La empresa la fundó en 2023 un equipo de ingenieros y operadores. Es un producto joven, y eso se nota para bien y para mal. El conjunto de funciones es agresivo. La automatización es real. Pero apunta a equipos que ya invirtieron en Snowflake. Si tus datos viven en otro sitio, aquí hay menos para ti por ahora.
Primeros pasos
- Reserva una demo en el sitio y conecta la plataforma a tu cuenta de Snowflake con acceso de lectura al uso y al historial de consultas.
- Deja que Seemore mapee tus almacenes, pipelines y activos de datos durante el escaneo inicial. Suele requerir una sesión corta de incorporación con su equipo.
- Revisa el panel de costos para ver el gasto por almacén, usuario y consulta, y mira las alertas de anomalías por si algo ya está quemando créditos.
- Activa la automatización con la que te sientas cómodo, empezando por recomendaciones y pasando a la suspensión automática o al ajuste de tamaño cuando confíes en la salida.
- Sigue el ahorro en los primeros ciclos de facturación y ajusta las reglas de presupuesto y las alertas según cambien tus cargas.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Seemore Data.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de datos
- Líderes de datos y BI
- Equipos de plataforma y FinOps
Tareas
- Recortar la factura de Snowflake
- Investigar la causa raíz
- Detección de anomalías
- Gobernanza de pipelines
Casos de uso
- Fin de mes, cuando llega la factura de datos y nadie sabe explicar el salto.
- Un analista nuevo entra y lanza consultas caras sin darse cuenta.
- Migrar cargas y necesitar saber cuáles importan de verdad antes de comprometer un tamaño.
- Escalar una malla de datos donde varios equipos comparten una cuenta de Snowflake y la atribución de costos se vuelve política.
Funciones clave
Control continuo de costos
Seemore sigue el gasto en datos en tiempo real. Sin sorpresa en la factura mensual. Desglosa los costos por almacén, usuario, consulta y producto de datos, así ves qué cambio provocó un pico en lugar de mirar cómo sube el total. Las reglas con IA aplican límites de presupuesto y marcan el desperdicio de forma automática. Eso recorta el trabajo manual con hojas de cálculo que suele seguir a una revisión de costos.
Optimización autónoma de almacenes
Es la función por la que viene la mayoría de los equipos. Seemore ajusta el cómputo de forma continua, ajusta cuándo se suspenden los almacenes y evita el sobredimensionamiento que infla la factura de Snowflake. Smart Pulse se encarga del ajuste cada hora. Eso supera a una persona revisando paneles una vez al día. El resultado son almacenes disponibles cuando hacen falta y apagados cuando no.
Optimización de pipelines de datos según el uso
La optimización de pipelines de datos según el uso empareja los recursos del pipeline con la demanda real y reduce lo que está infrautilizado, algo que importa porque los pipelines que arrastran más datos de los que una tarea requiere desperdician dinero real. En equipos que corren trabajos ETL y ELT con una programación, esto atrapa los trabajos que crecieron en silencio durante meses y nunca se revisaron.
Linaje profundo de extremo a extremo
El linaje a nivel de columna rastrea los datos desde su origen por cada transformación hasta el panel final, y es la función que más tiempo ahorra en una mala semana. Importa sobre todo al depurar: cuando una cifra parece mal o una consulta se arrastra, ves exactamente qué cambio aguas arriba es el responsable en vez de adivinar. También es lo que hace confiable la atribución de costos, ya que puedes atar una cifra en dólares a un producto de datos concreto.
Agente de IA proactivo
El agente de IA para eficiencia en tiempo real detecta anomalías, indaga en las causas raíz y saca recomendaciones antes de que las ineficiencias golpeen el rendimiento. En vez de soltar otro panel sobre tu equipo, el agente de datos con IA intenta responder la pregunta detrás de la alerta. La detección de anomalías y el análisis de causa raíz corren sobre los mismos datos que usa el resto de la plataforma, así las alertas conectan con el linaje y el contexto de costos. Es realmente útil.
Auto-clustering y auto-suspensión de Snowflake
Seemore ataca dos de las trampas de costo más comunes de Snowflake. El análisis de auto-clustering sigue el ritmo de los patrones de consulta cambiantes y del crecimiento de tablas, algo que el ajuste manual no iguala a escala. El apagado automático de almacenes reduce el tiempo de ejecución innecesario, y los clientes suelen citarlo como una de las victorias más rápidas tras la incorporación.
Mapeo del impacto en el negocio
Las cifras de costo solo convencen cuando conectan con resultados. Seemore mapea costo, rendimiento y uso a los KPI de negocio, lo que ayuda a los equipos de datos a mostrar cómo su trabajo sostiene los ingresos o la eficiencia en lugar de presentar una factura abstracta. La visibilidad de costos de datos deja de ser queja de finanzas. Se convierte en conversación de negocio. Para líderes que explican el gasto en datos a ejecutivos, esta es la parte que hace funcionar la conversación.
Ventajas y desventajas
Ventajas
- La visibilidad de costos en tiempo real reemplaza las conjeturas que siguen a una factura sorpresa de la nube.
- La optimización autónoma sigue trabajando entre revisiones manuales, así el ahorro se acumula sin atención constante.
- El linaje a nivel de columna acelera la depuración y hace defendible la atribución de costos.
- Los clientes reportan incorporación rápida y un equipo de producto receptivo, con varias funciones lanzadas directo desde los comentarios de usuarios.
- Varios casos de estudio citan reducciones de alrededor del 50% en el tiempo de ejecución de procesos clave y ahorros de costo significativos.
Desventajas
- No se publica el precio, así que tienes que hablar con ventas antes de presupuestarlo.
- La plataforma se apoya mucho en Snowflake. Los equipos en otros almacenes obtienen bastante menos valor hoy.
- La disponibilidad de API pública no está documentada, lo que complica integrar Seemore en un stack de automatización existente.
- Es una empresa joven fundada en 2023, así que los compradores deberían pesar la madurez del producto y el riesgo de soporte a largo plazo.
Preguntas frecuentes
Monitorea tu almacén de datos en la nube y tus pipelines, te muestra dónde se gasta el dinero y automatiza correcciones como ajustar el tamaño de los almacenes y apagar el cómputo inactivo. Piénsalo como una capa de control de costo y rendimiento que se sienta encima de Snowflake.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Seemore Data.
Alternativas a Seemore Data
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.