
SemanticGuard
SemanticGuard · Programación
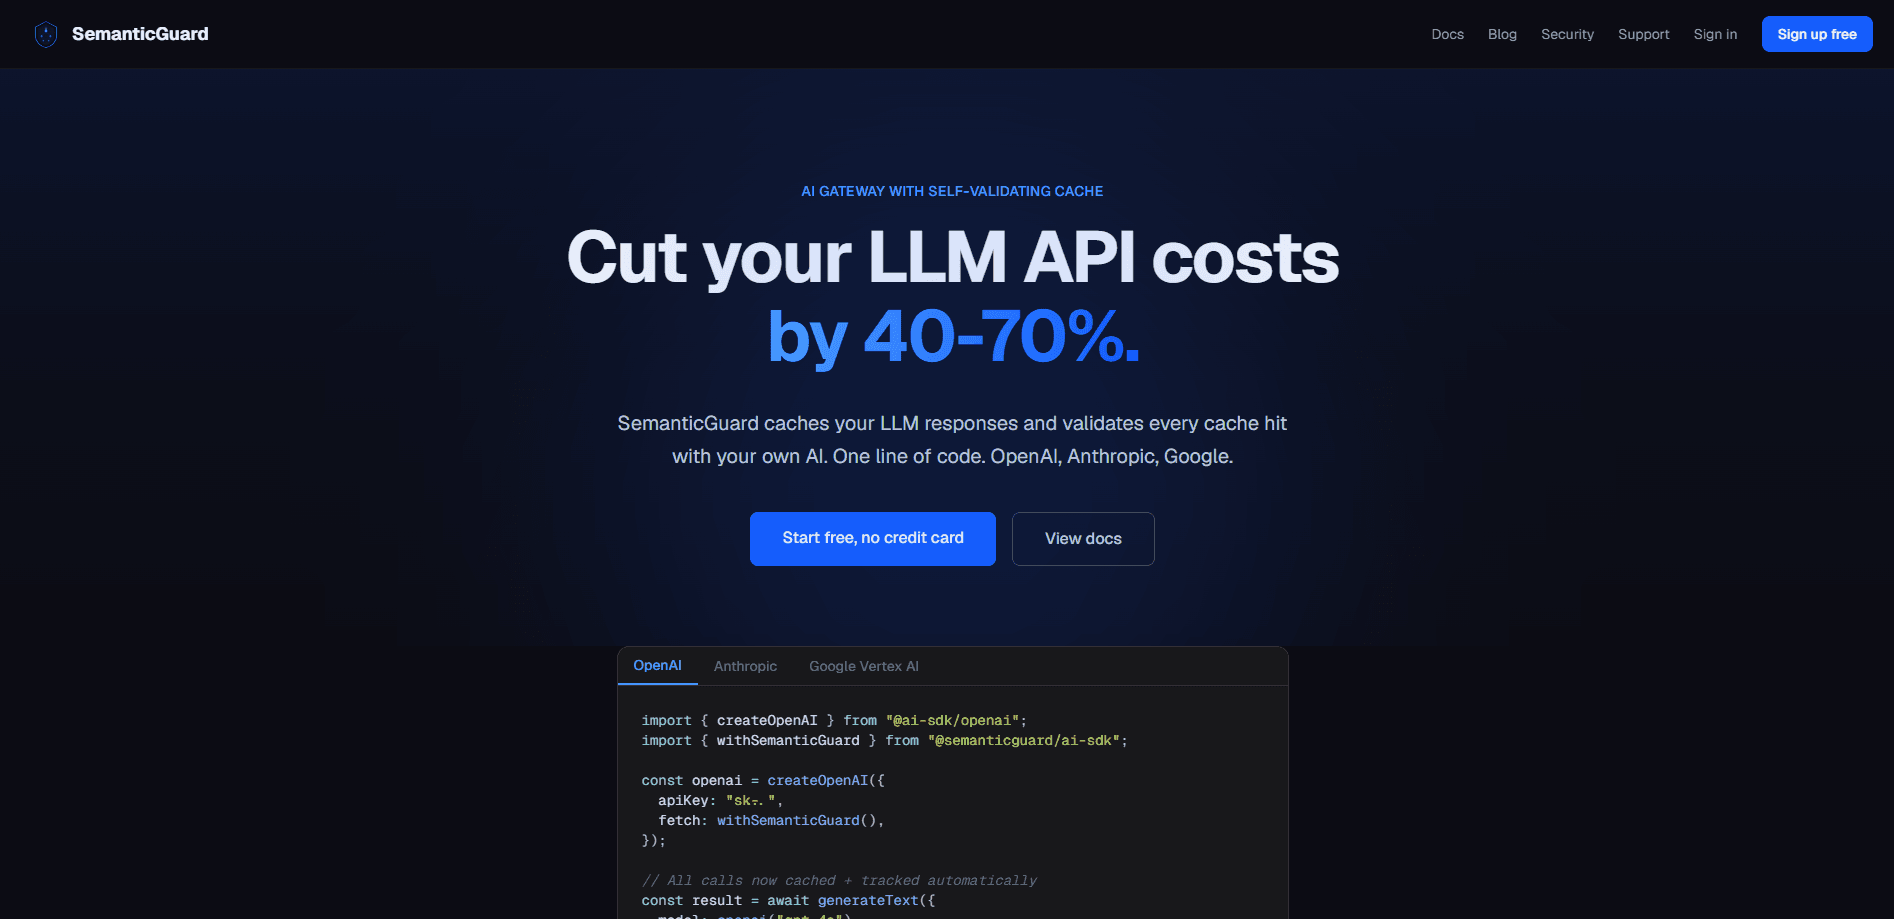
SemanticGuard es una puerta de enlace de IA que se coloca entre tu aplicación y los proveedores de LLM que ya usas. Hace dos trabajos a la vez: guarda las respuestas en caché para que dejes de pagar el precio completo por preguntas repetidas, y audita y controla las llamadas de herramientas que hacen tus agentes de IA. El proveedor reporta un ahorro medio del 50% en el gasto de LLM en su propio benchmark, con un plan gratuito pensado para 10K solicitudes al mes y un plan Pro a $49/mes.
Acerca de SemanticGuard
Qué es SemanticGuard
SemanticGuard es un proxy compatible con OpenAI con una caché semántica autovalidada. Apunta tu cliente hacia él en lugar del proveedor, inserta una clave de API de SG, y cada solicitud queda cacheada, registrada y rastreada. ¿El gancho? La caché no confía en sí misma. Una segunda capa revisa los aciertos con tu propia IA antes de servirlos, así una paráfrasis que cae cerca de una consulta antigua no devuelve en silencio la respuesta equivocada.
La otra mitad es la gobernanza de agentes de IA. Cada llamada de herramienta que emite tu LLM aparece en un feed de actividad con su nombre, argumentos, modelo y atribución de sesión. Un clasificador califica cada llamada como lectura, escritura o destructiva. Después, un motor de políticas la permite, la deniega o la marca para aprobación. Eso atrapa el fallo clásico donde un run_shell de aspecto inofensivo envuelve a escondidas un rm -rf, o un agente intenta hacer push directamente a main.
El problema es que esto es infraestructura, no una app de consumo. Necesitas un sitio donde ejecutarlo, claves de API que gestionar y al menos una idea clara de cómo fluye tu tráfico de LLM. El caché también asume que hay repetición real en tu tráfico; una app de bajo volumen con prompts únicos cada vez verá poco beneficio. El Modo Sombra existe para que midas tu propio ahorro antes de gastar un dólar.
Primeros pasos
- Regístrate en semanticguard.dev y crea una clave de API en el panel. No hace falta tarjeta de crédito para el plan gratuito.
- Activa el Modo Sombra primero. Registra cada solicitud y te muestra cuánto ahorrarías antes de que se sirva de verdad una respuesta cacheada.
- Enruta tu tráfico a través del proxy. Configura
ANTHROPIC_BASE_URLpara Claude Code, o añade el wrapper fetch del AI SDK con tu clave de SG a las llamadas de OpenAI, Anthropic, Google, Azure, Bedrock o Mistral. - Revisa el panel hasta que te sientas cómodo con el ahorro proyectado, luego habilita el caché y define tus reglas de política para llamadas destructivas de herramientas.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de SemanticGuard.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores en busca de ahorro en costos de LLM
- Equipos de ingeniería que usan gobernanza de agentes de IA
Tareas
- Recortar el gasto de API de LLM
- Auditar llamadas de herramientas de los agentes
- Bloquear acciones destructivas de los agentes
Casos de uso
- Agentes en producción que tocan sistemas en vivo
- Configuraciones con varios proveedores
- Equipos que quieren un único proxy de Claude Code
Funciones clave
Caché semántica autovalidada
La caché coincide por significado, no solo por palabras, así que una pregunta reformulada igual puede acertar. Lo que la distingue es la capa de validación: los aciertos se revisan con verificación multicapa y un muestreo continuo juzgado por IA, así que la corrección se trata como algo que hay que demostrar y no dar por hecho. El proveedor afirma un 100% de corrección de la caché en su benchmark público, y el caché entre proveedores significa que la respuesta de un modelo puede servir a una paráfrasis dirigida a otro.
Gobernanza de llamadas de herramientas de los agentes
Cada llamada de herramienta que emite tu LLM aterriza en un feed de actividad con el nombre de la herramienta, los argumentos, el modelo y la atribución completa de la sesión. Un clasificador determinista califica cada llamada como lectura, escritura o destructiva. Si ya enrutas por SemanticGuard, esto funciona sin ningún cambio de código.
Motor de políticas con reglas de aprobación
Tú decides qué se ejecuta y qué no, por patrón, nivel de riesgo, espacio de trabajo o usuario. Trae valores predeterminados sensatos desde el primer día: denegar llamadas destructivas en prod, exigir aprobación para los despliegues, bloquear PR a main. Las ediciones de reglas aparecen en el rastro de auditoría en segundos.
Integración con el AI SDK en una línea
Añade un wrapper fetch a cualquier proveedor con el Vercel AI SDK. Funciona con OpenAI, Anthropic, Vertex AI y cualquier otra cosa que acepte una función fetch personalizada. Para Claude Code y otros clientes del SDK de Anthropic, configurar una variable de entorno enruta el tráfico por la puerta de enlace con seguimiento de costos, auditoría y redacción de datos personales incluidos.
Modo Sombra
Antes de que confíes en la caché, el Modo Sombra registra todo y reporta cuánto habrías ahorrado, sin servir ni una sola respuesta cacheada. Es la forma honesta de averiguar si tu tráfico se repite lo suficiente para justificar el cambio. El plan gratuito gira en torno a esto, sin tarjeta de crédito.
Despliegue autoalojado en tu propio tenant
Instalar desde el Vercel Marketplace despliega el proxy en tu propia cuenta de Vercel, respaldada por tu Neon Postgres, Upstash Redis y Upstash Vector. Los prompts, las respuestas, los embeddings y el contenido del caché nunca salen de tu tenant; solo la licencia, la validación de la clave de API y un latido de salud llegan al plano de control de SemanticGuard.
Observabilidad y controles por tenant
El panel cubre análisis de costos y trazado por solicitud, con un endpoint de Prometheus para equipos que envían métricas a su propia pila. Cada tenant tiene su propio interruptor de corte y registro de auditoría.
Ventajas y desventajas
Ventajas
- Financia su propio costo recortando el gasto de LLM que elimina, en vez de añadir una partida aparte.
- El caché entre proveedores es de verdad poco común; los cachés nativos de OpenAI y Anthropic se quedan cada uno dentro de sus propios modelos.
- La gobernanza llega con una variable de entorno o un wrapper fetch, así que adoptarla no exige reescribir el agente.
- La opción autoalojada mantiene los prompts, las respuestas y los embeddings dentro de tu propia VPC.
- La validación de corrección con muestreo juzgado por IA aborda el miedo principal que tiene la gente a la caché semántica.
Desventajas
- El ahorro depende de que tu tráfico se repita; los prompts únicos sin solapamiento mostrarán poco beneficio, así que el Modo Sombra es un primer paso obligatorio.
- El plan Enterprise se cobra al 15% del ahorro documentado con un mínimo de $500/mes, algo más difícil de predecir que una tarifa fija.
- Algunas piezas de gobernanza, como la bandeja de aprobación con humano en el bucle y el proxy de la capa MCP, siguen en la hoja de ruta.
- Las 10K solicitudes/mes del plan gratuito se agotan rápido para equipos que prueban a volumen real.
Preguntas frecuentes
Es una puerta de enlace de IA con dos mitades. Una cachea las respuestas de LLM para recortar el costo de la API, y la otra audita y controla las llamadas de herramientas que hacen tus agentes. Enrutas tu tráfico de LLM actual por ella y ambas funciones corren sobre las mismas solicitudes.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con SemanticGuard.
Alternativas a SemanticGuard
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.