
Soup CLI
MePlay, Inc. · Programación
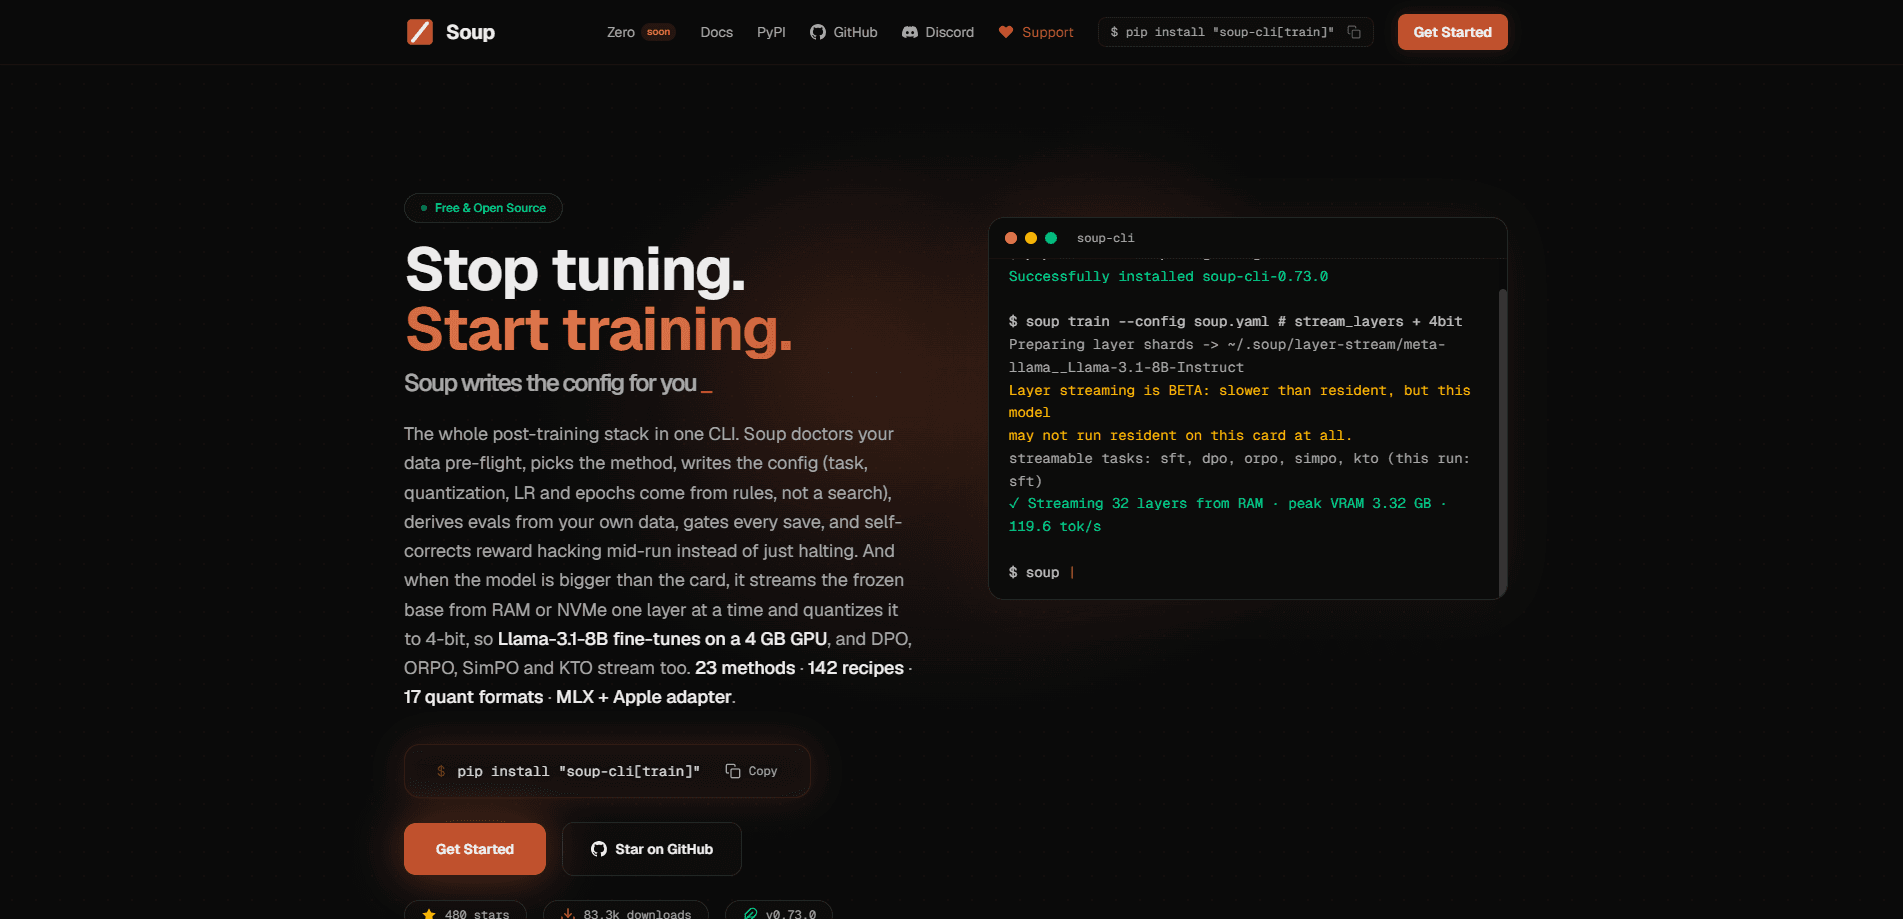
Soup CLI es una herramienta de línea de comandos de código abierto para ajustar y post-entrenar modelos de lenguaje grandes. Como herramienta para ajustar LLM, convierte el trabajo de configuración habitual en un solo flujo: escribes un único archivo YAML, ejecutas `soup train` y Soup se encarga solo de detectar la GPU, calcular el tamaño de lote y la cuantización. El proyecto está pensado para quienes quieren ajustar modelos en local en vez de alquilar GPU en la nube o pelearse con scripts de entrenamiento, y su función estrella, el streaming de capas, permite entrenar un modelo de 8B en la GPU de un portátil con solo 4 GB de VRAM.
Acerca de Soup CLI
Qué es Soup CLI
Soup CLI (también publicado como el paquete Python soup-cli) es un stack centrado en la línea de comandos que cubre todo el ciclo de post-entrenamiento: limpieza de datos, elección de método, generación de configuración, evaluación y filtrado de checkpoints. Lo mantiene MePlay, Inc. y se publica bajo la licencia Apache-2.0, así que puedes leer el código, hacer un fork o integrarlo en tu propio pipeline.
El problema principal que resuelve es la fricción. Quien haya entrenado un modelo conoce el ritual: elegir hardware, pelear con conflictos de dependencias, adivinar el tamaño de lote y depurar un fallo en el paso 400. Soup comprime todo eso en un archivo de configuración que escribe por ti. ¿Por qué importa? Porque la puesta en marcha, y no el entrenamiento en sí, es donde mueren la mayoría de los ajustes de principiante. Va dirigido a desarrolladores, investigadores y equipos pequeños que quieren un ajuste funcional sin convertirse en ingenieros de infraestructura.
La mayor limitación es el hardware. El entrenamiento sigue pidiendo una GPU CUDA, y ejecutar un trabajo real de 7B a 8B en una máquina normal implica aceptar QLoRA y pesos cuantizados en lugar de entrenamiento a plena precisión. Ese es el intercambio. El streaming de capas, la función que hace viables las GPU pequeñas, todavía está etiquetado como BETA y hay que activarlo a mano.
Primeros pasos
- Instala el paquete. Usa
pipx install "soup-cli[train]"ouv tool install "soup-cli[train]". La instalación simple desoup-clies una CLI ligera sin PyTorch, así que necesitas el extra[train]para ajustar. - Genera una configuración. Ejecuta
soup init --template chatpara crear unsoup.yamlde arranque para un ajuste de estilo chat. - Apúntalo a tus datos y al modelo base. Edita el YAML para fijar la ruta de tu dataset y el modelo que quieres adaptar.
- Empieza el entrenamiento. Ejecuta
soup trainy deja que detecte tu GPU y elija los ajustes. Para modelos grandes en tarjetas pequeñas, activa antesstream_layers: true. - Sirve o exporta el resultado. Usa
soup servepara exponer el modelo ajustado detrás de un endpoint de API compatible con OpenAI.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Soup CLI.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores individuales y aficionados
- Ingenieros de ML e investigadores
- Startups pequeñas
Tareas
- Ajuste supervisado
- Optimización de preferencias
- Experimentación local
Casos de uso
- Flujo solo con portátil
- Ajuste privado
- Convertir un modelo ajustado en servicio
Funciones clave
Una configuración, un comando
La idea central es que un único archivo YAML describe todo el trabajo. Ejecutas soup init para generar una configuración inicial, editas unos campos y luego ejecutas soup train. Soup lee la configuración, revisa tu GPU y elige un tamaño de lote y una cuantización que encajen. Para quien ha mantenido una carpeta de scripts de entrenamiento en shell, ese es el atractivo: la configuración es la documentación.
Streaming de capas para GPU diminutas
El streaming de capas es la función que más atención recibe. En vez de cargar todo el modelo base congelado en la VRAM, Soup lo mantiene fuera de memoria y alimenta la GPU con una capa decodificadora a la vez. En una RTX 3050 Laptop con 4 GB, el proyecto reporta un modelo de 8B corriendo con 3,32 GB de memoria máxima. Un resultado enorme. El pero es que es opcional y sigue en BETA, y las cifras de rendimiento vienen de una versión antigua concreta, así que toma la velocidad como un mínimo y no como una promesa.
Evaluación integrada y filtrado de checkpoints
Soup no se detiene en el entrenamiento. Deriva evaluaciones de tu configuración y filtra los checkpoints contra ellas, así que una ejecución que empeora queda marcada en lugar de guardarse en silencio. Para equipos que entrenan a menudo, esto importa más que la velocidad bruta. Quieres un pipeline que te avise cuando un checkpoint es peor que el anterior.
Servicio compatible con OpenAI
El comando soup serve convierte un modelo entrenado en un servicio de API con un solo comando. Expone los endpoints estándar /v1/chat/completions, /v1/models y /health, admite respuestas en streaming y puede cambiar a backends vLLM o SGLang para mayor rendimiento. Los adaptadores LoRA se pueden servir directamente, con el modelo base resuelto desde la configuración del adaptador, así que no tienes que fusionar los pesos a mano primero.
Local primero, sin nube
Todo está pensado para correr en hardware que ya tienes. No hace falta nube. No hay cuenta obligatoria, ni panel alojado, ni datos que salgan de tu máquina salvo que tú lo configures. Para equipos que manejan datos sensibles, eso suele ser el factor decisivo frente a un servicio de entrenamiento gestionado.
Herramientas de datos y comandos de inspección
La instalación ligera de soup-cli igualmente incluye soup data ... y comandos de inspección que funcionan sin PyTorch. Eso significa que puedes limpiar e inspeccionar tu dataset en una máquina sin GPU ninguna. Prepara ahora, entrena después.
Ventajas y desventajas
Ventajas
- Código abierto bajo Apache-2.0, así que no hay dependencia de un proveedor y el código es totalmente auditable.
- Un único archivo YAML de configuración reemplaza casi todo el scripting y la puesta en marcha que suele exigir el ajuste.
- El streaming de capas hace entrenables modelos realmente grandes en GPU pequeñas de consumo.
- El servicio y la evaluación forman parte de la misma herramienta, no son utilidades separadas que haya que conectar.
- Funciona totalmente sin conexión, lo que mantiene datos y pesos en tu propio hardware.
Desventajas
- El streaming de capas, la función estrella, sigue en BETA y hay que activarlo a mano, así que no es una opción de configurar y olvidar.
- El mejor rendimiento supone una GPU CUDA; el soporte de Apple Silicon y CPU es experimental y lento.
- La instalación dividida puede confundir a los novatos, ya que un simple `pip install soup-cli` no te deja entrenar hasta que añades el extra `[train]`.
- La documentación es densa y específica de cada versión, así que los consejos de guías antiguas pueden no coincidir con la versión actual.
Preguntas frecuentes
Es una herramienta de línea de comandos de código abierto para ajustar y post-entrenar modelos de lenguaje grandes. Defines un trabajo en un archivo YAML y ejecutas soup train, y se encarga por ti de detectar la GPU, la cuantización y el lote.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Soup CLI.
Alternativas a Soup CLI
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.