
Supermemory
Supermemory · Productividad · Aprendizaje
Supermemory es una API de memoria para IA que da a los agentes contexto duradero entre sesiones. Extrae hechos, arma perfiles y los devuelve por búsqueda o MCP.
Acerca de Supermemory
What Is Supermemory
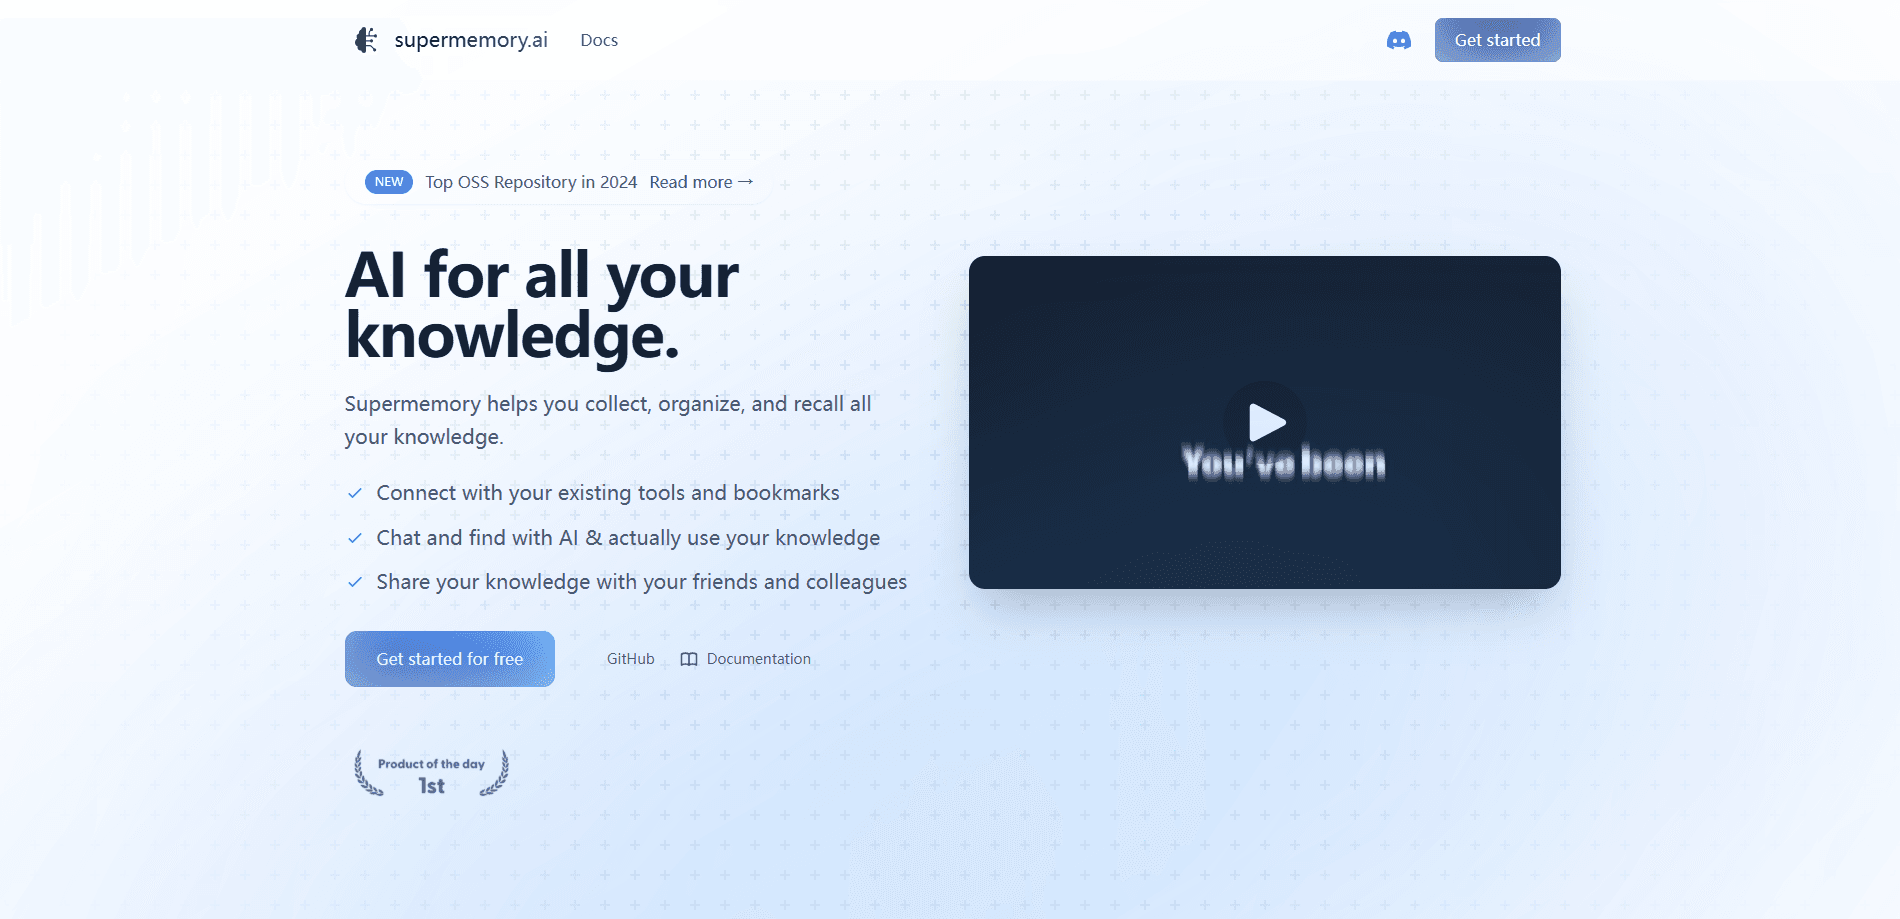
Supermemory es una capa de memoria a largo plazo para IA, un motor de memoria y contexto pensado para agentes. Le envías lo que ve tu agente, ya sean chats, archivos, URLs o una unidad sincronizada, y convierte esa entrada en hechos estructurados. Esos hechos se conectan entre sí y se rastrean en el tiempo, y luego vuelven como un perfil, un resultado de búsqueda o un archivo que el agente puede leer. El equipo lo llama el motor por defecto para memoria y aprendizaje continuo, y funciona con cualquier modelo y cualquier entorno, sin atarte a un solo proveedor.
El problema que ataca es simple. Casi todas las herramientas de IA olvidan todo entre conversaciones, así que repites tus preferencias y tu contexto en cada sesión nueva. Montar esa memoria por tu cuenta suele implicar pegar una base de datos vectorial a una app y escribir a mano la lógica que decide qué guardar. Supermemory se hace cargo de ese trabajo. Ejecuta memoria y recuperación juntas, así los hechos se fusionan, se actualizan, se contradicen o se descartan cuando llega información nueva, en lugar de acumularse como fragmentos obsoletos.
El límite principal es el alcance y el costo. Es infraestructura para desarrolladores, no una app de consumo que abres y usas para chatear. Necesitas una clave de API y algo de código para sacarle provecho, y una ingesta pesada consume contra un saldo mensual de créditos que se mide por cada mil tokens procesados. Las empresas que quieren extracción avanzada de PDF o despliegue autoalojado y aislado tienen que subir al plan Scale o Enterprise.
Getting Started
- Crea una cuenta en console.supermemory.ai y revisa el plan gratuito, que incluye $5 en créditos cada mes.
- Genera una clave de API, instala el SDK para TypeScript o Python, o conecta el servidor MCP en mcp.supermemory.ai.
- Envía tu primer contenido con una llamada a add(), etiquetándolo con un containerTag que aísle a un usuario, proyecto o cliente.
- Consulta lo que guardaste con search() para obtener resultados híbridos más el grafo alrededor de cada acierto, o profile() para los hechos fijos de un usuario.
- Mantén los datos al día cambiando las subidas manuales por un conector como Google Drive, Notion o Gmail, para que los cambios se sincronicen solos.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Supermemory.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores que crean agentes de IA
- Startups con productos de chat o asistentes
- Equipos con reglas estrictas de datos
Tareas
- Mantener el contexto del asistente entre sesiones
- Construir conocimiento consultable desde archivos mezclados
- Generar resúmenes de soporte o ventas
- Probar la memoria en local
Casos de uso
- Un agente de código que recuerda un proyecto
- Un asistente personal en varios dispositivos
- Un backend SaaS multiinquilino
Funciones clave
Memoria que infiere, actualiza y olvida
Supermemory no guarda una carpeta plana de embeddings. Construye un grafo vivo donde los hechos nuevos actualizan, amplían o derivan de los viejos, y los hechos caducados se apartan cuando cambia el contexto. El historial se conserva para auditoría, así ves por qué una respuesta actual sustituyó a una anterior.
API de perfiles sin consulta
Una API de perfiles te da una foto fija de cada usuario, tarea o cliente, adjunta a cada turno sin llamada de búsqueda. Guarda hechos estáticos como el nombre o la zona horaria, más otros vivos que cambian según interactúa la gente, lo que reduce varias búsquedas a una sola llamada de decenas de milisegundos.
Búsqueda híbrida y recorrido del grafo
Una llamada devuelve búsqueda semántica sobre memorias, fragmentos de documentos o ambos, con filtros, reordenación y las conexiones del grafo alrededor de cada resultado. El tiempo medio de servidor ronda los 187 ms, una cifra que el equipo publica para bucles de agentes que no pueden esperar.
SuperRAG para documentos
SuperRAG extrae, fragmenta y recupera PDF, imágenes, audio, vídeo y código con un troceado contextual que sigue el significado y no el recuento de caracteres. No hay embeddings ni almacenes vectoriales que tú tengas que correr, lo que quita toda una capa de mantenimiento.
Conectores que siguen sincronizando
Google Drive, Gmail, Notion, OneDrive, GitHub, Granola, Amazon S3 y un rastreador web se conectan con un clic de OAuth. La primera sincronización importa todo, los webhooks llevan los cambios en segundos, y una pasada programada cada cuatro horas captura lo que un webhook dejó pasar.
Corre en cualquier sitio, incluso aislado
El mismo motor y la misma API corren en la nube de Supermemory, en tu propia VPC o instancia dedicada, o en tu portátil como binario local. El código escrito contra el servidor local pasa a la nube cambiando una URL base.
Ventajas y desventajas
Ventajas
- Una sola API cubre ingesta, búsqueda y perfiles, así los equipos se ahorran montar un sistema de recuperación aparte.
- Los benchmarks quedan en lo más alto de LongMemEval, LoCoMo y ConvoMem, y el equipo publica los resultados.
- Un plan gratuito con $5 en créditos al mes más un Pro de $19 al mes mantienen barato el punto de entrada.
- Los conectores y el soporte MCP hacen que la memoria siga al usuario entre ChatGPT, Claude y agentes de código.
- Scale y Enterprise añaden SOC 2, HIPAA, GDPR y despliegue aislado para el trabajo regulado.
Desventajas
- Es infraestructura para desarrolladores, así que quien no programa saca poco sin una clave de API y trabajo de integración.
- El uso se mide por mil tokens, y una ingesta pesada puede agotar rápido el saldo de créditos incluido.
- La extracción avanzada de PDF con OCR de figuras queda tras el plan Scale de $399 al mes y superiores.
- Los puestos de equipo están limitados a 1 en el plan gratuito y 3 en Pro, algo que frena a los equipos que crecen antes de llegar a Scale.
Preguntas frecuentes
Es una capa de memoria para agentes de IA. Le envías contenido como chats, archivos o URLs, lo convierte en hechos y perfiles estructurados, y los devuelve por búsqueda o por una conexión MCP para que un agente conserve el contexto entre sesiones.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Supermemory.
Alternativas a Supermemory

Udon
Udon · Programación · ProductividadUdon convierte un Mac con Apple Silicon en un servidor doméstico que se gestiona desde el navegador, con contenedores, archivos compartidos y un administrador de sistemas con IA opcional.

offstage
offstage cloud · Programación · Productividadoffstage da a los agentes de IA y a los trabajos de CI un Mac de verdad: una cuenta de macOS 27 sobre Apple silicon, manejada por API y cobrada por segundo.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programación · ProductividadBotBus te deja controlar desde el móvil y el reloj los agentes de programación con IA que corren en tu ordenador: apruebas comandos, lanzas tareas y lees resultados sin volver al escritorio.