
Lightning Rod: Generate training data
Lightning Rod · Programación · Otro
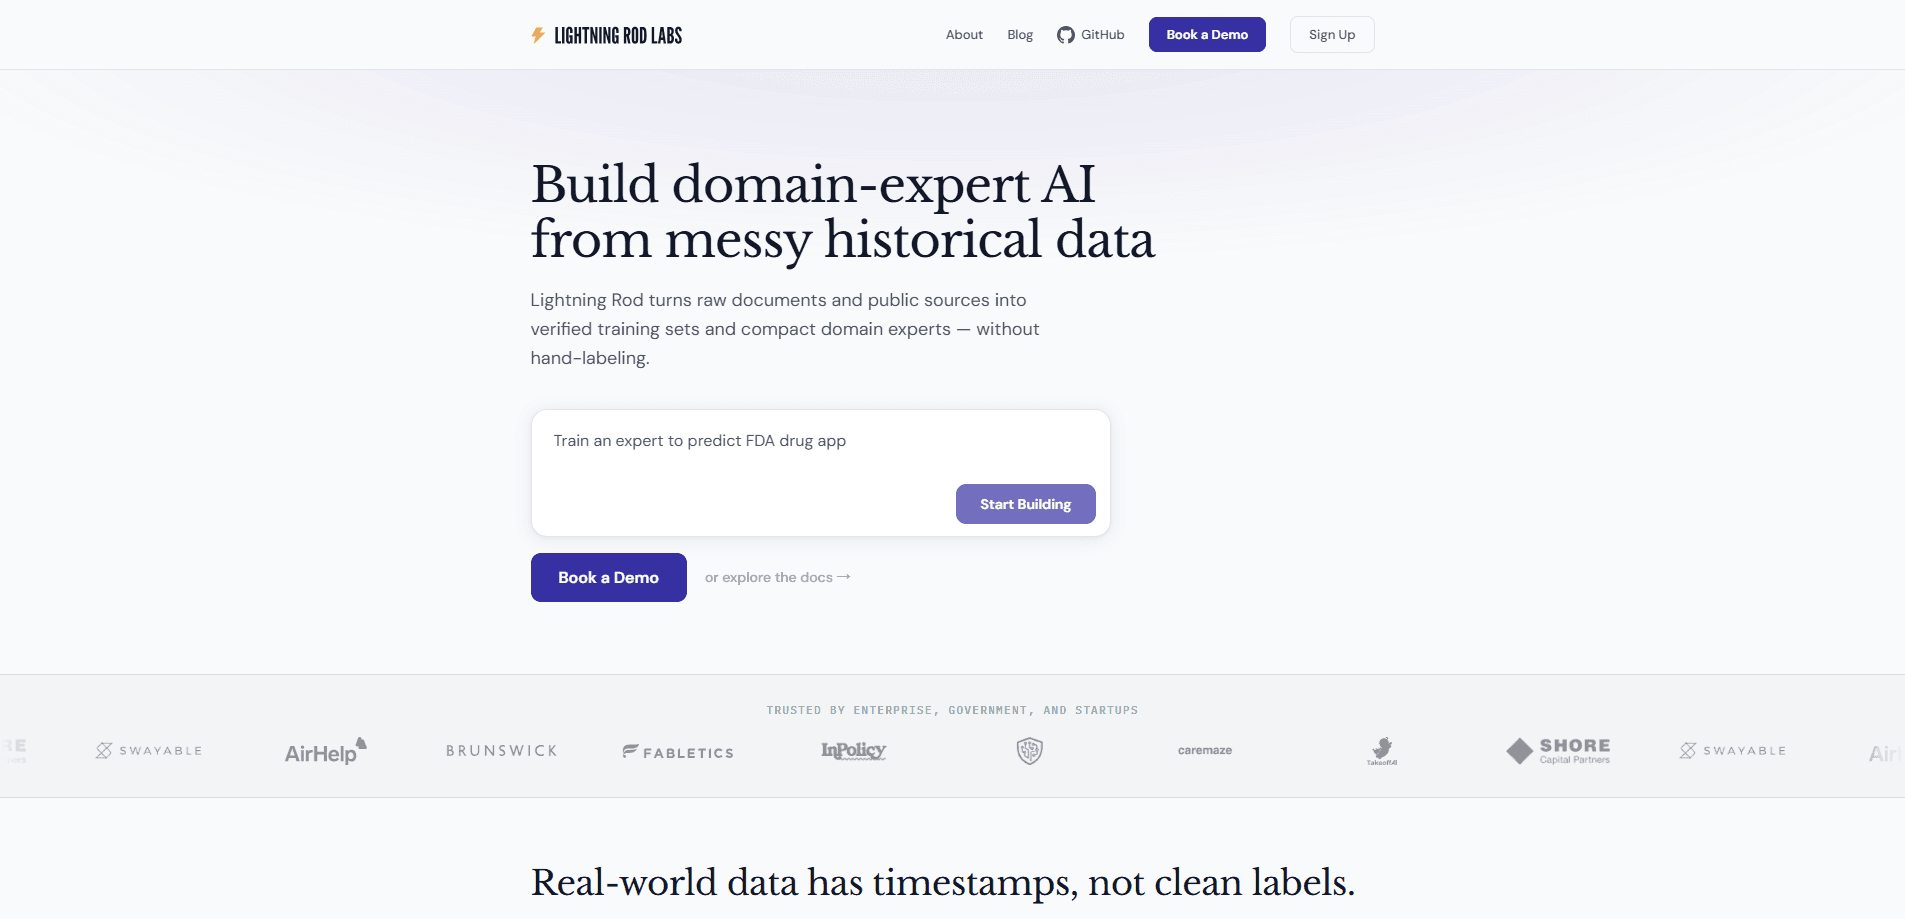
Lightning Rod es una plataforma de datos de entrenamiento para IA que funciona como generador de datos de entrenamiento para equipos que quieren modelos personalizados. Convierte datos operativos desordenados en datasets limpios y verificados para crear modelos expertos en un dominio. Se encarga de la preparación de datos, el entrenamiento, la evaluación y el despliegue. También incluye una API de predicción llamada Foresight que devuelve probabilidades calibradas a través de cualquier cliente compatible con OpenAI. La propuesta es sencilla. Tu negocio ya tiene el historial que un modelo necesita, y Lightning Rod te ayuda a usarlo sin contratar a un equipo de etiquetado.
Acerca de Lightning Rod: Generate training data
Qué es Lightning Rod
Lightning Rod es un servicio para equipos que quieren modelos de IA personalizados en lugar de genéricos. Le das los registros con marca de tiempo que ya guardas, como tickets de soporte, notas de ventas o registros operativos, y los estandariza en entornos de entrenamiento por refuerzo. La idea central de la empresa es "Future-as-Label": los resultados reales que ocurren después actúan como verdad de referencia, así nadie tiene que sentarse a etiquetar miles de ejemplos a mano.
Hay dos cosas que destacan. Primero, los modelos que entrena son compactos, así que la inferencia cuesta mucho menos que ejecutar un modelo de frontera en cada llamada. Segundo, el despliegue es flexible. Puedes correr el modelo terminado en tu propia nube o en la de Lightning Rod, algo que importa si tus datos no pueden salir de tu infraestructura.
La plataforma también tiene un producto público de predicción. Los modelos Foresight responden preguntas sobre el futuro, como si un contrato se renovará o cómo se moverá un mercado, y devuelven una probabilidad calibrada en lugar de un párrafo vago. Entonces, ¿qué obtienes en concreto? Un número sobre el que puedes actuar. Esa API es útil por sí sola, incluso si nunca tocas la plataforma de entrenamiento empresarial.
El límite principal es que no es una app de autoservicio para explorar gratis. El lado empresarial funciona mediante una conversación con ventas, y los precios son por cotización. No es lo ideal si te gusta probar primero. Si quieres ver la tecnología en acción antes de comprometerte, la API de predicción es la vía más barata para entrar.
Primeros pasos
- Decide qué camino te conviene: la API de predicción para predicciones rápidas, o la plataforma empresarial para un modelo personalizado.
- Para la API, consigue una clave en el panel de Lightning Rod, o paga una pequeña recarga vía MPP si quieres créditos sin registrarte.
- Apunta cualquier cliente compatible con OpenAI a
https://api.lightningrod.ai/v1/openaiy elige un modelo comoforesight-v4. - Envía una pregunta sobre el futuro, añadiendo tu propio contexto o activando el modo de investigación para fuentes externas.
- Para un modelo personalizado, agenda una llamada, conecta tus fuentes de datos y deja que el pipeline genere, ajuste y evalúe el dataset.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Lightning Rod: Generate training data.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Startups con datos propios
- Equipos empresariales y gubernamentales
- Desarrolladores y analistas
- Ingenieros de IA que investigan
Tareas
- Crear datasets de entrenamiento
- Predecir resultados de negocio
- Ajustar modelos de dominio
- Evaluar el rendimiento del modelo
Casos de uso
- Un equipo de ventas que quiere predecir resultados de tratos a partir del historial del CRM
- Un equipo clínico o de cadena de suministro que predice riesgo operativo
- Un desarrollador que prototipa un agente que necesita predicciones
- Una empresa que debe mantener los datos en su propia nube
Funciones clave
Datos de entrenamiento con Future-as-Label
En lugar de pedir a la gente que etiquete ejemplos a mano, Lightning Rod usa lo que realmente pasó después como etiqueta. Si un trato se cerró o un contrato se renovó, ese resultado es la verdad de referencia para una pregunta anterior. El resultado es un conjunto de entrenamiento construido con tu historial real. Las partes desordenadas siguen desordenadas, y eso es a propósito. Aquí también la generación de datos sintéticos cede paso a algo más anclado, porque cada ejemplo se remonta a un resultado real.
Pipeline de datos configurable
La plataforma ingiere noticias, documentos y datos personalizados y los pasa por un pipeline que genera datasets de predicción etiquetados. Cubre todo el ciclo, desde generar preguntas y respuestas hasta el fine-tuning y la evaluación. Los equipos no tienen que montar su propio sistema de limpieza de datos para empezar.
API de predicción Foresight
Foresight es una familia de modelos de predicción que devuelven probabilidades calibradas sobre preguntas futuras. Es compatible con OpenAI, así que puedes meterla en código existente cambiando la URL base y el nombre del modelo. Hay dos modelos disponibles: foresight-v4 y el más antiguo foresight-v3.
Modo de investigación y contexto personalizado
Por defecto, los modelos de predicción solo trabajan con lo que aprendieron durante el entrenamiento. Para respuestas más precisas, aportas tu propio contexto agregado o activas el modo de investigación, que tira de fuentes como Perplexity y Google News. Ese montaje deja que un desarrollador ajuste cuánta evidencia externa alimenta cada predicción.
Despliegue flexible y seguro
Los modelos terminados pueden correr en tu nube o en la de Lightning Rod. Es un diferenciador real para industrias reguladas, donde la alternativa suele ser un servicio alojado que guarda tus datos en servidores ajenos. Los modelos compactos también bajan el coste por llamada una vez desplegados.
Modelos compactos que superan a la IA de frontera
Según Lightning Rod, sus modelos han superado a sistemas de frontera en varias tareas de dominio y han alcanzado el rango de Superforecaster en ForecastBench, corriendo en una sola GPU. Es una afirmación grande. Conviene tomarla con cautela hasta probarla en tu propio caso de uso, pero la dirección está clara: modelos más pequeños, más baratos y ajustados a un solo problema.
Predicciones estructuradas y SDK
La API devuelve texto plano por defecto, lo cual está bien para que una persona lea el resultado. Para trabajo programático, una extensión answer_type devuelve salida estructurada, y un SDK de Python se encarga del parseo con una sola llamada lr.predict(). Así es más fácil conectar las predicciones a un flujo de trabajo automatizado.
Ventajas y desventajas
Ventajas
- No hace falta etiquetado manual, lo que elimina la parte más lenta y cara de crear un dataset personalizado.
- La API Foresight es compatible con OpenAI, así que la integración es un cambio de configuración y no una reescritura.
- Los modelos se pueden desplegar en tu propia nube, algo que le va bien a equipos con reglas estrictas de datos.
- Los modelos compactos recortan el coste de inferencia frente a llamar a un modelo de frontera en cada petición.
- La API de predicción se puede probar con una pequeña recarga, sin registro ni panel.
Desventajas
- No hay nivel gratuito de autoservicio, así que no puedes probar del todo la plataforma empresarial sin hablar con ventas.
- El precio empresarial es por cotización, lo que complica presupuestar por adelantado.
- El pipeline de entrenamiento depende de tener años de datos históricos con marca de tiempo, así que las organizaciones más nuevas tienen menos con qué trabajar.
- Los modelos de predicción no tienen fuentes externas por defecto, así que los resultados empeoran salvo que aportes contexto o actives el modo de investigación.
Preguntas frecuentes
Crea modelos de IA personalizados a partir de los datos que ya tienes. La plataforma convierte registros desordenados con marca de tiempo en datasets de entrenamiento verificados, luego ajusta y sirve un modelo compacto hecho a medida para tus flujos de trabajo, todo sin contratar a un equipo de etiquetado ni escribir preguntas a mano.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Lightning Rod: Generate training data.
Alternativas a Lightning Rod: Generate training data
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.