
UbiOps
UbiOps · Productividad · Marketing · Aprendizaje · Otro
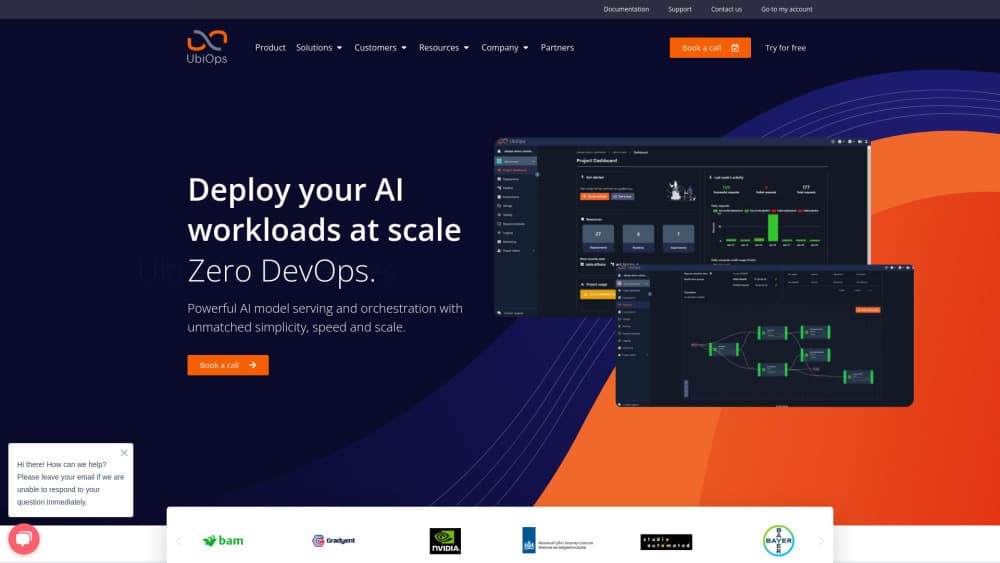
UbiOps es una plataforma de serving de modelos de IA y MLOps que convierte tu código Python o un LLM en una API escalable en tu nube, en hardware propio o en ambos a la vez.
Acerca de UbiOps
About
Qué es UbiOps
UbiOps es una plataforma neerlandesa para equipos que necesitan poner IA en producción sin montar su propia capa de serving de modelos en GPU ni en CPU. Tú aportas el código del modelo o una imagen de contenedor. UbiOps se encarga de construir el contenedor, publicar el endpoint, gestionar la cola de peticiones, el balanceo, el autoescalado y los registros y métricas que todo eso genera.
La promesa central es la libertad de infraestructura. Un plano de control se sitúa por encima de tus entornos de cómputo y los trata como una sola bolsa de recursos, así que una carga puede correr hoy en una GPU local y saltar esta noche a una región de nube pública. Eso es lo que se entiende por IA en nube híbrida, y explica por qué la eligen hospitales, empresas eléctricas y organismos públicos con reglas de residencia de datos: no pueden entregar su información a un proveedor de APIs de modelos.
Conviene decir los límites desde el principio. No hay constructor visual de modelos ni catálogo de aplicaciones listas. Necesitas código que funcione, cierta soltura con Docker y una idea clara de qué debe recibir tu endpoint. Quien busca un creador de chatbots sin programar se equivoca de producto.
Primeros pasos
- Crea una cuenta en la web de UbiOps e instala el cliente de Python o la CLI si vas a trabajar con scripts.
- Define un entorno con tus dependencias o sube tu propia imagen Docker cuando los runtimes de Python disponibles no encajen.
- Crea un deployment, sube el código y declara el esquema de entrada y salida de su API.
- Elige un tipo de instancia, fija el mínimo y el máximo de instancias y activa el escalado a cero si el tráfico llega a ráfagas.
- Lanza una petición al endpoint para probarlo y, cuando necesites un flujo completo, encadena varios deployments en un pipeline.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de UbiOps.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de machine learning
- Equipos de ciencia de datos en sectores regulados
- Ingenieros de plataforma y MLOps
Tareas
- Servir un modelo como endpoint REST
- Ejecutar inferencia de modelos de lenguaje en tus GPUs
- Encadenar preprocesado, modelo y posprocesado
- Trabajos de entrenamiento con picos de demanda
Casos de uso
- Un servicio de visión por computador con picos imprevisibles
- Una prueba de concepto que debe convertirse en producto
- Una salida de un solo proveedor de nube
Funciones clave
Deployments con endpoint de API gestionado
Cada deployment recibe su propio endpoint HTTP versionado, su cola de peticiones y la validación de la entrada. Subes el código en un runtime compatible o tu propio contenedor, y UbiOps lo construye, lo arranca y lo expone. Las versiones nuevas se pueden promover o revertir sin borrar la anterior, así que un mal despliegue se arregla con dos clics.
Autoescalado con escalado a cero
La plataforma vigila el volumen de peticiones y añade o retira instancias por su cuenta. El escalado a cero apaga por completo los deployments inactivos, de modo que un modelo que recibe un puñado de llamadas al día no paga 24 horas de GPU parada. Los grupos de tipos de instancia permiten que un deployment prefiera tus GPUs locales y recurra a la nube cuando estén ocupadas.
Pipelines y operadores de flujo
La orquestación de IA es la parte que casi todos los equipos subestiman, y aquí es donde la plataforma se justifica. Los pipelines conectan varios deployments en un servicio que se llama con una sola petición, y cada objeto dentro escala por separado. Los operadores incluidos se ocupan de dividir, reensamblar, filtrar y enrutar datos según condiciones, lo que cubre buena parte de la fontanería que normalmente se escribe a mano. Un pipeline se puede importar, exportar y compartir con el equipo.
Experimentos y ejecuciones de entrenamiento
Además de servir, UbiOps ejecuta trabajos de entrenamiento sobre la misma infraestructura. Un experimento fija el entorno, el código y el hardware; las ejecuciones corren contra él, y puedes comparar resultados entre ejecuciones en la interfaz web. Los artefactos quedan en un almacenamiento que tú controlas, así que el modelo entrenado está a un paso de convertirse en deployment.
Servicios propios y tu propia imagen Docker
Los servicios exponen servidores HTTP de larga vida dentro de un deployment. Así se ejecutan los servidores GenAI de alto rendimiento que no encajan en el formato de petición estándar. Junto con las imágenes Docker propias, esta vía cubre pilas de inferencia tipo vLLM, aplicaciones con varios endpoints y cualquier cosa que espere HTTP sin envoltorio.
Monitorización, versiones y control de acceso
Los registros, las métricas de uso y las alertas vienen con la plataforma, así que un deployment que falla aparece antes de que lo note un usuario. El acceso por roles, las trazas de auditoría y el cifrado cubren el lado del cumplimiento, y los ajustes de tratamiento de datos te dejan decidir si las cargas se guardan o no.
Ventajas y desventajas
Ventajas
- Corre en tu hardware, en una nube pública o en una mezcla, algo que pocos servicios gestionados de inferencia permiten.
- El autoescalado incluye escalado a cero, así que los modelos con picos o de uso esporádico no se comen el presupuesto.
- Los pipelines con operadores incluidos reducen el código de pegamento en flujos de IA de varios pasos.
- El versionado y la reversión hacen menos arriesgado cada cambio de modelo en equipos sin un proceso de release propio.
- La misma plataforma sirve modelos y lanza entrenamientos, lo que evita un segundo proveedor de cómputo.
Desventajas
- No hay lista de precios pública. Tienes que hablar con ventas antes de estimar la factura mensual, y eso frena la planificación.
- Hay que escribir código de deployment y entender contenedores. Un analista o un usuario de negocio no llega lejos por su cuenta.
- La interfaz da por sabido el vocabulario de MLOps (entornos, tipos de instancia, peticiones), así que la primera semana exige leer de verdad.
- Aquí no se entrena ni se ajusta un modelo fundacional por ti. Ejecuta tu código, así que el trabajo de modelado sigue siendo tuyo.
Preguntas frecuentes
Toma tu código de modelo o de procesamiento de datos y lo ejecuta como una API de producción. La plataforma construye el contenedor, arranca el servicio, reparte peticiones entre instancias y ajusta la capacidad según el tráfico.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con UbiOps.
Alternativas a UbiOps

FloorGen
Vinit Kumar (FloorGen) · Productividad · IA chinaFloorGen es un creador de planos que funciona en el navegador y convierte una frase o un boceto en un plano 2D editable y un recorrido en 3D. Exporta a PDF, DXF o vídeo, y dibujar no exige cuenta.
Agibot
Agibot · Productividad · Asistente de IA · ChatbotAgibot es un agente personal de IA para Mac que sigue funcionando después de cerrar la ventana, ejecuta rutinas programadas y responde desde Telegram o Slack con tus propias claves de API.

Ayven
Alknoma · Productividad · NegociosAyven es un centro de control de IA de Alknoma que convierte un objetivo escrito en lenguaje natural en un plan con fechas, reparte las tareas entre tu equipo y sus agentes de IA y solo te pide aprobación cuando la decisión te corresponde.