

Unbody
Unbody (Unbody Labs) · Programación · Otro
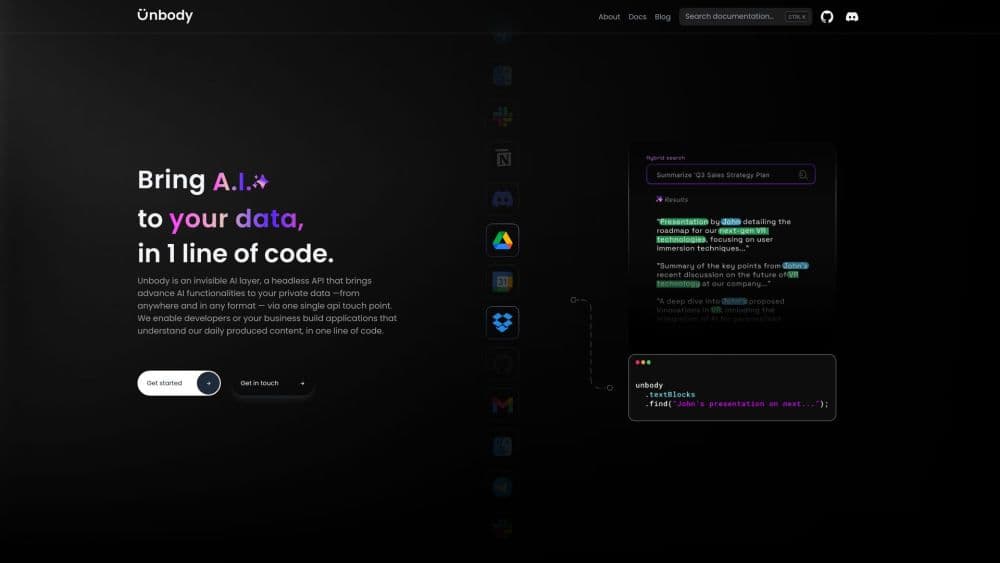
Unbody es un backend nativo de IA que ingiere, enriquece y vectoriza contenido y lo sirve desde una sola API GraphQL para búsqueda semántica, chatbots y respuestas generadas.
Acerca de Unbody
About
Qué es Unbody
Unbody es un backend para equipos que quieren funciones de IA sin montar la infraestructura a mano. Conectas una fuente de datos, eliges unos pasos de enriquecimiento y consultas el resultado desde un único endpoint GraphQL. La propuesta era un backend RAG y backend para chatbots en una sola caja: sin base de datos vectorial, servicio de embeddings, envoltorio de LLM y cola de trabajos que mantener sincronizados.
El diseño se reparte en cuatro capas. Percepción cubre la ingesta, el análisis, el enriquecimiento y la vectorización. Memoria guarda los objetos y los vectores resultantes. Razonamiento ejecuta las llamadas a modelos y las peticiones. Acción expone todo mediante API y SDK. Los conectores incluidos cubren Google Drive, Discord y GitHub, y la API Push acepta cualquier otra fuente con un esquema propio. Los enriquecedores añaden resúmenes, palabras clave, pies de foto, texto OCR y páginas rastreadas antes de indexar el contenido.
Hay un detalle que pesa más que cualquier función: Unbody ya no se desarrolla. El repositorio de GitHub está archivado, la aplicación alojada en app.unbody.io no carga y el dominio de documentación devuelve errores. Unbody Labs trabaja ahora en Adapt, un marco de memoria aparte. Esta página sirve como registro de lo que ofrecía la plataforma y como guía del código archivado si piensas ejecutarlo por tu cuenta. El código está en fase alfa y nadie publica correcciones.
Cómo empezar
- Instala Node.js 20 o 22, Docker, Docker Compose y yarn. Clona el repositorio unbody-io/unbody y ejecuta yarn para descargar las dependencias.
- Copia .env.example a .env.local y añade una clave de API de OpenAI. Esa clave alimenta los embeddings y los endpoints generativos.
- Levanta los servicios de apoyo con docker compose up y después ejecuta yarn start. Los trabajos de indexación pasan por Temporal, cuyo panel queda expuesto en el puerto 8233.
- Crea un proyecto y añade una fuente con el comando unbody-cli source add. A partir de ahí puedes seguir cómo los primeros archivos atraviesan el análisis, el enriquecimiento y la vectorización.
- Consulta el proyecto desde la API GraphQL o el SDK de TypeScript. El SDK envuelve las llamadas de recuperación, búsqueda y generación en un cliente encadenable.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Unbody.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores de backend que añaden búsqueda o chat a un producto existente
- Equipos de producto pequeños sin ingeniero de machine learning
- Equipos cuyo contenido ya vive en Google Drive, Discord o GitHub
Tareas
- Convertir un archivo de documentos en una base de conocimiento consultable
- Añadir un chatbot de documentación a una web
- Resumir y etiquetar contenido en lote
- Probar similitud semántica o visual
Casos de uso
- Evaluar un backend nativo de IA antes de construirlo en casa
- Mantener vivo un proyecto antiguo
- Enseñar o demostrar un pipeline RAG
Funciones clave
Una sola API GraphQL para el contenido
Todo lo que guarda la plataforma se consulta desde un endpoint GraphQL que funciona como API de base de conocimiento, con filtros, ordenación, paginación y objetos anidados en la misma consulta. Pides los campos que necesitas y recibes registros enriquecidos, incluidos resúmenes y palabras clave generados. Los endpoints de imagen y vídeo cubren el procesamiento de medios, y la API de administración gestiona proyectos y fuentes sin pasar por el panel.
Conectores listos y API Push
Google Drive, Discord y GitHub tienen integraciones ya hechas. Cada una define un punto de entrada, como una carpeta o un canal, y después extrae el contenido según un calendario. Para lo demás está la API Push, que acepta registros con un esquema definido por ti y cubre bases de datos internas, archivos exportados y fuentes propias. Esa combinación resolvía el arranque típico de un producto de conocimiento sin escribir un ETL a medida.
Pipelines de enriquecimiento
Antes de indexar, un pipeline configurable analiza el contenido y lanza enriquecedores sobre el resultado. AutoSummary redacta resúmenes breves, AutoKeywords extrae los términos importantes y AutoVision genera pies de foto, saca texto con OCR y etiqueta objetos. Los rastreadores convierten páginas web en registros estructurados. Los pipelines se montan en el panel o con la API de administración, y cabe registrar plugins propios cuando el conjunto incluido no basta.
Cinco modos de búsqueda
La API ofrece búsqueda semántica, búsqueda por palabras clave y búsqueda híbrida, además de dos modos de similitud: similitud de registros y similitud visual. La semántica busca por significado, lo que ayuda cuando las palabras del usuario no coinciden con el documento. La de palabras clave se mantiene predecible para términos exactos. La híbrida mezcla ambas. La visual trabaja con vectores de imagen, así que la foto de un producto encuentra parecidos dentro de un catálogo.
Búsqueda generativa y salida JSON
Sobre la recuperación se apoyan dos modos de generación. From One lanza un prompt contra cada objeto y puede insertar valores de sus campos en el texto. From Many toma un conjunto de objetos y produce un resultado único para todos, útil en resúmenes y comparaciones. Un modo aparte devuelve JSON estructurado validado contra un esquema, pensado para extraer campos y no prosa. El modelo se elige por plugin, así que el backend no queda atado a un proveedor.
SDK de TypeScript y piezas de interfaz
El SDK de TypeScript convierte las llamadas GraphQL en un cliente encadenable: tomar una colección, filtrar, buscar, elegir campos y generar. Hay proyectos de arranque para Next.js, Nuxt, NestJS y Express, y la capa de interfaz incluye componentes listos para React y Vue. Nada de eso te ata a un servicio alojado, porque el mismo SDK apunta a una instancia local.
Ventajas y desventajas
Ventajas
- Una sola API cubre ingesta, enriquecimiento, vectorización, búsqueda y generación, lo que elimina una pila de servicios sueltos.
- El código es público bajo Apache 2.0, así que puedes leer la implementación, bifurcarla y ejecutarla en tu propio hardware.
- Los conectores de Google Drive, Discord y GitHub reducen la primera demo funcional a una tarde.
- El enriquecimiento ocurre dentro del pipeline, de modo que los resúmenes, las palabras clave y las etiquetas de imagen existen antes de la primera consulta.
- El SDK de TypeScript y los proyectos de arranque rebajan la cantidad de GraphQL que hay que escribir a mano.
Desventajas
- El repositorio está archivado y la aplicación alojada no responde. No hay parches de seguridad, ni correcciones, ni canal de soporte.
- El sitio de documentación ya no resuelve, así que los detalles de instalación salen del código, del README y de entradas antiguas del blog.
- Era software alfa: las API cambiaban entre versiones y algunos plugins quedaron a medias.
- El autoalojamiento exige Docker, Node, un worker de Temporal y una clave de OpenAI, además de paciencia para depurar una pila que nadie mantiene.
Preguntas frecuentes
Unbody era un backend para funciones de IA. Extraía contenido de fuentes como Google Drive y Discord, lo enriquecía con resúmenes y metadatos, guardaba vectores y servía el resultado por una API GraphQL. Los equipos lo usaban para búsqueda semántica, chatbots de documentos y respuestas generadas.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Unbody.
Alternativas a Unbody
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.