
Unreal Speech
Unreal Speech · Voz e idioma
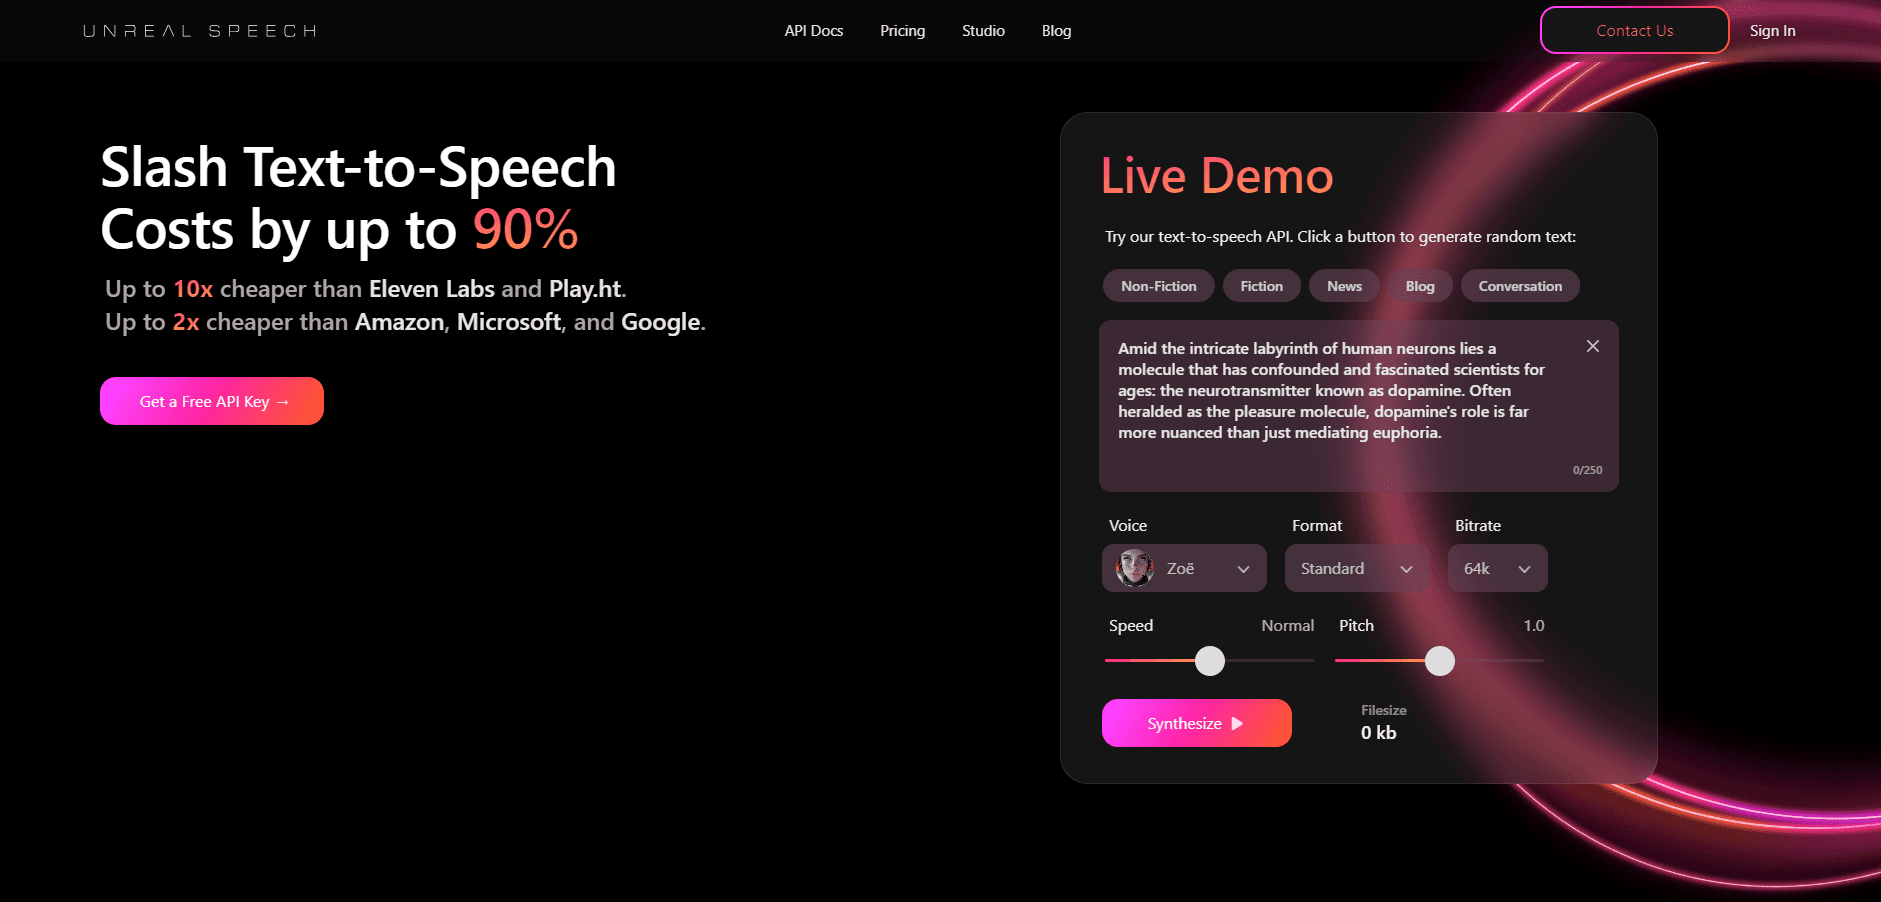
Unreal Speech es una API de texto a voz que convierte texto escrito en voces naturales con IA, entrega el audio en unos 300ms y añade marcas de tiempo por palabra a una fracción del precio de las APIs de voz habituales.
Acerca de Unreal Speech
About
¿Qué es Unreal Speech?
Unreal Speech es una API de texto a voz pensada para quien necesita meter voz en una app sin pagar los precios de la IA de voz de gama alta. Envías texto a un endpoint y recibes audio hablado con una simple llamada REST o una conexión websocket en streaming. La empresa presenta el servicio como una API de síntesis de voz que cuesta unas 11 veces menos que ElevenLabs y mantiene una salida de voz bastante cercana a la humana. Quien compara herramientas de voz suele buscar una alternativa a ElevenLabs más barata, y el precio es justo donde compite esta.
El trabajo principal es generar voz a escala. Además del audio plano, Unreal Speech devuelve marcas de tiempo por palabra que sitúan el inicio y el fin de cada término, que es lo que necesitas para subtítulos, resaltado tipo karaoke y vídeo con texto sincronizado. También asume trabajos largos: una sola petición cubre hasta 10 horas de audio a través del endpoint de tareas asíncronas, así que los audiolibros y la narración larga no se caen por tiempo de espera.
Los límites conviene tenerlos claros. El plan gratis cubre un cupo fijo de caracteres al mes, así que los proyectos en producción pasan a un plan de pago o a una factura por uso. El catálogo de voces es más reducido que el de los grandes proveedores de la nube, y la calidad depende de la voz y el modelo que elijas. También es un producto que vive en la API: no hay un estudio donde editar una narración a mano, así que quien no programa necesita otra herramienta para manejarlo.
Cómo empezar
- Consigue una clave de API gratis en la web de Unreal Speech, sin tarjeta para empezar.
- Envía una petición POST al endpoint /stream o /speech con tu texto, un VoiceId y ajustes como bitrate, velocidad y tono.
- Elige un códec como libmp3lame o pcm_mulaw y ajusta el tono y la velocidad para dar forma a la voz.
- Para textos largos, cambia al endpoint /synthesisTasks y consúltalo hasta que el audio y las marcas de tiempo estén listos.
- Guarda el MP3 que devuelve, o conecta las marcas de tiempo a una capa de subtítulos o de resaltado en tu app.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Unreal Speech.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Desarrolladores de apps y backend
- Estudios pequeños y creadores individuales
- Equipos de contenido que producen audio con regularidad
Tareas
- Generar narración para vídeo
- Convertir documentos largos en audiolibros
- Añadir voz a una app o un bot
Casos de uso
- Lanzar funciones de voz con presupuesto de arranque
- Crear una herramienta de lectura o accesibilidad
- Localizar la narración para llegar a más gente
Funciones clave
Audio en streaming en unos 300ms
El endpoint /stream devuelve el audio rápido, y la empresa indica una respuesta de unos 300ms. Es la vía principal de TTS en streaming, y la que conviene cuando la latencia importa: el audio llega como datos en streaming y no como un archivo que hay que esperar entero. En asistentes, juegos e interfaces en vivo esa diferencia es lo que decide si la conversación se siente fluida o rota.
Marcas de tiempo por palabra
Unreal Speech devuelve datos de tiempo que marcan el inicio y el fin de cada palabra, entregados como JSON junto al audio. Eso sostiene los subtítulos, el resaltado tipo karaoke y el texto que sigue la voz con exactitud. Una ruta websocket más nueva emite audio y marcas a la vez, así que la capa de resaltado se actualiza en tiempo real sin esperar al clip completo.
Síntesis de formato largo hasta 10 horas
El endpoint /synthesisTasks asume trabajos grandes en una sola petición, y la empresa cita soporte de hasta 10 horas de audio. Encaja con audiolibros, cursos largos e informes completos que de otro modo habría que trocear y coser. Envías el texto, consultas la tarea y recoges el audio terminado junto a su archivo de marcas cuando acaba.
Voces naturales con control de velocidad y tono
Cada petición toma un VoiceId y valores de velocidad, tono y bitrate, así que das forma a la entrega sin volver a grabar. El bitrate llega a 320k para una reproducción limpia, y los ajustes de velocidad y tono permiten encajar un personaje o un ritmo concreto. El catálogo se apoya en un conjunto curado de voces con nombre en lugar de cientos de opciones, lo que simplifica la elección pero reduce la variedad.
Códecs y formatos flexibles
La API entrega el audio en códecs como libmp3lame y pcm_mulaw, que cubren la entrega habitual en MP3 y el audio de telefonía de menor ancho de banda. Ajustas la tasa de muestreo y el bitrate según la plataforma destino, así que el mismo servicio sirve para reproducir en web y para flujos de tipo teléfono. Ese abanico te ahorra convertir entre formatos después.
API REST y WebSocket sencilla
El servicio gira en torno a unos pocos endpoints: /stream para clips rápidos, /speech para textos medios con URLs de marcas, /synthesisTasks para trabajos largos y /streamWithTimestamps para audio y tiempo en tiempo real. La autenticación es un token bearer normal, y la documentación muestra ejemplos en Python, Node y cURL. Esa sencillez es la razón de que entre en un prototipo en una tarde.
Ventajas y desventajas
Ventajas
- El precio es lo más llamativo: como opción de TTS económico cuesta varias veces menos que ElevenLabs, algo decisivo cuando un proyecto genera mucho volumen de voz.
- El plan gratis permite probar la API con caracteres reales antes de pagar, así juzgas la calidad de voz con tu propio guion.
- Las marcas de tiempo por palabra vienen con el audio, lo que quita el paso extra de alinear subtítulos o resaltados a mano.
- El endpoint de tareas asume hasta 10 horas de voz en un solo trabajo, así que los audiolibros y los informes largos no necesitan partirse.
- Una ruta websocket en streaming empieza a sonar en unos 300ms y mantiene ágiles las respuestas de voz en tiempo real.
Desventajas
- El catálogo de voces es más corto que el de los grandes proveedores de voz en la nube, así que puede faltar algún acento o idioma concreto.
- La precisión y el ritmo varían según la voz y el modelo, así que conviene probar una muestra antes de dedicar todo un proyecto a una sola elección.
- Es un producto solo de API, sin editor visual, lo que obliga a quien no programa a usar otra herramienta para sacar una narración terminada.
- La calidad en los planes gratis o con descuento está limitada por los caracteres mensuales, así que un uso intenso puede agotar el cupo antes de lo previsto.
Preguntas frecuentes
Unreal Speech es una API de texto a voz y API TTS que convierte texto escrito en voces naturales con IA. Los desarrolladores envían texto a endpoints REST o websocket y reciben audio hablado, con marcas de tiempo por palabra para subtítulos y resaltado. Está pensada para equipos que quieren funciones de voz sin pagar precios de IA de voz premium.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Unreal Speech.
Alternativas a Unreal Speech

Foley
Hanamori Labs, LLC · Voz e idioma · Productividad · Asistente de IAFoley es una lista de tareas por voz que convierte una frase hablada en una tarea archivada, con el proyecto, la fecha y la hora ya puestos, y después te ayuda a organizar el día con lo que ya tienes anotado.

HireKey
HireKey · Voz e idioma · Productividad · AprendizajeHireKey es un copiloto de búsqueda de empleo con IA creado por una reclutadora de tecnología. Mide el encaje con el puesto, adapta el currículum, entrena entrevistas y ordena cada candidatura.

Fluence
Yay Software (Yannick Huchard) · Escritura · Voz e idioma · ProductividadFluence es una app para Android que lee en voz alta PDF, EPUB, archivos de Word y artículos web, sigue la frase que suena y responde preguntas sobre el texto sin salir del teléfono.