
VoiceCanvas
ITUSI · Voz e idioma
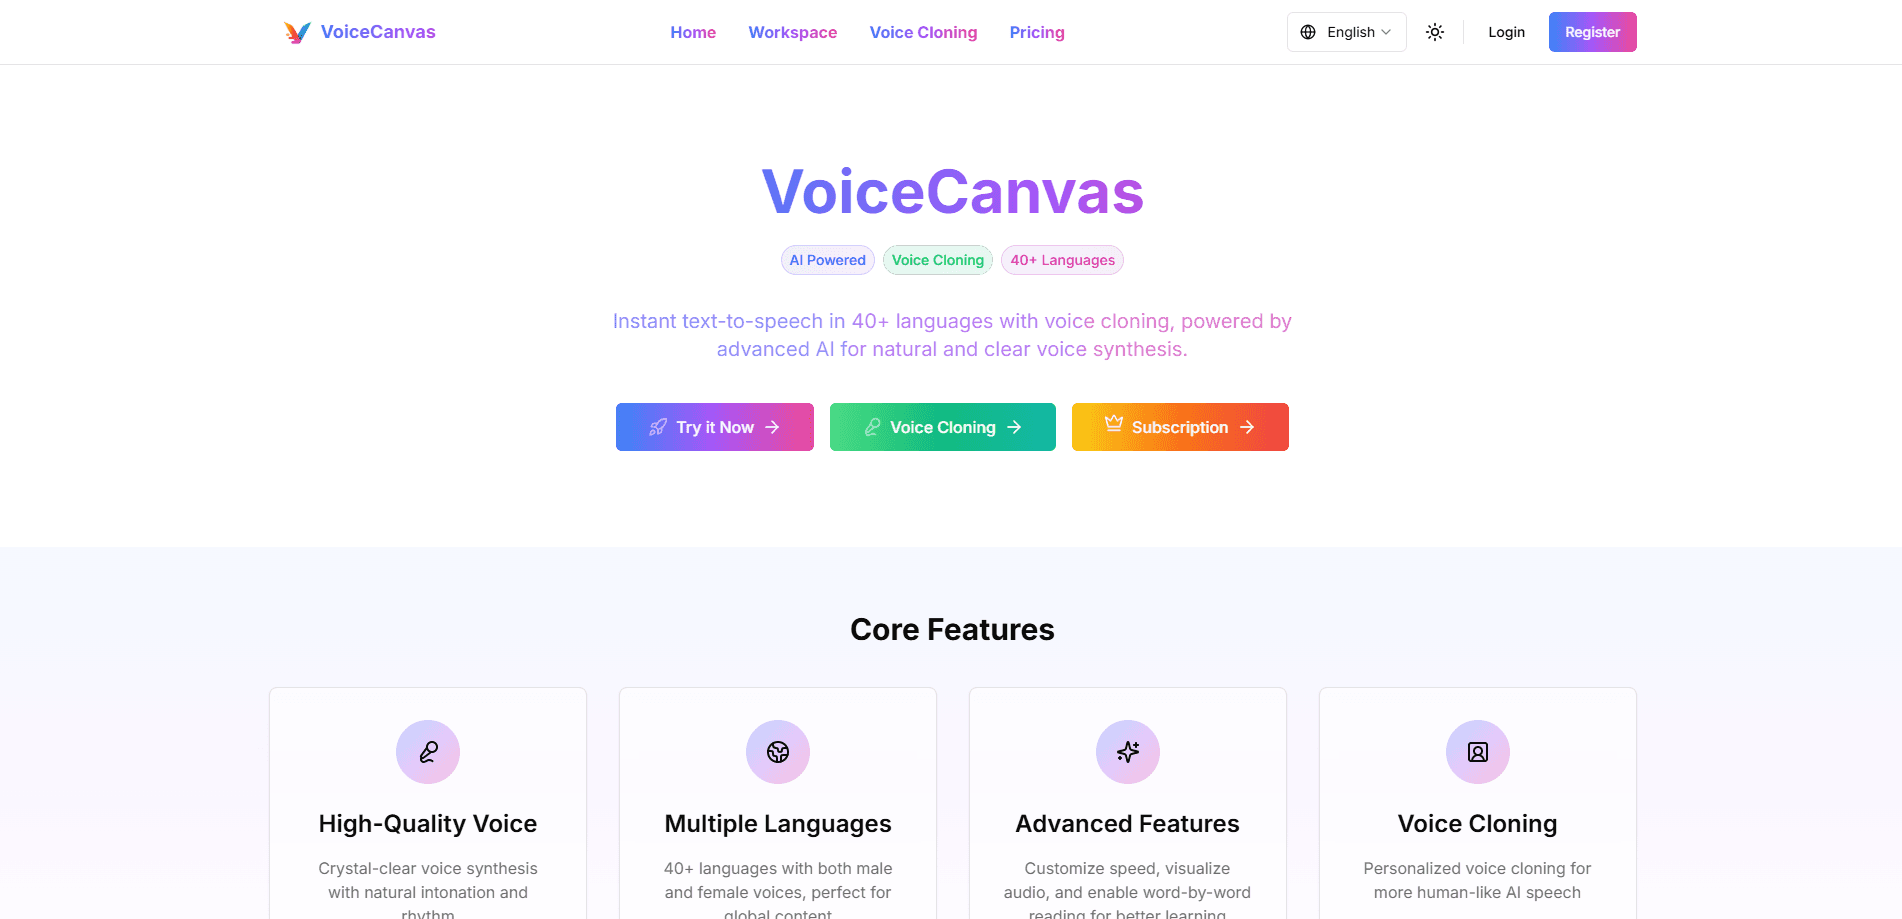
VoiceCanvas es una plataforma de síntesis de voz con IA que convierte texto en habla natural en más de 50 idiomas, con clonación, diseño de voz y herramientas de podcast. Hay prueba gratis de 7 días.
Acerca de VoiceCanvas
About
Qué es VoiceCanvas
VoiceCanvas es una plataforma web para trabajar con voz mediante IA. Escribes o subes un texto, eliges una voz y recibes audio listo para descargar y usar en vídeos, cursos o podcasts. La desarrolla ITUSI y combina varios motores de síntesis, entre ellos OpenAI TTS, AWS Polly y MiniMax.
Lo que la distingue es la amplitud junto con la personalización. Tienes más de 50 idiomas y voces masculinas y femeninas, y además puedes clonar una voz concreta a partir de una muestra corta o diseñar una nueva describiéndola con palabras. Esa mezcla cubre casi cualquier tarea del día a día, desde narrar una lección hasta dar voz a un podcast con dos presentadores.
Conviene conocer los límites de antemano. La clonación necesita audio limpio, y la prueba gratuita se queda en 100 caracteres, así que sirve para probar, no para trabajar en serio. Tampoco hay API pública, de modo que por ahora no puedes montar un flujo automatizado.
Cómo empezar
- Crea una cuenta en voicecanvas.org con tu correo, Google o GitHub.
- Elige un modo: texto a voz, clonación de voz, diseño de voz, podcast o narración de historias.
- Pega o sube tu texto y selecciona idioma, voz y velocidad.
- Escucha la vista previa, ajusta el tono o la velocidad y descarga el archivo cuando te convenza.
El ciclo completo tarda pocos minutos una vez que tienes tu voz lista. La clonación añade un paso: subes una muestra de unos 10 segundos y esperas a que el modelo cree la voz.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de VoiceCanvas.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Creadores de contenido
- Podcasters
- Docentes y formadores
- Productores de audiolibros
Tareas
- Locución para vídeos
- Doblaje multilingüe
- Narración de cuentos para niños
- Crear audio de estudio
Casos de uso
- Convertir una entrada de blog en audio
- Preparar un borrador de podcast
- Armar ejercicios de escucha para clase
- Clonar tu propia voz para contenido recurrente
Funciones clave
Texto a voz en más de 50 idiomas
VoiceCanvas es un motor TTS multilingüe que cubre más de 50 idiomas y dialectos, con voces masculinas y femeninas y acentos regionales como el inglés de EE. UU. y del Reino Unido. Pegas el texto, eliges una voz y obtienes audio con una entonación natural. Este generador de voz con IA es la base de todo lo demás.
Clonación de voz con una muestra corta
Subes unos 10 segundos de audio limpio y la plataforma crea una voz reutilizable que conserva la emoción y el carácter originales. La clonación funciona entre idiomas, así que una sola muestra puede hablar en otras lenguas. El clon queda válido para siempre, algo que encaja con quien quiere una voz estable en todos sus proyectos.
Diseño de voz para tonos a medida
En lugar de clonar una voz existente, describes la que quieres con lenguaje normal y la generas. VoiceCanvas muestra el resultado en tiempo real para que lo escuches antes de guardarlo. Los diseños guardados quedan a mano, lo que ayuda cuando necesitas una misma voz para toda una serie.
Generador de podcast con IA
Le das contenido y la herramienta arma un diálogo de entrevista entre presentador e invitado, que luego lee con voces sintetizadas. Está pensada para quien quiere un podcast con acabado profesional sin grabar a dos personas en directo. El guion hay que revisarlo igualmente, porque la IA escribe la conversación a partir de lo que le pasas.
Narración de historias con IA
Este modo convierte un relato en audio y te deja asignar voces distintas a cada personaje. Eso lo hace útil para cuentos infantiles y audiolibros donde un solo narrador aplanaría el material. Admite texto propio y edición antes de generar.
Control de velocidad y lectura palabra por palabra
Puedes bajar o subir el ritmo, y un modo de lectura palabra por palabra resalta el texto mientras suena. Está pensado para quien aprende idiomas y para quien sigue un guion con atención. También descargas el audio con un clic cuando está listo.
Ventajas y desventajas
Ventajas
- Más de 50 idiomas con voces masculinas y femeninas y acentos regionales, así que una sola plataforma cubre casi cualquier necesidad de localización.
- La clonación parte de unos 10 segundos de muestra y es válida para siempre, lo que mantiene tu voz estable con el tiempo.
- La prueba gratuita y un precio de entrada bajo (3 dólares por un solo clon) dejan probar antes de comprometerte.
- Los modos de podcast y narración resuelven contenido con varias voces que un texto a voz básico no cubre.
Desventajas
- No hay API pública, así que no puedes integrar VoiceCanvas en una app o en un flujo automatizado.
- La prueba gratuita ofrece solo 100 caracteres, apenas para escuchar una muestra.
- La clonación depende de un audio limpio; una muestra corta o con ruido baja la calidad del clon.
- Las cuotas de caracteres de los planes de pago se agotan antes de lo esperado en trabajos largos como los audiolibros.
Preguntas frecuentes
Sirve para convertir texto en audio hablado y para crear voces propias. Los usos habituales son locuciones, doblaje multilingüe, podcasts e historias narradas.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con VoiceCanvas.
Alternativas a VoiceCanvas

Off the Record
Weird Machines · Voz e idioma · ProductividadOff the Record es una app de macOS de Weird Machines que modifica tu voz en tiempo real para bloquear la transcripción con IA: la gente te oye con normalidad y las notas automáticas no obtienen nada aprovechable.
Cekura Bench
Cekura · Voz e idioma · NegociosCekura Bench es un benchmark público que somete a modelos de voz a voz y a agentes desplegados a 82 llamadas simuladas, tres veces cada una, y publica tasas de éxito, latencia y coste por minuto.
Griffin by Tavus
Tavus · Voz e idioma · Vídeo · ChatbotGriffin by Tavus es el primer modelo de interacción humana: un sistema de vídeo a vídeo y dúplex completo que observa, escucha y responde durante una llamada de vídeo con IA en tiempo real.