

Web Bench
Skyvern and Halluminate · Programación · Productividad
Web Bench es un benchmark de agentes de navegación con IA creado por Skyvern y Halluminate que mide su rendimiento en 5.750 tareas repartidas por 452 sitios web.
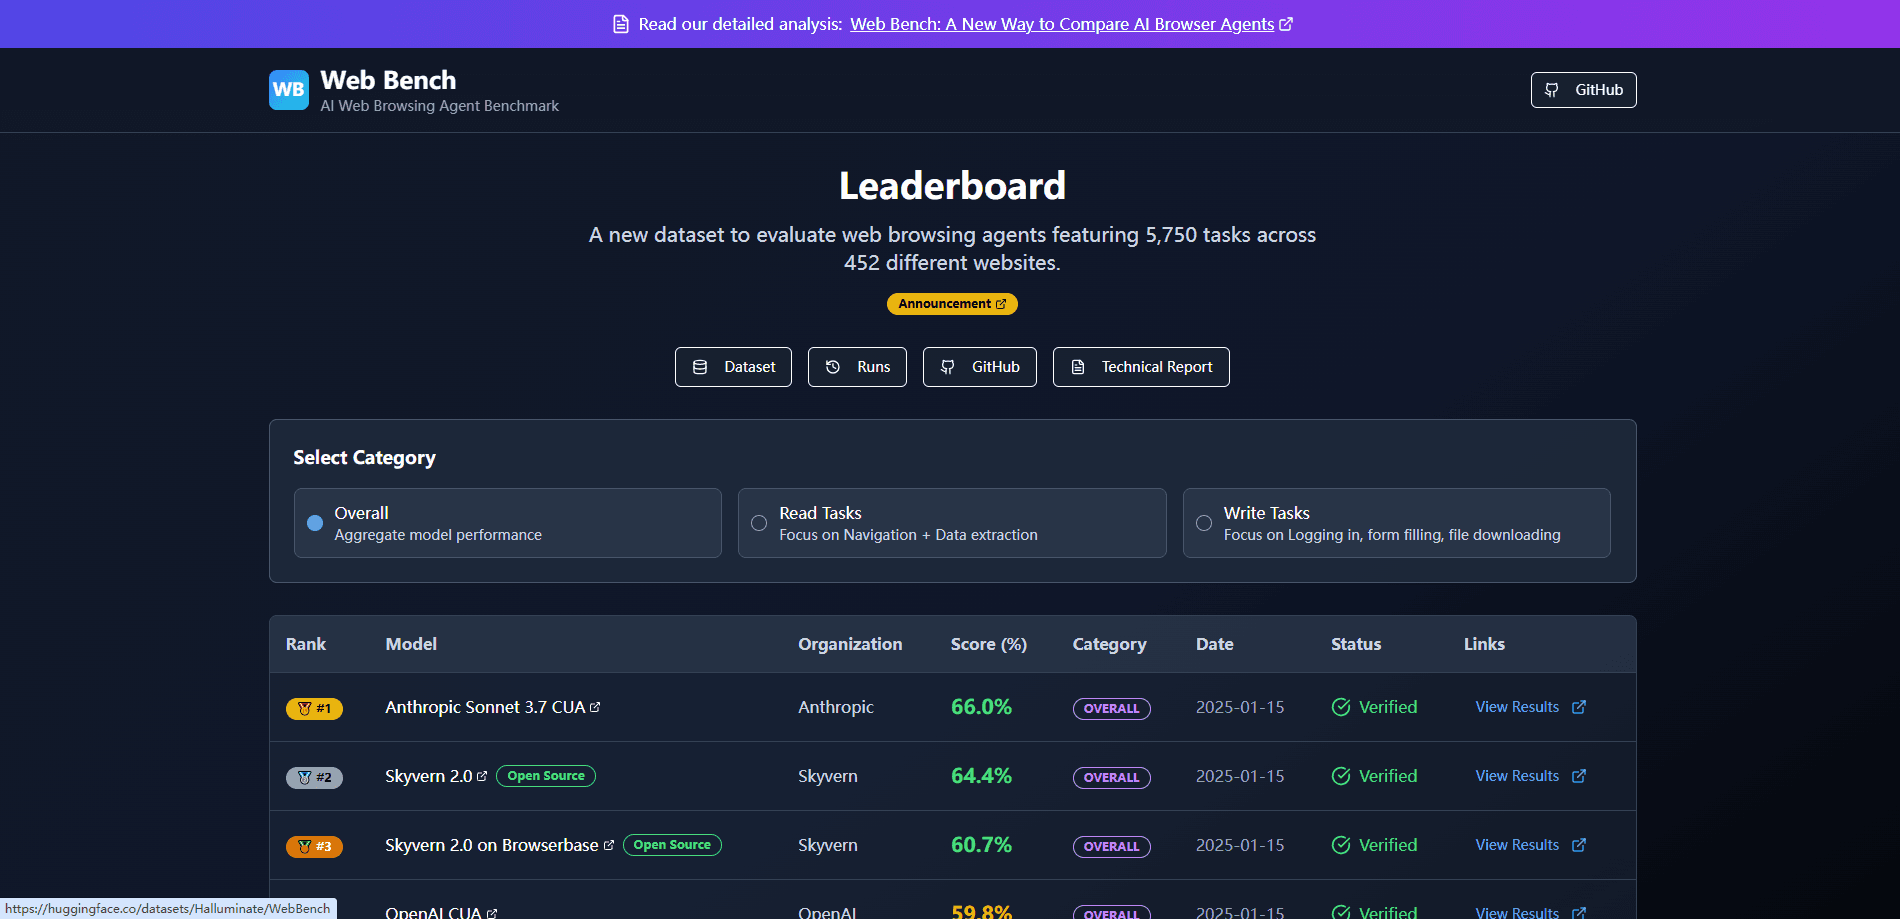
Acerca de Web Bench
What Is Web Bench
Web Bench es un punto de referencia que mide qué tan bien completan los agentes de navegador con IA tareas reales sobre sitios web en vivo. Skyvern y Halluminate lo lanzaron para sustituir a WebVoyager, un set más antiguo que cubría solo 643 tareas en 15 sitios. Hoy los agentes que manejan un navegador hacen solicitudes de empleo, descargan facturas y rellenan formularios fiscales, así que hacía falta un sistema de medición más amplio.
El benchmark divide cada tarea en dos grupos. Las tareas de lectura piden al agente navegar por un sitio y extraer información. Las de escritura le piden iniciar sesión, rellenar un formulario, resolver un código de dos factores o descargar un archivo. Las de escritura apenas aparecían en pruebas anteriores y ahí es donde la mayoría de los agentes se queda corta. Ese diseño lo convierte en una evaluación de agentes de navegador, no en un test de chatbot al uso.
Sus límites son el alcance y la frecuencia. Solo puntúa sitios en inglés del top 1.000 global, una porción pequeña de la web, y los resultados se actualizan únicamente cuando el equipo vuelve a correr el set. Mide precisión, coste y velocidad, no si conviene dejar al agente a solas con tus cuentas.
Getting Started
- Abre la clasificación pública en webbench.ai para comparar agentes por puntuación global, de lectura o de escritura.
- Revisa el conjunto de datos abierto en GitHub o Hugging Face para inspeccionar las tareas exactas y la lista de sitios.
- Lee el informe técnico para entender cómo se puntuó y validó cada ejecución.
- Si desarrollas agentes, contacta con el equipo de Halluminate para enviar tus propios resultados al tablero.
Información del producto
Un vistazo rápido a los precios, las plataformas compatibles y el rendimiento de Web Bench.
Ideal para
Los usuarios, tareas y casos de uso en los que esta herramienta encaja mejor.
Usuarios
- Ingenieros de IA
- Equipos de producto
- Investigadores
Tareas
- Evaluar una versión propia
- Elegir entre agentes
- Detectar puntos débiles
Casos de uso
- Un equipo a punto de desplegar un agente de uso informático que necesita pruebas de que supera inicios de sesión y pagos. Los agentes de uso informático que operan dentro de un navegador obtienen aquí la señal más directa, y la clasificación de agentes web permite ordenarlos por tipo de tarea.
- Una startup que sopesa dos proveedores de automatización de navegador y quiere una vara de medir común.
- Un redactor o analista que cita cifras actuales de precisión de agentes de navegador en un informe.
Funciones clave
Separación entre Tareas de Lectura y Escritura
Web Bench distingue las tareas que extraen datos de las que los modifican. Las de lectura cubren navegación y extracción; las de escritura, inicios de sesión, entradas en formularios, 2FA y descargas. La división importa porque un agente que brilla leyendo suele tropezar con todo lo que altera un sitio.
5.750 Tareas en 452 Sitios Web
El set ejecuta 5.750 tareas en 452 sitios tomados del top 1.000 global por tráfico. La amplitud es lo esencial: los benchmarks previos probaban un puñado de sitios, así que los agentes podían memorizar estructuras. Más sitios significa que los resultados se trasladan mejor a las páginas que realmente usas.
Datos de Tareas Abiertos
Unas 2.454 tareas se publican como datos abiertos en GitHub y Hugging Face. Cualquiera puede revisar las instrucciones, repetir el set o entrenar contra él. Para los equipos que desconfían de las clasificaciones cerradas, esto mantiene la puntuación auditable.
Fallos de Agente e Infraestructura Separados
Cada ejecución fallida lleva una etiqueta de causa. Los errores de agente cubren mala navegación, éxito inventado, tiempos agotados y extracciones erróneas. Los de infraestructura cubren bloqueos de proxy, captchas y detección de bots en el inicio de sesión. La división indica si hay que arreglar el modelo o la pila del navegador.
Métricas de Coste y Velocidad
Más allá de la precisión, Web Bench registra la duración y el número de pasos por tarea. Los pasos marcan el coste de casi todos los agentes, así que las cifras ayudan a estimar lo que gastará un despliegue real. También sirve para ver si encaja un precio por hora o por paso.
Modos Copiloto y Autónomo
El tablero puntúa dos configuraciones. El benchmark autónomo corre los agentes sin ayuda. El de copiloto los corre con una persona supervisando. Comparar ambos muestra cuánto cambia el resultado con alguien dentro del flujo.
Ventajas y desventajas
Ventajas
- Recoge fricciones reales como inicios de sesión, captchas y formularios que los benchmarks previos omitían.
- El conjunto de datos y los registros abiertos dejan que los equipos verifiquen las puntuaciones en vez de fiarse de ellas.
- La separación entre lectura y escritura vuelve los resultados útiles para flujos concretos.
- Incluye pasos y tiempos, así que puedes pesar el coste junto a la precisión.
Desventajas
- Solo cubre sitios en inglés, así que un agente multilingüe no recibe señal aquí.
- Toma muestras del top 1.000, lo que deja sin probar páginas de nicho o regionales.
- Las puntuaciones se refrescan solo cuando el equipo repite el set, así que pueden quedar por detrás de nuevos agentes.
- El techo en tareas de escritura es bajo en general, así que reporta cifras flojas incluso para los mejores agentes actuales.
Preguntas frecuentes
Mide con qué precisión completan los agentes de navegación con IA tareas reales en sitios en vivo, además de cuántos pasos y cuánto tiempo exige cada ejecución. Cada resultado mezcla precisión con señales de coste y velocidad.
Contenido relacionado
Explora herramientas, habilidades y artículos relacionados con Web Bench.
Alternativas a Web Bench
Forefront
Forefront · ProgramaciónForefront es una plataforma web para construir con IA de código abierto. Te deja ajustar los principales modelos de lenguaje de código abierto con tus propios datos, evaluar cómo rinden y ejecutarlos a través de una API o exportarlos para alojarlos tú mismo. Los desarrolladores que quieren la comodidad de una plataforma cerrada pero insisten en ser dueños de sus modelos y sus datos son el público objetivo.

Startkit
StartKit.AI · ProgramaciónStartkit es un boilerplate para crear productos de SaaS con IA y wrappers de IA. Piénsalo como un boilerplate para startups de IA con las partes aburridas ya conectadas: autenticación, pagos con Stripe y Lemon Squeezy, límites de uso, correo transaccional y un kit de inicio de API de IA que habla con OpenAI, Anthropic, Groq o Llama. Clonas el repositorio, pones tu precio y te dedicas a la parte del producto por la que la gente paga de verdad. Está hecho con Next.js sobre React y Tailwind, así que buena parte del código boilerplate ya te resulta familiar.
Testim
Tricentis · ProgramaciónTestim es una plataforma de automatización de pruebas impulsada por IA para crear y ejecutar pruebas de extremo a extremo en aplicaciones web, móviles y Salesforce. Se apoya en el aprendizaje automático para mantener las pruebas estables cuando cambia una interfaz, así que los equipos dedican menos tiempo a reparar selectores rotos. No está nada mal para una herramienta de pruebas automatizadas que puedes empezar a usar hoy mismo. Creas pruebas grabando acciones en un navegador y luego añades JavaScript cuando necesitas más control. Es una opción sólida para equipos de QA con mucho trabajo.