

DeepSeek a mis en ligne le 31 octobre un prototype d'agent de programmation qui ne cherche pas à impressionner par ses scores. Le dépôt, sous licence MIT, sépare une couche qui parle aux humains et des sessions qui font le travail. Son README répète une chose que les gros titres ont laissée de côté : ce n'est pas un produit.
Ce que contient le dépôt dsh-superagent-prototype
Le nom exact est dsh-superagent-prototype. Le projet vient de l'équipe d'outillage de DeepSeek. Cette équipe construit les outils qui entourent les modèles, pas les modèles eux-mêmes. La licence MIT autorise la réutilisation et la modification, y compris commerciales, à condition de garder la mention de copyright.
Le dépôt arrive avec un article d'architecture, « Exploring Super-agent Design: Towards a More Autonomous Agent System ». Les deux documents ne décrivent pas tout à fait la même chose, et le README l'assume : le code publié a été adapté, et certaines idées de l'article restent des directions futures.
La cible est étroite. L'agent se veut proactif, au sens où il prend une demande en charge de bout en bout plutôt que de répondre tour par tour. Il travaille sur un seul dépôt GitHub à la fois. Il se distribue sous forme de bundle, un ensemble prêt à charger dans l'environnement de développement fourni par DeepSeek. Pas de plateforme hébergée, pas de compte à créer chez l'éditeur.
Un routeur qui parle, des workers qui exécutent
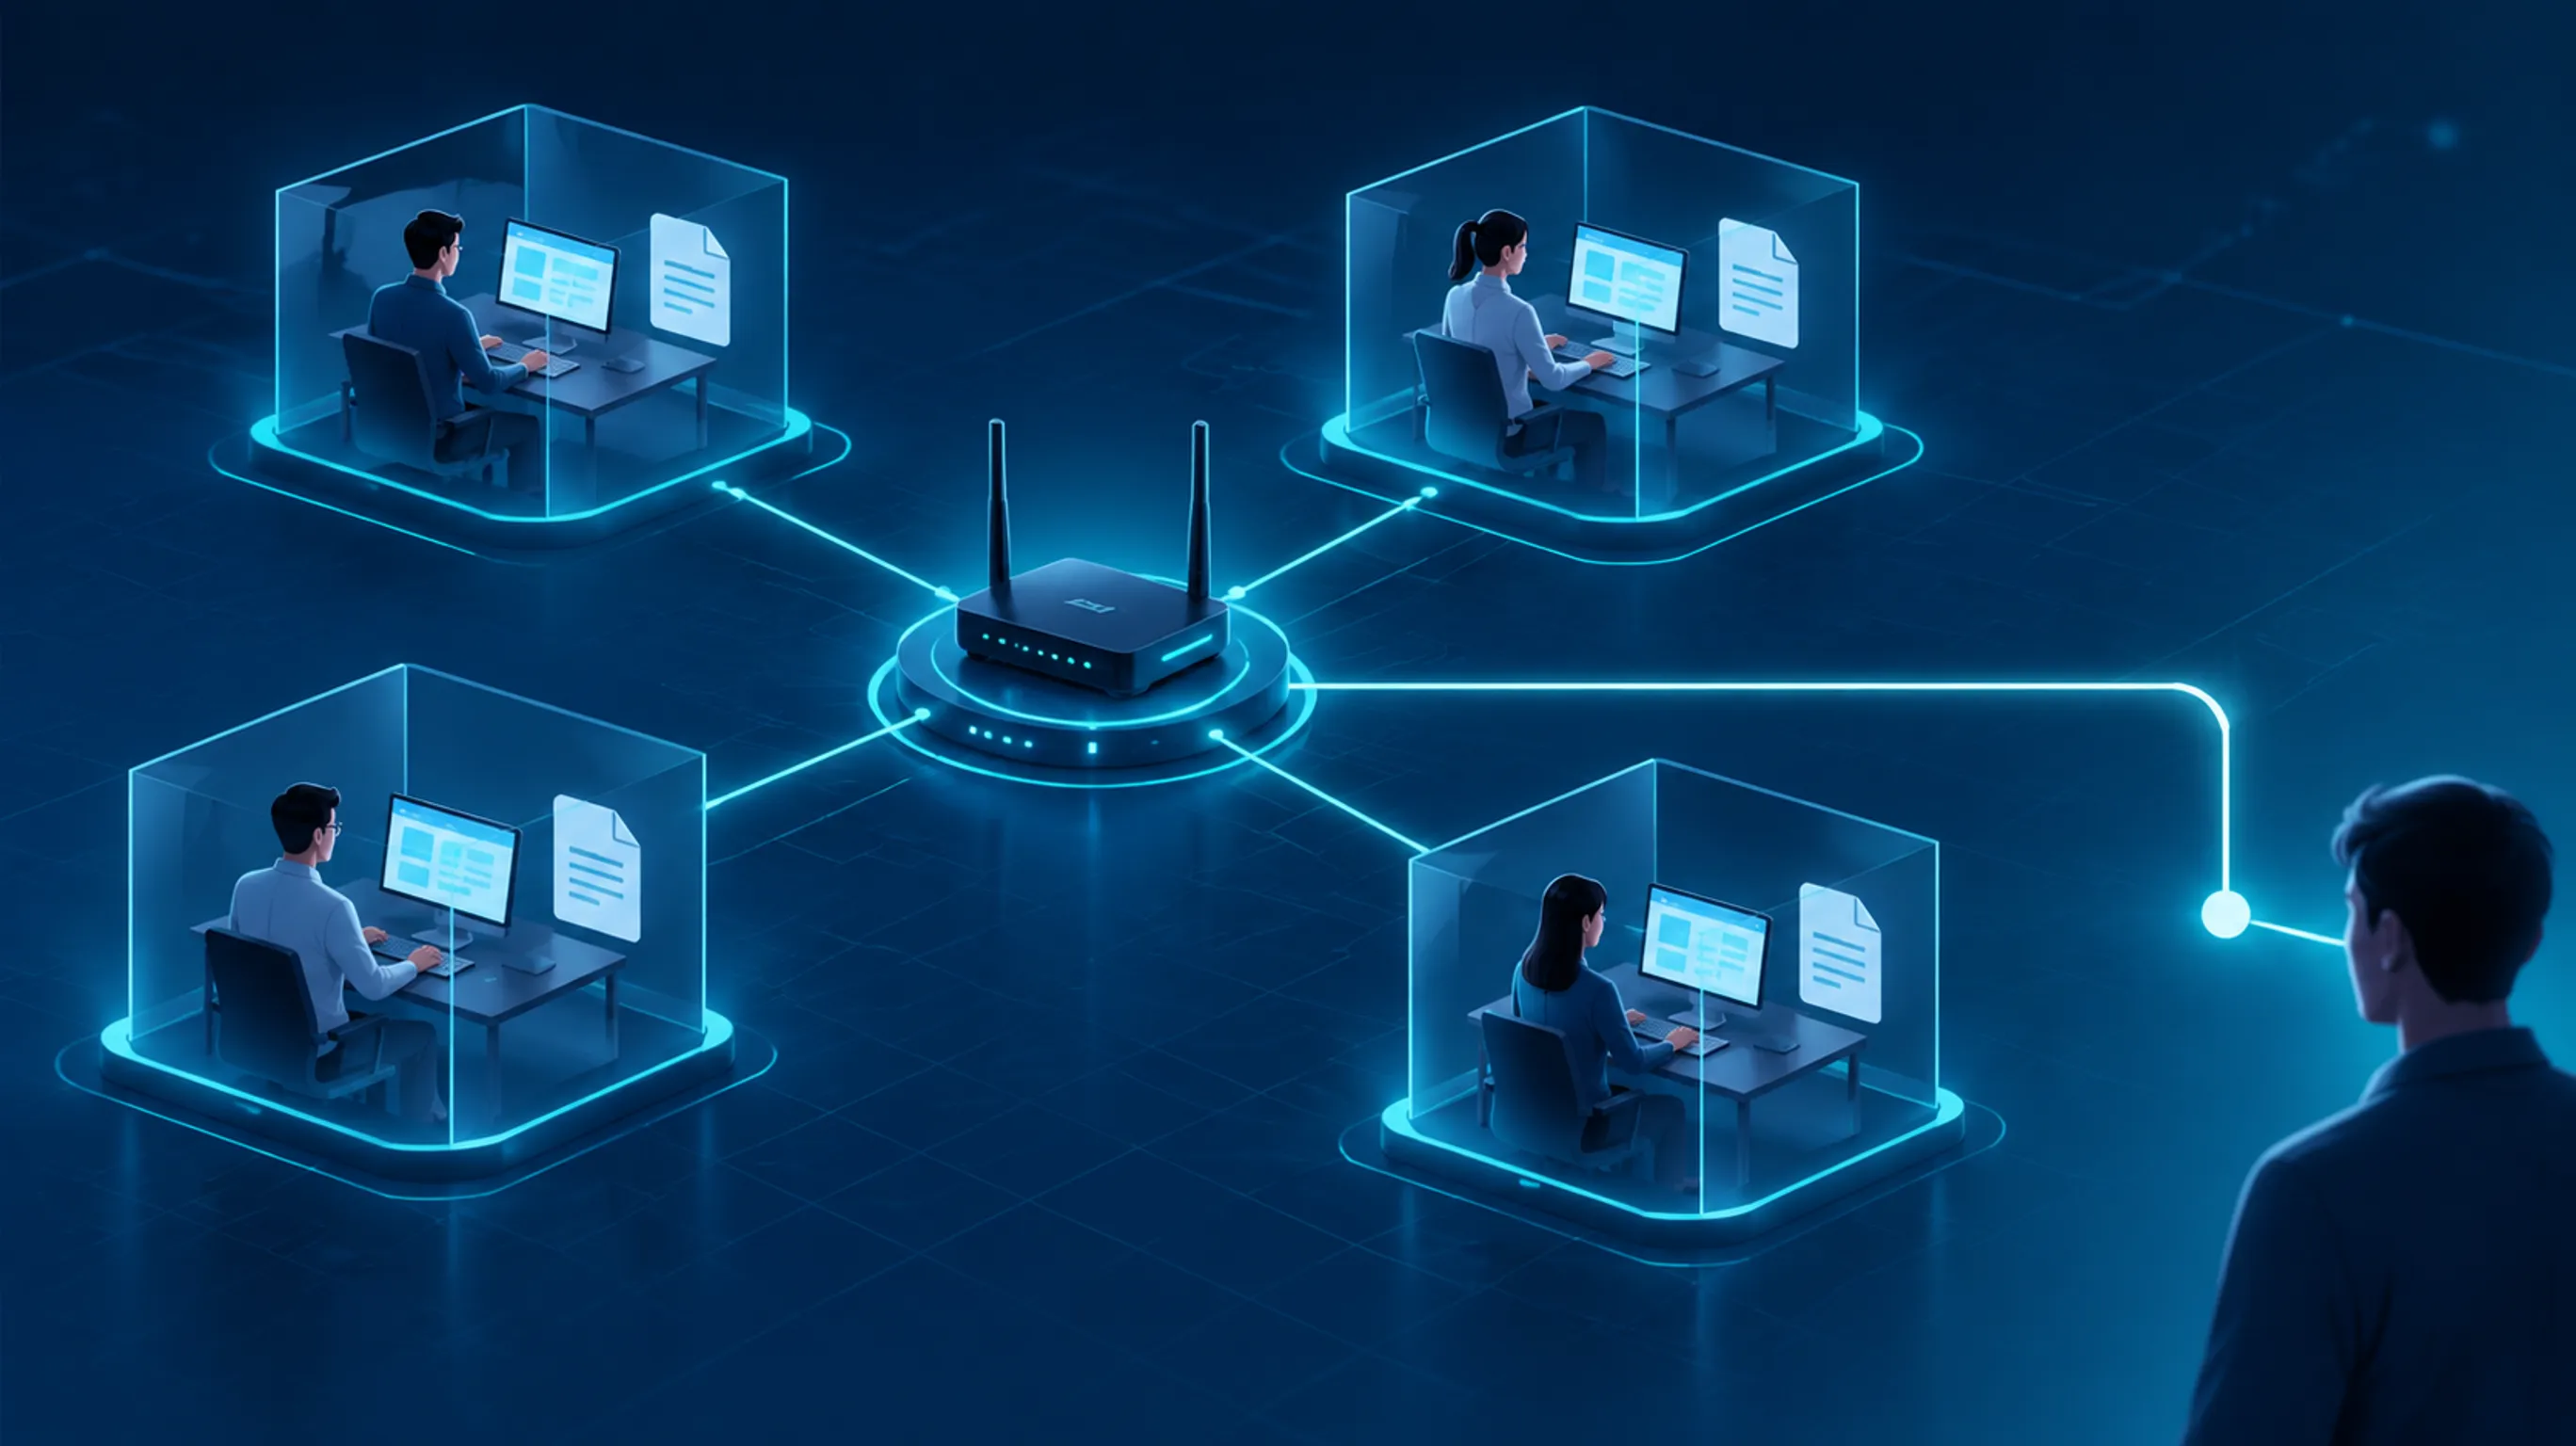
L'architecture tient en deux étages, et c'est là que se joue la différence avec un agent classique. En haut, un routeur permanent. Il répond à l'humain, garde le contexte d'ensemble du projet, décide qui s'occupe de quoi. Il ne code pas.
En bas, des sessions worker isolées. Chacune possède sa propre conversation et son propre répertoire de travail. Elles avancent en parallèle sur des tâches distinctes.
Cette séparation a un effet très concret. Un worker peut se tromper, s'enliser, saturer son contexte, sans contaminer les autres. Le routeur, lui, garde la vue large et arbitre.
Les workers disposent d'un droit supplémentaire, souvent oublié dans les résumés : ils peuvent s'abonner aux commentaires d'une pull request ouverte plus tard. Une revue de code qui tombe trois jours après le lancement de la tâche peut donc encore être lue, comprise et traitée dans la session qui a produit le code.
Le budget d'attention, principe de conception revendiqué
Le README énonce la règle en une phrase : occuper le moins possible l'attention humaine, produire le plus de valeur possible. Le reste du dispositif découle de cette phrase.
Un agent capable d'agir à la place de toute une équipe peut aussi gaspiller l'attention de toute une équipe. Une notification inutile coûte quelques secondes à dix personnes. Le prototype en tire une conséquence stricte : il n'agit que si on le lui demande, ou si les règles écrites par l'équipe l'autorisent.
Même logique pour la parole. Il ne s'adresse à un humain que dans deux cas : quand une décision ne peut pas être prise sans lui, ou quand un résultat est réellement utilisable tel quel.
Le panneau web suit cette idée. Il n'affiche pas des statistiques de productivité, il liste ce qui attend une personne.
Une tâche, du premier message à la pull request
Le déroulé ressemble à celui d'un collègue discret. L'agent écoute les événements GitHub. Il peut aussi se brancher sur Feishu, l'outil de collaboration de ByteDance, en option.
Quand une personne autorisée formule une demande, il crée un élément de travail qu'il exécute dans sa session, avec son propre contexte et son propre répertoire. Puis il revient dans la conversation d'origine pour répondre, le plus souvent avec une pull request à examiner.
Rien n'est publié en douce. Le résultat atterrit là où la demande a été faite, et la décision de fusionner reste humaine.
Un prototype de recherche, avec ses réserves écrites noir sur blanc
C'est la partie que les reprises de la nouvelle ont le plus souvent sautée. Le README qualifie l'objet de prototype de recherche, fourni à titre de référence. Il précise que ce n'est pas un produit officiel de DeepSeek et que ce n'est pas du logiciel de niveau production.
Le texte va plus loin. Il prévient que des bugs existent, que le style de code et les pratiques d'ingénierie peuvent être irréguliers d'un fichier à l'autre. Il indique aussi que le code a été adapté pour une publication publique, et qu'il diffère dans le détail de la version interne comme de l'implémentation décrite dans l'article d'architecture.
Traduction pratique : ne jugez pas DeepSeek sur ce dépôt, et ne comptez pas le déployer tel quel en entreprise.
L'installation passe par votre propre agent
Le dépôt ne fournit pas d'installeur classique. Il fournit un SETUP.md et neuf documents numérotés de 000 à 008, qui couvrent la philosophie, le modèle de domaine, l'autorisation, l'exécution, les prompts, le panneau, le déploiement, l'architecture, et un guide pour ajouter une source de données.
La mise en route est confiée à votre agent de programmation. Il suit le SETUP.md, pose une question courte à la fois, puis présente un plan complet avant d'agir.
Cette méthode a un côté agréable : elle évite le mur de configuration. Elle a aussi un revers. Vous déléguez la lecture des documents à une machine, et vous ne saurez pas forcément ce qui a été installé au final.
Ce que le prototype dit de la concurrence
Dans les heures qui ont suivi la publication, les discussions en anglais et en chinois ont surtout lu le dépôt comme une réponse architecturale à Claude Code et à Codex, deux agents de programmation fermés.
La lecture est plausible. Elle reste une interprétation de la communauté, pas une déclaration de DeepSeek.
Le point intéressant n'est pas un tableau de performances, absent du dépôt, mais le choix de séparer la conversation de l'exécution. La plupart des agents actuels empilent tout dans une session unique qui grossit jusqu'à devenir illisible. Ici, la session qui parle n'est pas celle qui transpire.
Ce qu'il faut regarder avant de cloner
Le dépôt s'adresse à des équipes qui ont déjà un agent de programmation en place et qui veulent tester une autre répartition du travail. Il ne remplace pas un outil grand public, et son README le dit sans détour.
Deux choses valent le détour, même sans installer quoi que ce soit. D'abord les neuf documents, qui décrivent un modèle d'autorisation et un cycle de vie de tâche rarement explicités. Ensuite le principe du budget d'attention, qui donne un critère simple pour juger n'importe quel agent : combien de fois par jour vous interrompt-il pour rien ?
La suite dépendra de ce que la communauté en fera, et de ce que DeepSeek publiera ensuite. Pour l'instant, il s'agit d'un plan de travail lisible, pas d'un produit fini.



