
AgentQL
TinyFish · Programmation
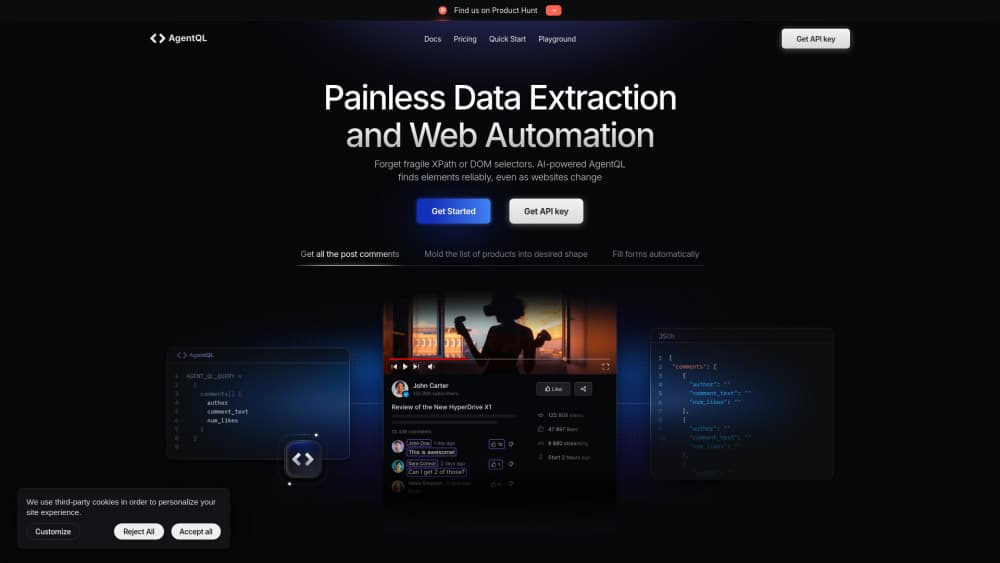
AgentQL est un langage de requête et un analyseur de TinyFish qui repère les éléments d'après leur sens, si bien que vos scrapers et vos agents continuent de tourner quand le HTML change.
À propos de AgentQL
About
Qu'est-ce qu'AgentQL
AgentQL est né pour le scraping web par IA. Son langage de requête associe un analyseur et une couche d'IA pour lire et piloter des pages web. Au lieu d'écrire du XPath ou des sélecteurs CSS, vous décrivez les champs voulus dans une syntaxe proche du langage courant, par exemple products[] { name price }, et le service renvoie du JSON à cette forme. L'IA interprète le contexte autour de chaque élément, donc la requête retrouve la donnée quand une refonte déplace le balisage.
Le produit couvre deux usages. Pour le scraping, query_data renvoie des enregistrements structurés. Pour l'automatisation, query_elements et get_by_prompt fournissent des localisateurs Playwright prêts à cliquer, saisir du texte ou faire défiler la page. TinyFish publie des SDK Python et JavaScript, un point d'accès REST qui se passe du navigateur, une extension Chrome pour mettre au point les requêtes et un serveur MCP pour les frameworks d'agents.
Cette simplicité a un coût: la dépendance à un service hébergé. Chaque requête passe par l'API AgentQL avec votre clé, la facture grimpe à la requête au-delà du forfait gratuit et il vous faut une connexion pendant l'exécution. Les interfaces en canvas, les mises en page inhabituelles et les sites protégés par un antipiratage agressif peuvent encore échouer. Mieux vaut contrôler les résultats en production.
Premiers pas
- Créez un compte sur agentql.com et copiez une clé d'API depuis le portail développeur.
- Installez le SDK avec
pip install agentqlounpm install agentql. - Écrivez une requête listant les champs utiles, avec des types comme
price(integer)quand le format compte. - Appelez
query_datapour extraire des données ouquery_elementspour agir dans un script Playwright. - Testez la requête dans le playground ou l'extension du navigateur avant de la lancer à grande échelle.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de AgentQL.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs Python et JavaScript
- Équipes data et growth sans ingénieur scraping
- Concepteurs d'agents IA
Tâches
- Surveiller prix et catalogues
- Constituer des fichiers de prospection
- Remplir des formulaires et finaliser des achats
- Alimenter un modèle de langage avec des données propres
Cas d'usage
- Une refonte casse votre scraper
- Une requête pour plusieurs sites proches
- Recherche sur des pages protégées par connexion
Fonctionnalités clés
Sélecteurs sémantiques
AgentQL repère les éléments d'après leur sens et le contexte qui les entoure, pas d'après leur position dans le DOM. Un champ nommé product_price trouve le prix même si la classe change de nom ou si le bloc descend dans la page. Les requêtes tiennent donc bon face aux tests A/B et aux évolutions progressives de mise en page, et la même requête sert sur des sites conçus par des équipes différentes.
Le schéma vient de la requête
La requête fait aussi office de contrat de sortie. Imbriquez des objets, marquez les listes entre crochets et ajoutez des indications comme price(integer) ou product_price(include currency symbol) pour cadrer le format. Vous recevez du JSON exactement à la forme écrite, donc l'extraction de données structurées se passe d'une étape de nettoyage.
Intégration Playwright
Les SDK Python et JavaScript enveloppent les pages Playwright et ajoutent les méthodes query_data, query_elements et get_by_prompt. Vous gardez toute l'API du navigateur pour naviguer, capturer un écran ou envoyer un fichier. Les localisateurs renvoyés se comportent comme les autres, donc vos utilitaires de test restent valables.
API REST sans navigateur
Un point d'accès REST renvoie les données d'une URL sans lancer de navigateur. Il convient aux tâches planifiées et aux fonctions serverless où télécharger Chromium n'a pas de sens. Vous envoyez l'URL et la requête, et le résultat arrive en une seule demande.
Débogueur dans le navigateur
Une extension Chrome ouvre un panneau latéral sur n'importe quelle page: vous rédigez la requête et voyez les éléments trouvés surlignés aussitôt. Le cycle entre écriture du sélecteur et vérification raccourcit, ce qui pèse sur les pages mal structurées.
Serveur MCP
Le serveur MCP open source apporte l'extraction AgentQL aux assistants et aux environnements d'agents qui parlent Model Context Protocol. Installez-le avec npx, ajoutez une clé, et l'agent interroge une URL comme un outil de plus. Aucun code de liaison.
Avantages et inconvénients
Avantages
- Les requêtes se lisent comme les données visées, donc un nouvel arrivant les modifie sans maîtriser les sélecteurs.
- La correspondance sémantique réduit la maintenance qui absorbe une bonne part du budget scraping.
- Le forfait Starter gratuit inclut 50 appels par mois, de quoi valider un cas avant de payer.
- Le support de Playwright couvre extraction et interaction dans un même script.
- L'API REST et le serveur MCP répondent aux tâches sans navigateur et aux flux d'agents.
Inconvénients
- Les appels sont facturés: $0.02 par appel en Starter et $0.015 en Professional au-delà du volume inclus, donc crawler 100 000 pages coûte vraiment de l'argent.
- Les heures de navigateur distant sont facturées à part, $0.12 ou $0.10 de l'heure, et les longues sessions d'automatisation web reviennent plus cher qu'elles n'en ont l'air.
- Tout passe par l'API hébergée: pas de mode hors ligne, et une panne du service arrête votre pipeline.
- La correspondance par IA n'est pas déterministe: une mise en page étrange peut renvoyer des champs partiels ou décalés, donc la production exige validation et nouvelles tentatives.
Questions fréquentes
À deux choses: extraire des données de pages web et piloter un navigateur. Les équipes l'emploient pour surveiller des prix, collecter des prospects, remplir des formulaires et fournir des données propres à des agents IA.
Contenus associés
Découvrez des outils, des compétences et des articles liés à AgentQL.
Alternatives à AgentQL

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.