
Appen
Appen Limited · Programmation · Entreprise
Appen est une société de données d'entraînement pour l'IA qui fournit des jeux étiquetés par des humains pour le machine learning, du RLHF à la voix, la vision, la robotique et l'évaluation de modèles.
À propos de Appen
What Is Appen
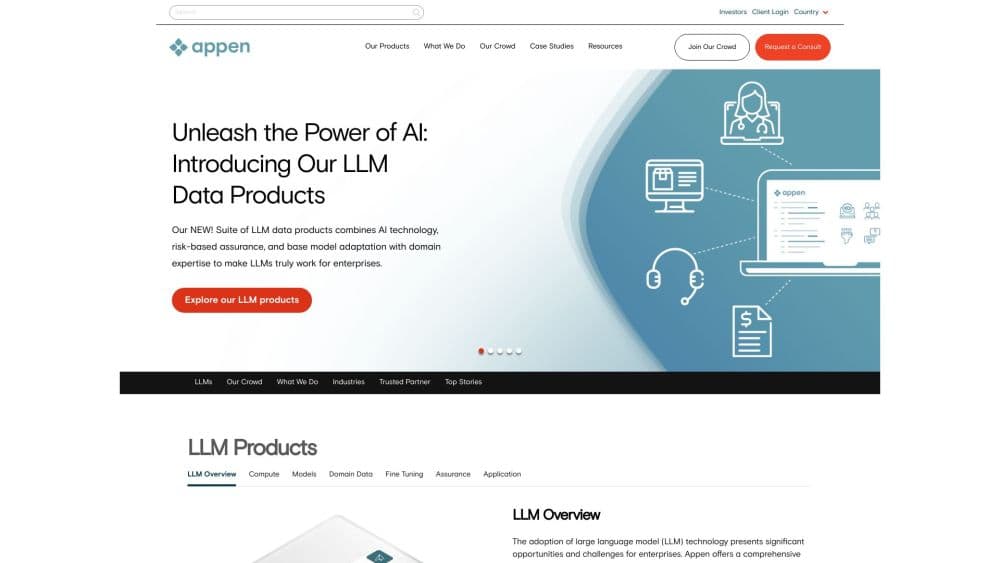
Appen est une société australienne qui collecte et étiquette des données pour les systèmes d'IA depuis 1996. Elle travaille avec les équipes qui construisent de grands modèles de langage, des assistants vocaux, des logiciels de conduite autonome et des outils de vision par ordinateur, et leur livre les données produites par des humains dont ces systèmes apprennent. Plutôt que de vendre une seule application, Appen pilote des projets : vous décrivez ce dont votre modèle a besoin, et Appen recrute des contributeurs, collecte ou annote les données puis vous rend un jeu de données finalisé.
La société a résolu un problème que presque toutes les équipes d'IA rencontrent. Un modèle a besoin d'humains, pas seulement de texte aspiré sur le web, pour saisir la nuance, le contexte et la réalité physique. Appen organise une foule mondiale et un réseau de spécialistes pour faire ce travail à grande échelle, et c'est ce qui pousse les équipes à la choisir comme prestataire de services d'annotation de données. Son catalogue réunit aujourd'hui des centaines de jeux prêts à l'emploi, aux côtés de programmes de collecte sur mesure qui rassemblent des données selon un cahier des charges précis. Le travail récent couvre l'apprentissage par renforcement à partir du retour humain, les trajectoires d'agents d'IA, les nuages de points LiDAR et l'évaluation indépendante de modèles.
La principale limite tient à sa cible : Appen est faite pour les organisations, pas pour les particuliers. Aucune inscription en libre-service côté données, le prix est établi par projet, le catalogue reste derrière un échange commercial et la société ne joue pas le rôle de plateforme de crowdsourcing ouverte pour les acheteurs. Les contributeurs qui cherchent des missions d'annotation rémunérées passent par une plateforme distincte, CrowdGen. Si vous êtes un chercheur individuel ou un amateur, Appen est en général le mauvais choix.
Getting Started
- Rendez-vous sur appen.com et décrivez votre projet à l'équipe commerciale. Précisez le type de modèle, les langues et le volume de données dont vous avez besoin.
- Convenez du périmètre, du format de livraison et du calendrier ; les jeux du catalogue peuvent arriver en quelques jours, alors qu'une collecte sur mesure demande plus de temps.
- Appen recrute et évalue des contributeurs, puis collecte ou annote les données selon le protocole convenu.
- Examinez les échantillons livrés, validez les seuils de qualité et lancez la production complète.
- Recevez le jeu finalisé dans des formats comme WAV, JSONL ou COCO et commencez l'entraînement.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Appen.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes IA et machine learning
- Équipes voix et parole
- Équipes robotique et véhicules autonomes
Tâches
- Entraîner et aligner de grands modèles de langage
- Collecter des jeux de données vocales
- Annoter images et vidéos
- Évaluer des modèles
Cas d'usage
- Lancer un assistant vocal dans une nouvelle langue
- Construire un agent de programmation
- Combler les trous d'un jeu existant
Fonctionnalités clés
Collecte de données sur mesure
Appen monte des jeux selon votre cahier des charges, que vous ayez besoin d'un profil démographique précis, d'un environnement d'enregistrement contrôlé ou d'un domaine que seuls quelques spécialistes maîtrisent. L'équipe conçoit le protocole de collecte, recrute les contributeurs et gère le consentement et les licences tout au long du processus. C'est l'option à retenir quand aucun jeu du catalogue ne correspond à votre cas d'usage.
Catalogue de données prêtes à l'emploi
Le catalogue abrite des centaines de jeux déjà collectés et sous licence, dans des catégories comme la voix, le code et les tâches d'apprentissage par renforcement. Chacun s'accompagne d'une fiche technique détaillant la source, la méthode d'annotation et les limites connues, ce qui permet aux juristes et aux responsables conformité de vérifier la provenance. Vous licenciez un jeu et l'utilisez en quelques jours, sans commander une nouvelle collecte.
RLHF et alignement de modèles
Appen réalise le travail de retour humain qui apprend au modèle quelles réponses sont les meilleures. Cela comprend l'entraînement de modèles de récompense, des démonstrations supervisées et les traces de raisonnement qui améliorent la façon dont un modèle s'explique. Les équipes s'en servent pour régler le ton, la sécurité et la précision avant qu'un modèle ne soit public. C'est l'un des chantiers les plus actifs de la société.
Voix et IA multimodale
Pour les systèmes qui écoutent et parlent, Appen collecte des corpus vocaux multilingues et mène l'annotation de synthèse vocale et l'évaluation d'agents vocaux. Côté visuel, elle prend en charge l'annotation en vision par ordinateur sur les images et les vidéos, et ses équipes marquent aussi la reconnaissance d'actions et les nuages de points pour la robotique et la conduite autonome. La couverture dépasse 500 localités, ce qui compte quand un produit doit fonctionner hors de l'anglais.
Évaluation et intégrité des modèles
Au-delà de la collecte, Appen mène des évaluations indépendantes : benchmarks d'hallucination, détection de biais et audits réglementaires. L'objectif est de fournir aux équipes une preuve externe de la fiabilité d'un modèle, pas seulement leurs propres résultats de test. Cela convient aux entreprises qui affrontent des revues de conformité ou préparent un lancement que les régulateurs examineront de près.
Services de recherche
Appen propose un appui à la recherche : ingénierie de contexte, génération de données synthétiques et benchmarks sur mesure avec des dispositifs LLM-as-a-judge. Le service vise les équipes qui ont déjà un modèle fonctionnel mais manquent de bras pour faire avancer un projet. Il s'appuie sur le même réseau de contributeurs que la collecte de données, si bien que les résultats reviennent sous forme de livrable structuré et vérifiable.
Avantages et inconvénients
Avantages
- Couvre toute la chaîne de la donnée, de la collecte et de l'annotation à l'évaluation, au sein d'un seul service géré.
- Une expérience éprouvée sur trois décennies, y compris le travail de RLHF qui a façonné les premiers modèles conversationnels.
- Le réseau mondial de contributeurs couvre plus de 500 localités, ce qui évite de monter une équipe linguistique pour chaque nouveau marché.
- Les standards sont documentés : SOC 2 Type II, ISO 27001, traitement RGPD et CCPA, plus les formalités du règlement européen sur l'IA.
- Les jeux du catalogue arrivent avec des registres de provenance que les juristes peuvent consulter.
Inconvénients
- Il n'existe pas de produit de données en libre-service, donc les particuliers et les petites équipes ne peuvent pas s'inscrire et démarrer seuls.
- Le prix est établi par projet, ce qui rend le budget difficile à prévoir avant un échange commercial.
- Le catalogue de données reste derrière un processus commercial, donc vous ne voyez pas les fiches complètes sans contacter Appen.
- La livraison dépend de la disponibilité des contributeurs d'Appen, ce qui peut allonger les délais pour des langues ou des profils démographiques rares.
Questions fréquentes
Appen collecte, étiquette et évalue les données sur lesquelles s'entraînent les modèles d'IA. Cela couvre le retour humain pour les chatbots, les enregistrements vocaux pour les assistants, l'annotation d'images et de capteurs pour la vision par ordinateur, et des tests indépendants de modèles.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Appen.
Alternatives à Appen

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.