
Avaturn Live
Avaturn · Image · Voix et langage
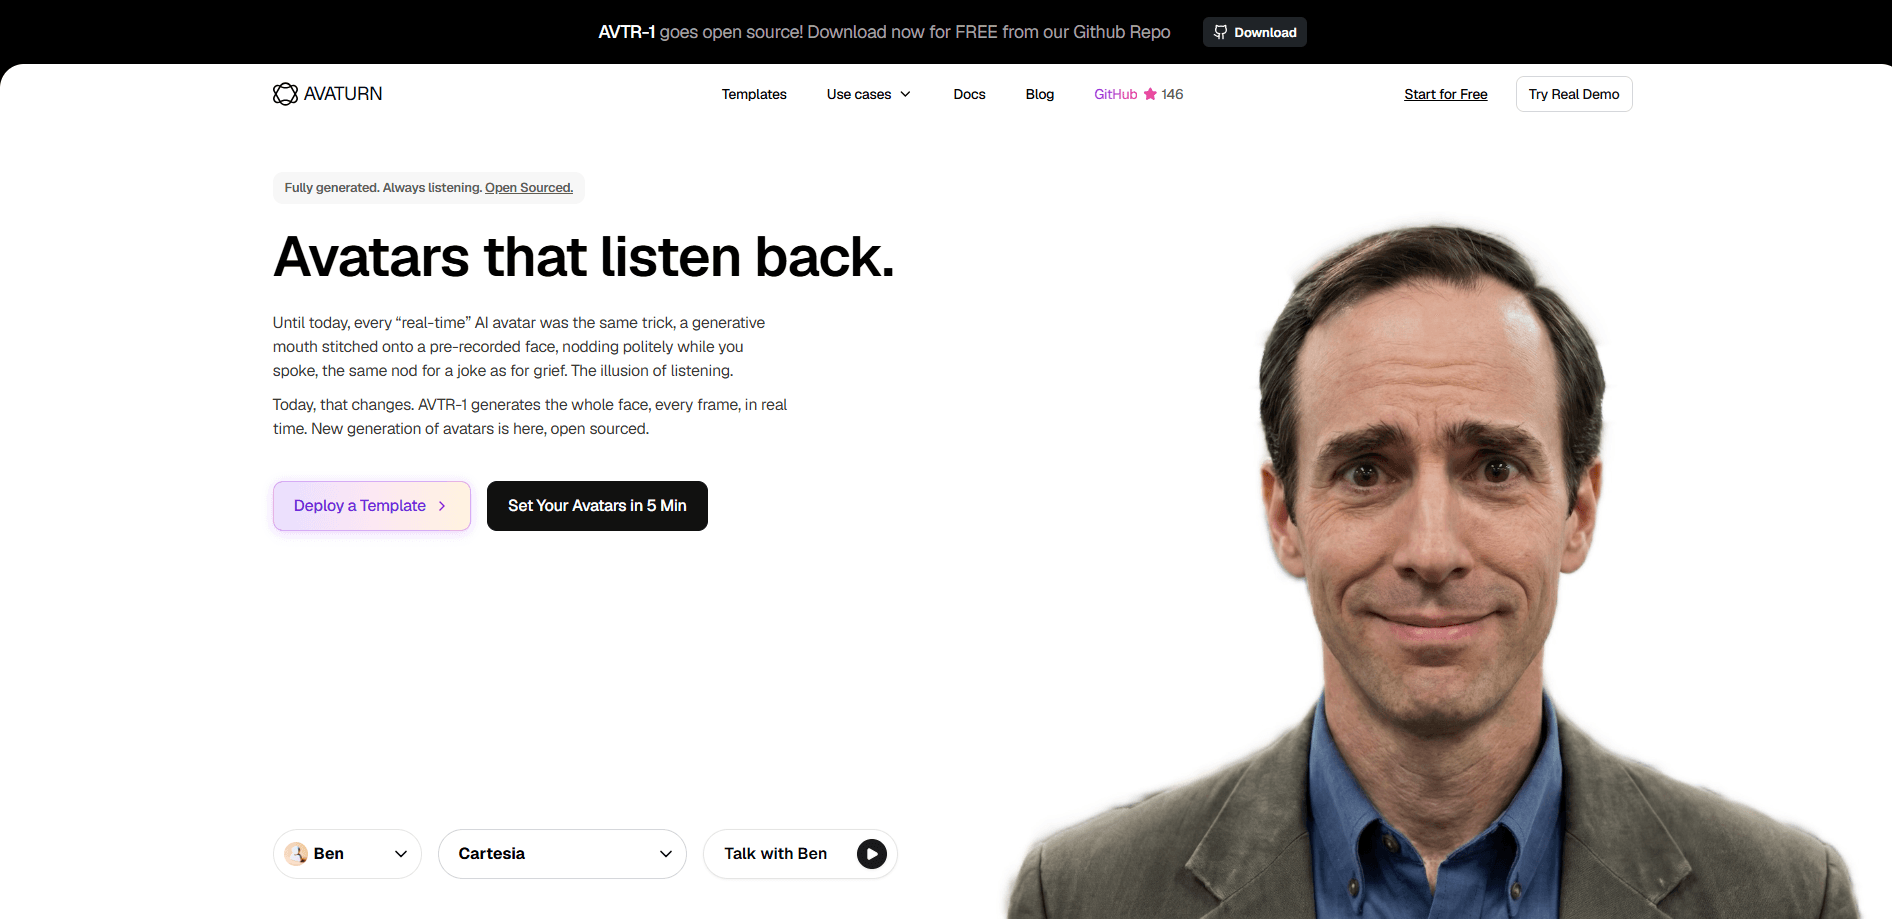
Avaturn Live est une plateforme d'avatars IA en temps réel qui transforme une seule image de portrait en un visage entièrement animé pour des conversations en direct. Alors pourquoi paraît-il moins troublant qu'un générateur d'avatar parlant classique ? Parce qu'il affiche chaque image du visage, pas seulement la bouche. Le personnage cligne des yeux, réagit et montre des émotions pendant que l'autre personne parle. Vous obtenez aussi des démos prêtes à l'emploi, des modèles et un SDK/API pour intégrer des avatars IA conversationnels dans des applications vocales en quelques minutes.
À propos de Avaturn Live
Qu'est-ce qu'Avaturn Live
Avaturn Live est une plateforme pour créer des avatars IA réalistes qui tiennent leur bout dans une conversation vocale en direct. Son modèle principal, AVTR-1, produit un visage synchronisé à 25 images par seconde sur un seul GPU, et il fait bien plus que bouger la bouche. Tout le visage s'anime image par image, et c'est pour cela que la société dit que ces avatars « écoutent en retour » plutôt que de simplement parler.
Le problème qu'il résout est celui que finit par rencontrer toute personne qui construit un agent vocal. Un chatbot doté d'une voix de synthèse sonne bien jusqu'au moment où on lui ajoute un visage, et là le visage le trahit. Les outils traditionnels de tête parlante ne font que relier l'audio aux lèvres, donc l'avatar fixe le vide dès que l'utilisateur parle. Avaturn Live garde le personnage en train de réagir pendant l'autre moitié de l'échange, ce qui compte pour le tutorat, les simulations de vente et le support client, où le silence ressemble à de la confusion.
La principale limite, c'est le matériel. Faire tourner le modèle soi-même demande un GPU NVIDIA correct, CUDA 12.x et TensorRT 10.x, donc l'auto-hébergement n'est pas un projet de week-end sur un ordinateur portable. Pour la plupart des équipes, l'API hébergée ou les modèles prêts à l'emploi sont le point de départ réaliste. Au moment d'écrire ces lignes, je n'ai pas trouvé de tarifs d'API publiés sur le site, alors considérez toute estimation de coût comme non vérifiée tant que vous n'avez pas demandé directement au fournisseur.
Pour démarrer
- Ouvrez le tableau de bord et configurez un avatar en cinq minutes environ grâce au flux d'import de la société.
- Choisissez un modèle ou partez d'une démo, et vous évitez de construire la logique de session à partir de zéro.
- Sélectionnez ou importez une image de portrait, puis branchez vos flux audio de parole et d'écoute.
- Testez la session en direct dans le navigateur. Vérifiez la synchronisation labiale et le délai de réaction sur votre connexion.
- Pour la production, connectez-vous via le SDK ou l'API, ou clonez le dépôt AVTR-1 et hébergez-le sur votre propre GPU.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Avaturn Live.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui créent des agents vocaux
- Équipes de vente et de support
- Enseignants et professeurs de langue
Tâches
- Simulation en direct pour les appels de vente
- Pratique des langues avec retour sur la prononciation
- Agents de support client
Cas d'usage
- Prototyper un produit IA en un après-midi
- Auto-héberger un modèle privé
- Démos dans le navigateur pour les clients
Fonctionnalités clés
Animation faciale image par image
La plupart des outils d'avatar ne bougent que les lèvres, et c'est pour cela qu'ils paraissent étranges. Avaturn Live affiche tout le visage à chaque image, donc l'avatar cligne des yeux, change d'expression et réagit à la personne qui parle. C'est la différence entre une tête parlante et un personnage qui semble présent dans la pièce.
Écoute active et réaction émotionnelle
Le modèle reçoit un flux audio à double canal, un pour la parole et un pour l'interlocuteur. Puis il réagit aux deux. Il ne se tait pas pendant que l'autre parle. Pour le tutorat, la vente ou le support, cette réaction évite qu'une conversation donne l'impression de parler à une vidéo en pause.
25 images par seconde sur un seul GPU
AVTR-1 génère le mouvement par blocs de cinq images à 25 fps. Cela équivaut à 200 ms de sortie par bloc. Tout GPU assez rapide pour rester sous cette barre tourne en temps réel. D'après les chiffres publiés par Avaturn, une L40 traite un bloc en 84 ms, une RTX 4060 Ti en 166 ms, et une L4 tout juste en 202. Dépasser la limite de sa carte signifie des images perdues. Cela ne plante pas.
Modèle open source avec auto-hébergement
AVTR-1 est open source, avec les poids, le code d'inférence et des builds accélérés par TensorRT sur GitHub. Les équipes aux règles de données strictes peuvent récupérer le modèle et le faire tourner derrière leur propre pare-feu. Le revers de la médaille, c'est le travail de configuration : CUDA 12.x, TensorRT 10.x et des moteurs compilés pour chaque machine.
Modèles et démos prêtes à l'emploi
La plateforme est livrée avec des exemples fonctionnels, dont un agent de simulation de vente, un tuteur de langue et une personnalité d'analyste de données. Chacun arrive sous forme de démo en direct et de modèle déployable. Pour une petite équipe, c'est le chemin le plus rapide entre « nous voulons des avatars » et quelque chose qu'un décideur peut cliquer.
Intégration par SDK et API
Vous pouvez ajouter des avatars à une application vocale existante via un SDK ou une API d'avatar, ou via un backend entièrement auto-hébergé. Pas besoin de construire le pipeline de rendu vous-même. Le backend de session en direct gère le streaming. Votre application envoie seulement l'audio et affiche la vidéo.
Avantages et inconvénients
Avantages
- Affiche tout le visage à chaque image, donc les avatars réagissent pendant les pauses au lieu de se figer en image fixe.
- Atteint 25 fps sur un seul GPU, avec des chiffres de latence publiés pour des cartes courantes comme la L40 et la RTX 4060 Ti.
- Modèle AVTR-1 open source, donc l'auto-hébergement derrière un pare-feu est une option réelle.
- Les modèles et les démos réduisent le temps entre l'idée et un prototype cliquable.
Inconvénients
- L'auto-hébergement exige un GPU NVIDIA ainsi que CUDA 12.x et TensorRT 10.x, et les moteurs doivent être recompilés sur chaque machine. Cela exclut les installations rapides sur ordinateur portable.
- Les tarifs ne sont pas publiés sur le site, donc vous ne pouvez pas budgéter à partir de la page de l'API seule et devez demander au fournisseur.
- Les petits GPU comme la L4 se situent juste sur la ligne du temps réel, donc la marge pour des scènes plus lourdes est mince.
Questions fréquentes
C'est une plateforme d'avatars IA en temps réel qui animent un visage complet pendant des conversations vocales en direct, pas seulement la synchronisation labiale. Son modèle AVTR-1 alimente à la fois le produit hébergé et une version auto-hébergée.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Avaturn Live.
Alternatives à Avaturn Live

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

Tractionwave
TractionWave · Image · MarketingTractionWave produit une carte de chaleur d'attention par IA pour les annonces statiques. Vous déposez un PNG ou un JPG, et vous obtenez l'attention prévue, des points chauds classés et des corrections avant de dépenser.

Imejis.io
Imejis.io · Image · MarketingImejis.io est un studio de design IA pour les agents et les équipes marketing. Vous décrivez une image avec vos mots, l'outil écrit le texte, construit la mise en page, l'adapte à chaque format et exporte le fichier final.