
Awan LLM
Awan LLM · Programmation · Autres
Awan LLM est une API par abonnement pour modèles Llama qui facture un forfait mensuel fixe au lieu du token, avec un endpoint au format OpenAI et des plans de la gratuité à 80 $/mois.
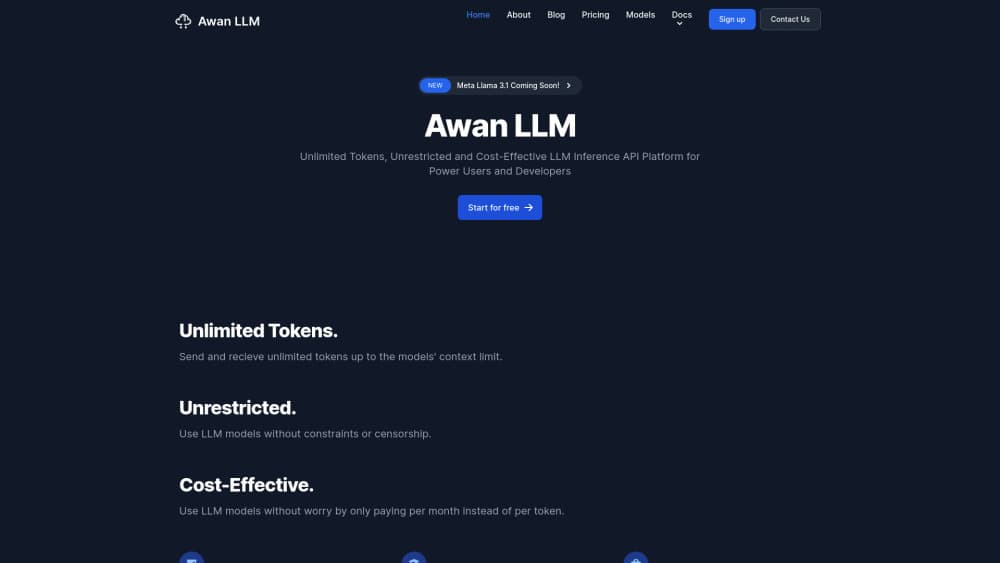
À propos de Awan LLM
About
Qu'est-ce qu'Awan LLM
Awan LLM est une API de LLM à tokens illimités, autrement dit une API d'inférence qui loue l'accès à des modèles Llama ouverts au mois, et non au token. Vous créez un compte, générez une clé et envoyez vos requêtes à un endpoint de chat completions construit comme celui d'OpenAI. La facture ne bouge pas, que vous consommiez mille tokens ou cent millions.
Le matériel appartient à l'entreprise. Awan affirme posséder ses GPU et ses centres de données, les overclocker et répartir la charge entre eux, et c'est cette maîtrise qui rend crédible la promesse de tokens illimités entre 5 et 80 dollars par mois. Le nom vient du mot indonésien désignant le nuage, et le discours vise ceux dont la facture de tokens a dépassé le budget du projet.
Deux limites disent si l'offre vous concerne. Le catalogue public se limite à Llama 3 et Llama 3.1 en 8B et 70B, avec des ajustements de la communauté, sans GPT, Claude, Gemini ni Mistral. Et les requêtes sont plafonnées à la minute et à la journée selon le plan et la taille du modèle : tokens illimités ne veut pas dire requêtes illimitées.
Pour démarrer
- Ouvrez un compte sur awanllm.com et choisissez un plan. Lite est gratuit et ne demande pas de carte, de quoi vérifier que l'endpoint répond comme votre code l'attend.
- Générez une clé d'API dans le tableau de bord et rangez-la là où votre application peut la lire.
- Envoyez votre première requête à https://api.awanllm.com/v1/chat/completions avec le nom du modèle et le tableau de messages, en partant de l'exemple Python, TypeScript ou shell de la page Quick Start.
- Surveillez les plafonds. Si le quota journalier des grands modèles saute, basculez la tâche sur un modèle plus petit ou attendez la remise à zéro.
- Passez à un plan payant quand ce sont les requêtes qui bloquent, pas les tokens.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Awan LLM.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Amateurs de longues conversations avec un assistant
- Développeurs indépendants au budget serré
- Auteurs et joueurs de rôle cherchant des modèles ajustés
- Équipes qui traitent beaucoup de texte à coût fixe
Tâches
- Traitement de texte en volume
- Rédaction de documents longs
- Backends de chatbot et d'agent
- Écriture créative sans censure
Cas d'usage
- Un projet personnel qui reçoit soudain du trafic
- Tester une bibliothèque de prompts
- Outils de développement branchés sur un modèle distant
Fonctionnalités clés
Tokens illimités sur un forfait mensuel
Chaque plan, y compris le gratuit, annonce une génération de tokens sans limite dans la fenêtre de contexte du modèle. Vous payez l'abonnement, pas l'entrée ni la sortie, donc un prompt interminable ou une réponse de mille lignes ne coûte rien de plus. Le calcul s'inverse : plus vous consommez, plus l'offre devient intéressante, et un mois chargé ne réserve aucune surprise.
Chat completions au format OpenAI
Cette API compatible OpenAI reprend le même chemin : les appels partent vers https://api.awanllm.com/v1/chat/completions avec les mêmes champs model et messages qu'OpenAI, plus des réglages d'échantillonnage comme top_k et repetition_penalty. La page Quick Start donne des exemples en Python, TypeScript et shell, de quoi faire fonctionner la plupart des SDK OpenAI après avoir changé l'URL de base et la clé. Le streaming est pris en charge, ce qui compte dans une interface de chat où attendre la réponse complète donne l'impression d'une panne.
Des plafonds séparés par taille de modèle
Plutôt qu'un quota global, Awan découpe ses limites en classes petit, moyen et grand modèle, avec pour chaque plan une allowance à la minute et une à la journée. Lite autorise 200 requêtes par jour vers les petits modèles et 10 vers les grands ; Pro monte à 80 000 et 30 000 ; Max supprime le plafond journalier et ajoute les requêtes en parallèle. Le plafond à la minute va de 20 sur les plans d'entrée à 200 sur Max.
Llama 3.1 et son contexte long
Les modèles mis en avant de l'API Llama 3.1 sont Meta-Llama-3.1-8B-Instruct et Meta-Llama-3.1-70B-Instruct, tous deux annoncés avec 131 072 tokens de contexte. Le 70B prend le raisonnement et la rédaction les plus difficiles, tandis que les 8B répondent plus vite et consomment moins de votre quota de requêtes. Awan publie un débit estimé par modèle : environ 50 tokens par seconde en requête isolée sur le 8B, 20 sur le 70B.
Des ajustements communautaires pour la fiction
Au-delà des poids d'origine de Meta, le catalogue liste des versions maison du Llama 3 8B. Dolfin suit les consignes à la lettre avec moins de refus, Cumulus est taillé pour la narration et le jeu de rôle sans refus, et une build abliterated d'Instruct les accompagne. Ce sont des outils de niche, mais en fiction et sur un personnage, le comportement n'a rien à voir avec un assistant filtré : voilà les modèles Llama sans censure de la maison.
Aucun journal des prompts
Awan indique dans sa politique de confidentialité ne pas conserver les prompts ni les générations, et répète la promesse sur sa page d'accueil. Pour qui envoie des documents clients, des brouillons inédits ou des conversations personnelles par une API, cette politique pèse souvent dans la décision. Prenez-la comme une déclaration de l'éditeur et non comme une garantie auditée : sur des données réglementées, faites vérifier les conditions.
Avantages et inconvénients
Avantages
- Les tokens illimités retirent le comptage des tokens du code et du budget.
- Le plan Lite gratuit est un vrai palier, pas un essai, et ne demande aucun moyen de paiement.
- Les requêtes suivent le format chat d'OpenAI, donc les SDK et frameworks d'agents passent avec un changement d'URL de base.
- Les 131 072 tokens de contexte des Llama 3.1 règlent un document long en une seule requête.
- Le plan le plus cher reste à 80 $ par mois, peu pour qui déplace vraiment du volume.
Inconvénients
- Le catalogue ne contient que des Llama, et les versions listées sont Llama 3 et 3.1 : ni GPT, ni Claude, ni Gemini, ni les Llama plus récents.
- Les tokens illimités se heurtent à des plafonds journaliers de requêtes sur tous les plans sous Max, et c'est donc le débit qui bloque, pas le token.
- Le paiement passe uniquement par PayPal, ce qui exclut certaines cartes et comptes professionnels.
- Le support se résume à une adresse e-mail, sans page de statut, SLA ni historique public de disponibilité avant le plan Enterprise.
Questions fréquentes
Awan LLM est un fournisseur d'API qui sert des modèles Llama ouverts par abonnement mensuel, et non à la consommation de tokens. Vous payez un plan, envoyez des requêtes de chat completion à son endpoint et générez autant de tokens que le contexte du modèle le permet dans la limite de vos requêtes.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Awan LLM.
Alternatives à Awan LLM

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.