
Cerebrium
Cerebrium · Programmation
Cerebrium est une plateforme GPU sans serveur pour lancer des apps d'IA en temps réel dans le cloud. Elle facture le calcul à la seconde et déploie dans plusieurs régions.
À propos de Cerebrium
What Is Cerebrium
Cerebrium est une infrastructure pour les charges d'IA qui doivent répondre vite. Vous empaquetez du code Python dans un conteneur, vous le déployez, et Cerebrium en fait un endpoint qui monte en charge tout seul. La plateforme fait tourner des CPU et des GPU NVIDIA, et vise les tâches où le démarrage à froid et la latence décident si un produit fonctionne : agents vocaux, sortie de modèle en streaming et inférence à fort trafic.
La vitesse tient à deux choses. Les conteneurs démarrent en une à trois secondes, et un système appelé Content-Aware Storage ne tire que les fichiers dont une nouvelle instance a besoin, au lieu de toute l'image. Pour les tâches plus lourdes, le checkpointing de mémoire et de GPU prend un instantané du processus, si bien que le modèle saute les imports et la compilation CUDA au démarrage suivant. Cerebrium affirme que le checkpointing réduit nettement le démarrage à froid, et la fonction reste en bêta.
Le prix suit l'usage, pas les sièges. Vous payez à la seconde les vCPU, la mémoire et les GPU qu'une charge occupe pendant qu'elle tourne, si bien que la facturation à la seconde lie la dépense au travail réel. L'offre Hobby est gratuite pour commencer et facture le calcul en plus ; Standard ajoute 100 dollars par mois plus le calcul pour des sièges et des apps illimités. Les équipes qui veulent de la capacité réservée, des remises sur volume ou un coup de main en ingénierie ML passent à Enterprise. Le calcul tourne sur Google Cloud, AWS et Azure, et Cerebrium achemine le travail vers ce qui convient le mieux.
Getting Started
- Installez la CLI avec pip install cerebrium, ou utilisez Homebrew sur macOS et un paquet binaire sur Linux.
- Lancez cerebrium login, puis ouvrez le tableau de bord pour créer une clé API et repérer l'ID de votre projet.
- Lancez cerebrium init my-first-app pour créer un projet avec main.py et cerebrium.toml.
- Testez le code avec cerebrium run main.py::run, puis publiez-le avec cerebrium deploy.
- Appelez l'endpoint déployé sur son URL api.cerebrium.ai, ou configurez un domaine personnalisé.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Cerebrium.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs IA qui publient des API d'inférence
- Équipes à trafic irrégulier
- Créateurs d'apps vocales et de streaming
- Entreprises avec des règles de résidence des données
Tâches
- Servir des modèles ouverts
- Générer des images et de la vidéo
- Transcrire de longs audios
- Construire des agents vocaux en temps réel
- Exécuter des embeddings et du reranking
Cas d'usage
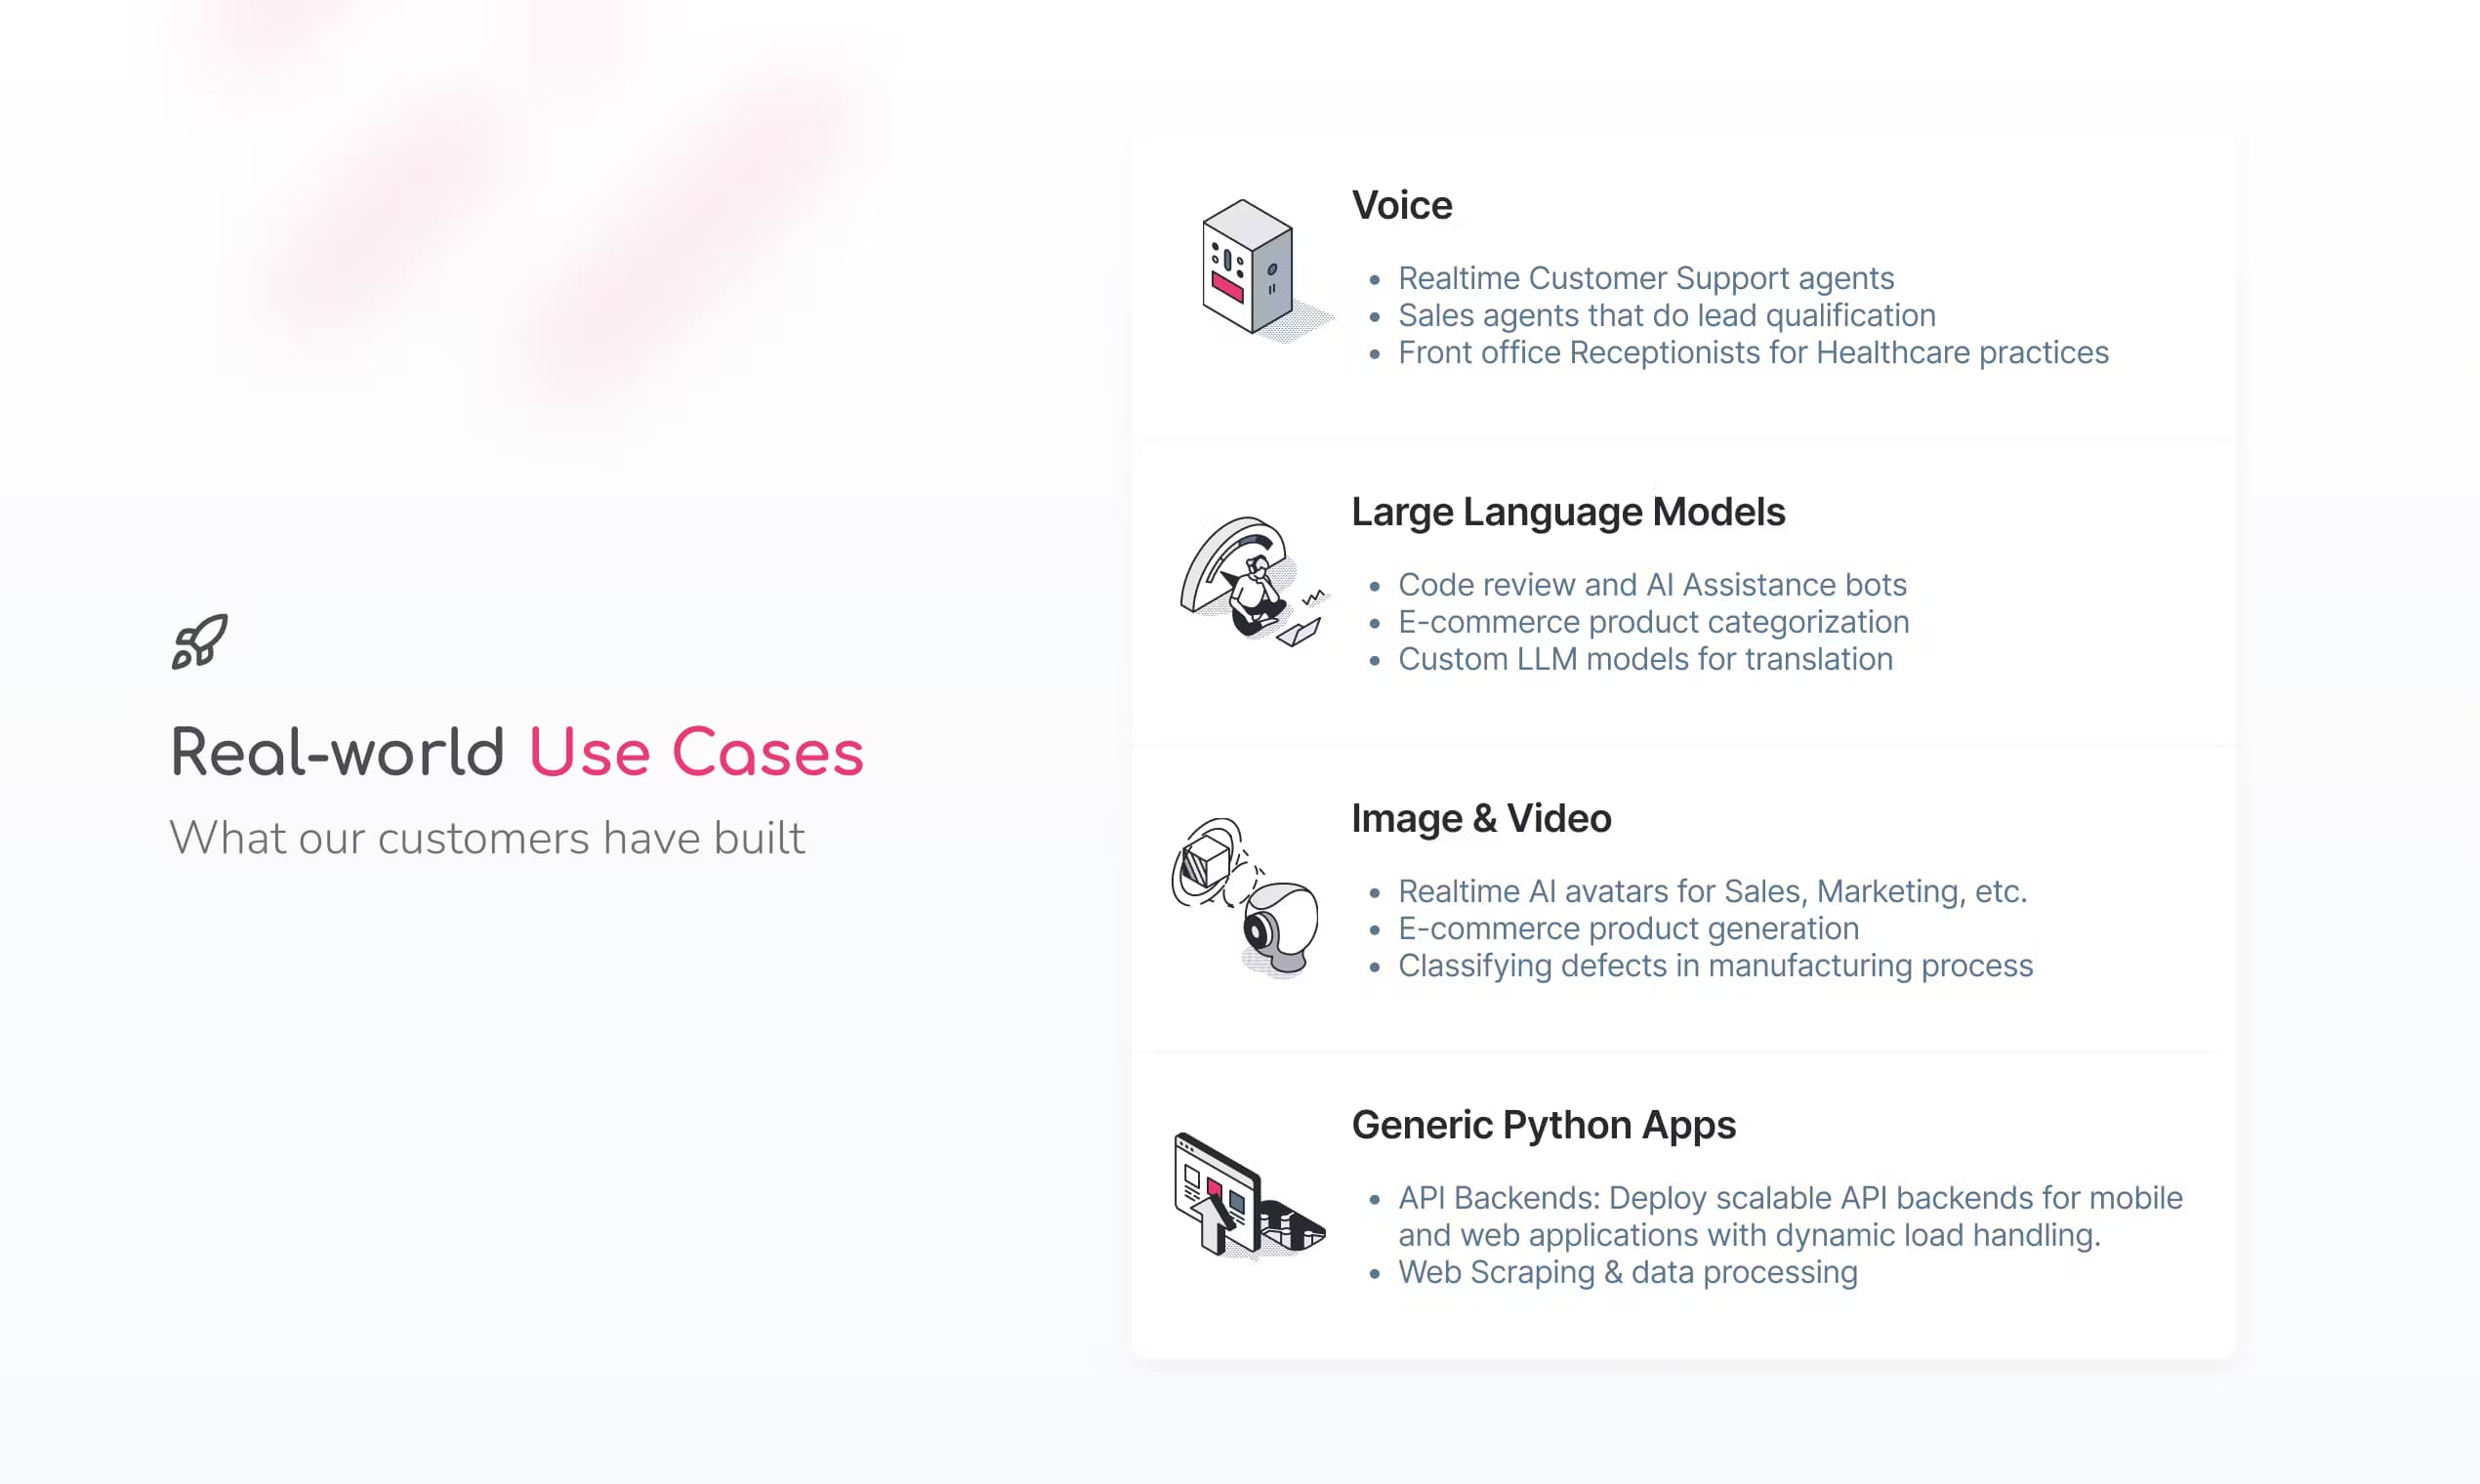
- Un bot de support téléphonique qui répond pendant que la personne parle encore
- Un pic de trafic le jour du lancement
- Un lot nocturne de transcriptions
- Une app mondiale avec des utilisateurs dans plusieurs régions
Fonctionnalités clés
Démarrage de conteneur en moins d'une seconde
Cerebrium lance des conteneurs en une à trois secondes, en combinant Content-Aware Storage, qui ne tire que les fichiers nécessaires, et le checkpointing de mémoire et de GPU qui saute les imports, le chargement de modèle et la compilation CUDA. Le démarrage rapide compte surtout pour les apps en temps réel, où une première requête lente passe pour un produit cassé.
GPU et CPU sans serveur
Vous réglez le type et le nombre de GPU, les cœurs vCPU et la mémoire dans cerebrium.toml, en choisissant des cartes NVIDIA comme H100, A100 et L40s. Les instances suivent le trafic, donc une heure calme coûte peu et une heure chargée ne s'emballe pas. Vous payez à la seconde uniquement les ressources allouées.
Déploiement multi-région
Un même déploiement peut tourner dans plusieurs régions pour réduire la latence et gagner en disponibilité, ou rester fixé à une seule pour la résidence des données. Cerebrium tourne sur Google Cloud, AWS et Azure, et annonce 99,999 % de disponibilité avec un basculement qui redirige le trafic quand une région tombe.
Types d'endpoint flexibles
Les apps peuvent servir une API REST, un endpoint de streaming en server-sent events, un WebSocket pour l'audio bidirectionnel, ou n'importe quel serveur web compatible ASGI. Cette gamme laisse une seule plateforme héberger aussi bien un simple appel JSON qu'une session vocale en direct.
Mise à l'échelle automatique et batching
Vous configurez les réplicas, les métriques de mise à l'échelle et les paliers de calcul, puis vous réglez la concurrence et le batching pour le trafic réel. Le batching natif sous vLLM ou LitServe augmente le débit du GPU, ce qui baisse le coût de chaque requête sous charge.
Stockage persistant
Les volumes gardent les poids de modèle et les fichiers entre les déploiements, avec des commandes d'envoi, de téléchargement et de liste dans la CLI, et un redimensionnement par projet jusqu'à 1TB. Les poids persistent entre les lancements, donc les conteneurs ne les retéléchargent pas à chaque démarrage.
Sécurité et isolation
Chaque charge tourne sur gVisor dans un bac à sable durci, ce qui donne une isolation de conteneur solide sans gros coût de performance. La plateforme répond à SOC 2, HIPAA, RGPD et ISO, et les secrets sont chiffrés puis exposés comme variables d'environnement.
CI/CD et intégration GitHub
Les apps peuvent être liées à un dépôt GitHub pour qu'un push ou un merge déclenche un déploiement, via des clés de compte de service dans un pipeline. Les réglages de déploiement progressif déplacent le trafic entre les révisions sur une fenêtre définie, ce qui réduit le risque d'une mauvaise version en production.
Avantages et inconvénients
Avantages
- Les premières requêtes arrivent en une à trois secondes, donc les apps vocales et en temps réel ne calent pas au démarrage.
- La facturation à la seconde sur GPU, CPU et mémoire garde le coût lié au travail réel, et rend l'infrastructure d'inférence IA abordable.
- Une offre Hobby gratuite et un palier Standard à 100 dollars facilitent l'essai et les petites apps.
- Le déploiement multi-région et la couverture de conformité conviennent aux équipes mondiales ou aux données réglementées.
- La prise en charge de REST, du streaming, des WebSockets et de serveurs Docker ou ASGI maison colle à de nombreuses piles.
Inconvénients
- Le checkpointing de mémoire et de GPU est encore en bêta, donc les plus gros gains de démarrage ne sont pas encore figés.
- La page de tarifs ne liste pas de tarifs fixes par GPU, donc vous estimez le coût avec un calculateur ou un devis.
- Les crédits AWS et GCP ne s'appliquent pas, ce qui surprend les équipes déjà engagées sur ces clouds.
- La capacité GPU garantie exige une dépense mensuelle minimale, ce qui l'exclut pour les petits projets.
Questions fréquentes
Cerebrium est une plateforme GPU sans serveur pour les charges d'IA en temps réel et à haute performance. Vous déployez un conteneur et il devient un endpoint qui monte en charge sur CPU ou GPU NVIDIA, facturé à la seconde.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Cerebrium.
Alternatives à Cerebrium

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.