
Cirrascale Cloud Services
Cirrascale Cloud Services (Cirrascale Corporation) · Programmation
Cirrascale Cloud Services est un cloud privé d'IA qui loue des serveurs GPU dédiés, d'une carte Qualcomm à huit NVIDIA B200, sur un forfait mensuel fixe et sans frais de transfert de données.
À propos de Cirrascale Cloud Services
About
Qu'est-ce que Cirrascale Cloud Services
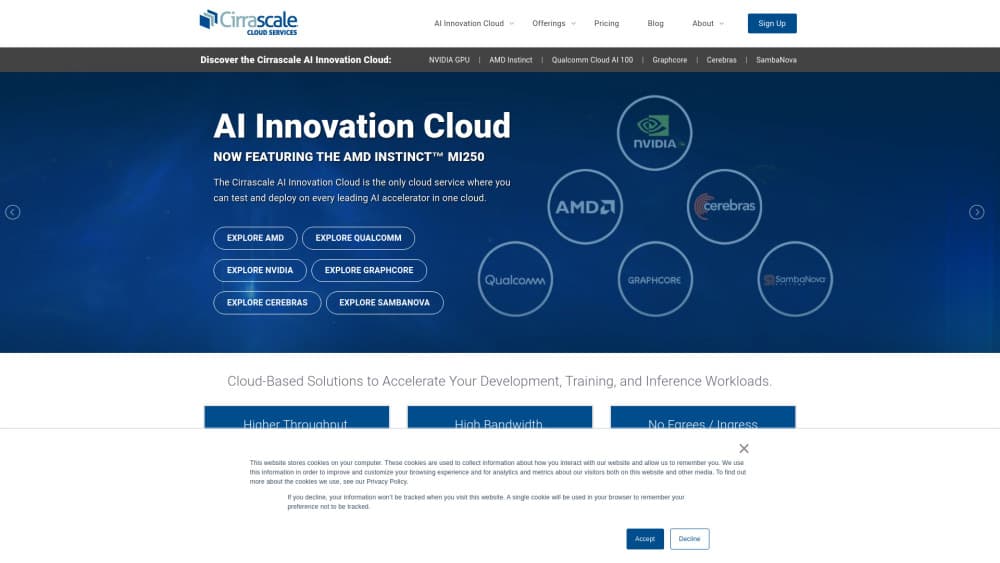
Cirrascale Cloud Services vend de la capacité d'accélérateur dédiée aux équipes qui ont besoin d'une infrastructure d'entraînement IA, d'un affinage de modèle ou d'un service d'inférence sans acheter de matériel. C'est la branche cloud de Cirrascale Corporation, une société qui a construit pendant des années des systèmes multiGPU en lame et en baie avant de les louer au mois.
L'argument, c'est le contrôle. Vous louez un serveur entier avec un accès root, pas une part de machine partagée, et le catalogue couvre NVIDIA, AMD, Qualcomm et Tenstorrent. Cela compte quand un projet dépend de la chaîne d'outils d'un fabricant ou quand l'acheteur veut de la marge pour négocier le prix.
Le revers, c'est l'engagement. Cirrascale ne vend pas de temps GPU à l'heure, donc la machine se loue un mois minimum. Une équipe qui veut tester quelque chose pendant deux heures doit regarder du côté des clouds facturés à la minute.
La société exploite aussi une activité d'inférence : une plateforme d'inférence IA managée, un point de terminaison Gemini privé sur Google Distributed Cloud et des points de terminaison hébergés pour les modèles ouverts d'Ai2. Le secteur public y accède via les services Google GPAR.
Pour démarrer
- Envoyez une demande via le formulaire Get Started ou parlez au service commercial en précisant la taille du modèle, le framework et l'échéance visée.
- Choisissez l'accélérateur et la durée. Les tarifs sont publiés par serveur pour un, trois, six et douze mois.
- Validez le devis et terminez l'onboarding, y compris la revue de sécurité exigée par votre organisation.
- Provisionnez l'instance, rattachez du stockage NVMe ou objet et connectez le réseau ou InfiniBand si le travail est en cluster.
- Amenez votre charge d'entraînement ou d'inférence sur la machine et gérez-la avec votre propre stack, ou confiez l'exploitation à l'équipe de services managés.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Cirrascale Cloud Services.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les équipes de machine learning avec une feuille de route de plusieurs mois
- Les startups qui ont besoin de huit GPU haut de gamme sans acheter de matériel
- Les entreprises soumises à des règles de résidence des données
- Les équipes d'inférence à trafic régulier
Tâches
- Pré-entraînement et affinage de grands modèles
- Service de modèles et pipelines de récupération
- Tests de portabilité entre frameworks
- Déploiements d'inférence encadrés
Cas d'usage
- Un laboratoire qui a besoin de 16 nœuds H100 ou plus pendant deux mois et veut le cluster prêt sans le construire.
- Une société de vision par ordinateur qui stocke des millions de petits fichiers image et sature le stockage d'un cloud généraliste.
- Une équipe qui compare les tarifs cloud GPU entre fournisseurs avant de signer un contrat annuel de capacité.
Fonctionnalités clés
Des serveurs GPU dédiés chez quatre fabricants
Chaque instance est un serveur GPU dédié, pas une part virtuelle, et le catalogue va de 8x NVIDIA RTX A4000 en bas de gamme à 8x NVIDIA B200, 8x AMD MI300X dans le cloud et des configurations Qualcomm Cloud AI 100. Vous prenez le silicium qui colle à votre framework au lieu de plier la charge à un seul fournisseur. Les nœuds Tenstorrent Galaxy complètent la liste pour ceux qui testent des accélérateurs non GPU.
Un réseau cluster pour l'entraînement multi-nœuds
Toute location de NVIDIA H100 commence par un serveur seul avec un réseau bondé à 25Gb, et les configurations H100 en cluster passent à InfiniBand 3200Gb, avec jusqu'à 3200Gb de bande passante disponible. Cirrascale annonce la capacité H100 en cluster à partir de $2.49 par heure GPU sur des déploiements de 16 nœuds et plus. C'est là que se joue la fin d'un entraînement de 70 milliards de paramètres en quelques semaines ou son blocage sur l'interconnexion.
Une facturation mensuelle fixe sans frais de trafic
Les tarifs cloud GPU sont ici par serveur et par mois, avec des durées de trois, six et douze mois qui font baisser le taux effectif. Aucun frais d'entrée ni de sortie n'est facturé, ce qui change les calculs pour qui déplace des jeux de données de plusieurs téraoctets ou sert des sorties lourdes. Cirrascale appelle ce modèle No Surprises billing et affirme l'absence de frais cachés.
Gemini privé et points de terminaison d'inférence managés
La plateforme d'inférence IA réunit des points de terminaison hébergés pour modèles ouverts, un cloud d'inférence Qualcomm et des points de terminaison pour les modèles Ai2. Le point de terminaison Gemini privé tourne sur Google Distributed Cloud et figure sur Google Cloud Marketplace, donc une agence publique utilise un modèle Gemini managé sans faire sortir prompts et réponses de son infrastructure.
Un stockage en couches, du NVMe à l'objet
Le stockage NVMe de couche chaude est facturé séparément du stockage objet, et le tarif objet baisse au-delà de 50TB, de 2PB et des paliers supérieurs. La couche vise les jeux d'entraînement composés de millions de petits fichiers, exactement là où les configurations objet génériques lâchent. Derrière, on trouve du matériel Dell et le système de fichiers parallèle de Weka.
Des services managés pour les équipes sans pôle plateforme
Cirrascale propose des services professionnels et managés orientés zéro DevOps, de sorte qu'une équipe de data science peut déléguer le provisionnement, la supervision et la maintenance du cluster. Pour un groupe sans ingénieur infrastructure dédié, cela réduit l'écart entre louer un serveur et faire tourner des entraînements dessus.
Avantages et inconvénients
Avantages
- Le prix par serveur rend le budget IA prévisible sur plusieurs mois, et les durées longues font baisser le tarif par GPU.
- L'absence de frais d'entrée et de sortie supprime un coût qui grimpe en silence sur d'autres clouds GPU quand les jeux de données grossissent.
- Le catalogue d'accélérateurs couvre NVIDIA, AMD, Qualcomm et Tenstorrent, ce qui donne une vraie marge de négociation.
- Le H100 en cluster avec InfiniBand descend à $2.49 par heure GPU à partir de 16 nœuds, compétitif pour les gros entraînements.
- Le statut de Platinum Partner Dell et le stockage Weka adossent le matériel à des fournisseurs vérifiables.
Inconvénients
- Aucune facturation à l'heure ni à la seconde, donc un test court coûte un mois entier de serveur.
- L'onboarding passe par le service commercial, vous ne montez pas un nœud avec une carte bancaire en cinq minutes.
- Sans offre gratuite ni essai, évaluer la plateforme demande un engagement payant.
- Les prix publiés sont par serveur, donc la comparaison avec des clouds à l'heure exige un calcul manuel.
Questions fréquentes
Le service fournit des serveurs GPU et accélérateurs dédiés pour l'entraînement, l'affinage et l'inférence IA, plus des points de terminaison d'inférence managés. Vous louez la machine entière un mois ou plus et faites tourner votre propre stack dessus.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Cirrascale Cloud Services.
Alternatives à Cirrascale Cloud Services

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.